Herramientas de desarrollo · Comparación de texto
Cómo una diferenciación de texto encuentra líneas modificadas: LCS y el algoritmo de Myers
· Cómo funciona
diferencia de texto algoritmos flujo de trabajo del desarrollador
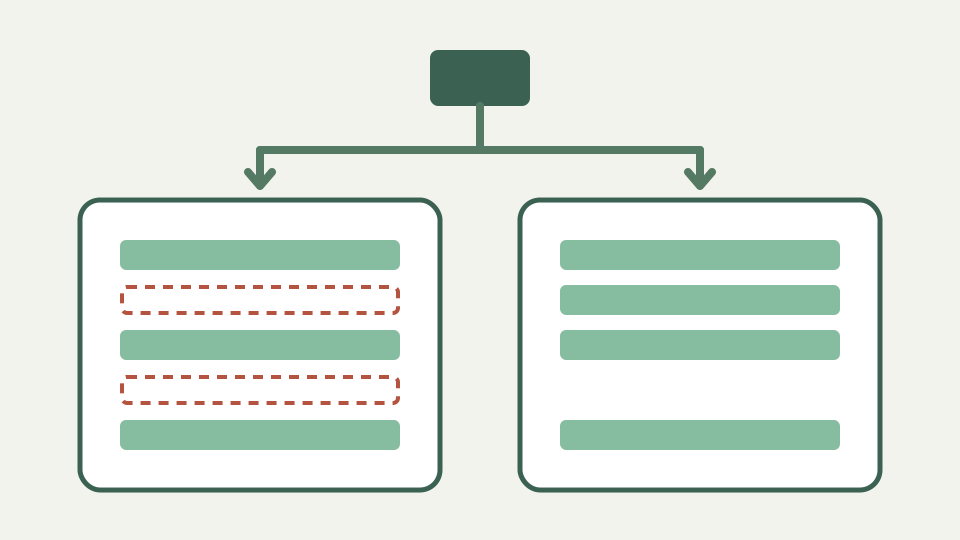
Explica la idea de subsecuencia común más larga detrás de la comparación basada en líneas y por qué el algoritmo de Myers la hizo lo suficientemente rápida como para ejecutarse instantáneamente, incluso dentro de una pestaña del navegador.
Dos archivos, una pregunta: ¿qué líneas sobrevivieron? — comparación de cuadros para encontrar el recorrido más largo de líneas comunes a ambas versiones en lugar de coincidir con números de línea
Dos revisiones no llegan con etiquetas que indiquen qué líneas sobrevivieron. ToolAcre primero divide cada texto en una lista ordenada, luego busca una subsecuencia larga que aparece en ambas listas en el mismo orden. Las líneas fuera de esa columna vertebral compartida se convierten en adiciones o eliminaciones en lugar de modificaciones supuestas.
El resultado incluye posiciones originales de base única para ambos lados. Una fila sin cambios posee un número en cada lado, una eliminación solo en el izquierdo y una suma solo en el derecho. Esa contabilidad hace que la historia mostrada sea revisable incluso cuando las líneas repetidas dan más de una alineación plausible.
Por qué la diferenciación funciona en líneas, no en caracteres: cómo la división en nuevas líneas convierte un texto en una secuencia de unidades comparables y por qué eso hace que la prosa se comporte de manera diferente al código
La implementación trata una línea completa como su unidad de comparación. Por lo tanto, los límites de nueva línea dan forma al resultado: una edición de una palabra dentro de un párrafo almacenado en una línea reemplaza esa línea completa, mientras que la misma prosa organizada oración por oración puede aislar una región mucho más pequeña.
La comparación de líneas no es un análisis de caracteres oculto detrás de una pantalla diferente. `splitLines` crea matrices y la tabla LCS compara una clave de línea con otra. Esta granularidad predecible se adapta a los archivos fuente y de configuración, pero no puede resaltar las letras exactas cambiadas dentro de un reemplazo de apariencia coincidente.
Subsecuencia común más larga en términos sencillos: recorre la idea LCS en un ejemplo de cinco líneas y muestra cómo todo lo que está fuera de la subsecuencia se convierte en una inserción o eliminación.
Imagine las líneas izquierdas A, B, C, D, E y las líneas derechas A, C, E. A, C y E forman una subsecuencia común ordenada. B y D quedan fuera de él, por lo que el resultado informa dos eliminaciones y tres filas sin cambios sin necesidad de emparejar ninguna de las líneas eliminadas con un reemplazo.
La tabla registra, para cada par de posiciones restantes, la mejor longitud compartida disponible a partir de ahí. La reconstrucción avanza a través de esos valores. Las teclas iguales avanzan en ambos lados; de lo contrario, el valor vecino mayor decide si se emite una eliminación por la izquierda o una adición por la derecha.
El algoritmo de Myers y por qué la velocidad es importante: explica, sin fórmulas, cómo rastrear el script de edición más corto mantiene la comparación rápida en archivos con miles de líneas.
El libro nombra Myers, pero `diff.js` implementa explícitamente programación dinámica de subsecuencia común más larga. Su comentario indica tiempo O(n·m) y memoria para el medio diferente. Reclamar el comportamiento de Myers o del gráfico de edición más corto sustituiría el código que realmente se envía por un algoritmo familiar.
ToolAcre limita ese costo antes de la asignación. Los prefijos y sufijos iguales se eliminan en pasadas lineales y cualquiera de los dos medios diferentes puede contener como máximo 2,000 líneas. La matriz es `Uint32Array`; el peor cuadrado permitido documentado ocupa alrededor de dieciséis megabytes en lugar de valores encuadrados ilimitados.
ToolAcre utiliza una tabla LCS, no el algoritmo de Myers mencionado en el esquema
Compare un registro de cambios que contiene "Búsqueda agregada", "Exportación fija" y "Ayuda actualizada" con una revisión que mantiene la primera y tercera entrada pero inserta "Filtros agregados" antes de la última. Las entradas comunes anclan la ruta, se elimina "Exportación fija" y se agrega "Filtros agregados".
El algoritmo no llama a ese par una línea modificada. Su vocabulario de filas es sólo igual, agregar y eliminar, por lo que un reemplazo textual aparece como una eliminación seguida de una adición. El resumen cuenta esas operaciones por separado y marca los textos como idénticos sólo cuando ambos recuentos son cero.
Por qué dos diferencias correctas pueden verse diferentes: muestra cómo los vínculos entre scripts de edición igualmente cortos explican por qué una herramienta culpa a una línea en blanco y otra culpa a un corchete de cierre
Las líneas repetidas o intercambiables pueden producir varias subsecuencias comunes de la misma longitud. ToolAcre resuelve un empate prefiriendo una eliminación cuando los dos valores de la tabla vecina son iguales. Otra implementación correcta puede elegir una adición primero y presentar una alineación de apariencia diferente con el mismo costo de edición.
Es por eso que una línea en blanco o una llave de cierre puede aparecer adjunta a un fragmento diferente en todas las herramientas. La discrepancia no significa automáticamente que ninguna de las comparaciones pierda contenido. Lea los números de línea originales y las filas circundantes sin cambios antes de tratar las diferencias de presentación como afirmaciones fácticas en competencia.
Lo que esto no cubre: la comparación semántica o estructural, la detección de movimientos y el resaltado a nivel de palabra están fuera de lo que calcula una diferenciación basada en líneas.
Nada en esta ruta analiza árboles de sintaxis, reconoce identificadores renombrados, etiqueta bloques movidos o comprende el significado en prosa. Un párrafo movido viola el requisito de orden compartido y puede aparecer una vez como eliminado y una vez como agregado. La herramienta tampoco calcula los resaltados a nivel de caracteres o palabras dentro de las filas.
Esas omisiones son límites, no modos ocultos. Utilice un revisor que tenga en cuenta el idioma para las afirmaciones semánticas y el control de versiones para el historial de fusiones. Text diff responde a la pregunta más específica de en qué se diferencian dos secuencias de líneas ordenadas y luego permite al ser humano interpretar si esas ediciones textuales son importantes.
Conclusión: lo que realmente significan las líneas resaltadas: resume cómo leer una diferencia de línea como la historia más corta de las ediciones y cómo la comparación de texto de ToolAcre ejecuta esto en su pestaña sin cargar nada.
Lea las filas verde y roja como una explicación derivada de LCS, no como prueba de la intención del autor. El recorte de prefijos y sufijos cambia la cantidad de trabajo pero no la contabilidad de línea final. El texto original permanece en cada fila incluso cuando las opciones de mayúsculas y minúsculas o espacios en blanco proporcionan claves más flexibles para la coincidencia.
La comparación se ejecuta a través de módulos de navegador importados y se representa con nodos de texto DOM; no hay ningún punto final de conversión en la ruta de la herramienta. Pruebe un ejemplo de cinco líneas, intercambie los lados y descargue el resultado en forma de parche para ver cómo la dirección cambia las adiciones en eliminaciones sin inventar la semántica.