Інструменти розробника · UUID генератор
Випадковий UUID Основні ключі та B-Tree Fragmentation: Що дійсно Happens
· Чому це питання
Опубліковано ToolAcre · Редакція журналу
Увійти криптографія веб-сайт
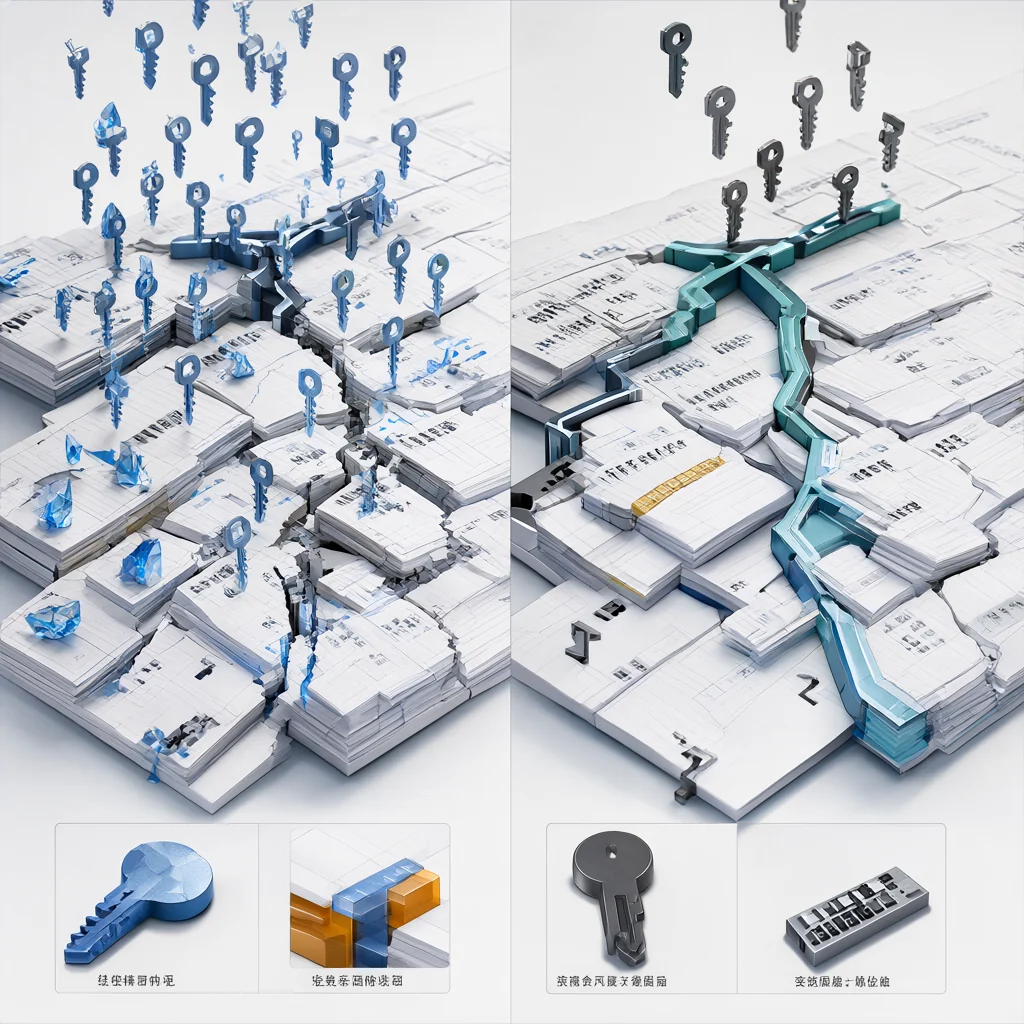
Випадкові v4 ключі в випадкові індексні сторінки, а кластерні індекси сплачуються за неї. Цей пост пояснює механізм, вартість зберігання текстових вершків бінарних, і де час замовлення UUIDs зміни картини.
Вставте повільний вигляд таблиці, який вирощує — симптом, який надішляє ДБА, що шукає свій вибір ключа
Вставляння ряду з випадковим UUID як основний ключ у базі даних з кластерним індексом викликає базу даних для вставки нового ряду в випадковому місці в рамках структури В. Основні ключі, які призводять до правої сторінки листків, зберігаючи всі вставки в межах невеликої, каси-резидентної зони. Випадкові ключі розсіювач вставки по всьому індексу, що робить базу даних для перевороту і модифікувати сторінки, що знаходяться далеко в фізичному зберіганні. Як виростає стіл і дерево глибоке, кожна вставка доторкається більше сторінок і викликає більше я/O операції. В рамках операції, що з'явилися дешеві на тисячрядках, набуває дорогого на мільйон. Це не теоретична проблема; вона проявляється як безглуздий деградація в вставці через.
Як скупштовані B-tree fills — послідовні ключі, які приділяються до останньої сторінки; випадкові ключі до сторінок по всьому індексу
Механізм є фундаментальним для того, як працює B-trees, оскільки вони підтримують сортування ключових замовлень у листових сторінках. Коли ви вставляєте ряд з ключем 10,001 в таблицю, яка вже зберігала ключі 1 через 10,000, бази даних знає, де цей рядок належить: в кінці, в існуючій правій сторінці, якщо є простір, або в новій сторінці, пристосовується праворуч. Коли вставляємо ряд з випадковим UUID як 7524fae2-7dec-11d0-a765-00a0c91e6bf6 в той же стіл, база повинна навігувати дерево, щоб знайти сторінку аркуша, що містить ключі в тому, що UUID діапазон, розташування точного положення в цій сторінці і вставляння ряду. Якщо ця сторінка повністю розбиває, пересувається навпіл її вміст на нову сторінку і оновлення материнської вершини.
Сторінка розщеплює і кеш-пам'ятка — чому випадкові витрати вставки більше I/O і чому ефект росте з розміром таблиці
Випадкові ключі створюють найгірший вставляючий візерунок, оскільки кожен вставляє землі на випадковому положенні в дерево замість пристосування на праву сторінку. База даних повинна шукати правильну сторінку, яка зазвичай коштує кілька сторінок, які читається - один за рівень дерева. Потім потрібно змінити цю сторінку, яка може викликати розкол, який пропагує дерево. Більше сторінок є модифікованими, більш докладними записами, а також буфером пам'яті заповнюється сторінками з різних регіонів дерева, а не тримаючи фокус на активному вставці точки. Цаше пропускає збільшення і я/O стає льодяником, з вставкою ставка пластина, як таблиця виростає до більших масштабів.
Текст або бінарний — 36-character рядки versus 16-байт рідної еуїди або бінарних (16) стовпчики і ефект на розмір індексу
Вартість не є рівномірною по всій базі даних, оскільки різні системи оптимізують управління сайтом по-різному. База даних з агресивною компресією, невеликими розмірами сторінок або безсмертною роботою може відображати менші відмінності продуктивності між послідовними та випадкових ключів. База даних з великими сторінками, механічні диски або суворі ліміти пам'яті покажуть драматичне деградація. Проблема спостережена і безцінна: вимірювати ставки вставки за 1,000 ряди, 100,000 ряди і 1,000,000 ряди. Якщо швидкість на секунду різко знижується на більших масштабах, ви відчуваєте карбонентське штраф з вашим специфічним обладнанням та налаштуванням бази даних.
Альтернативи часу — як UUIDv7 і ULID зберігати унікальність при вставці в кінці індексу
UUIDs як рядки споживати 36 символи у текстовій формі або 16 bytes як бінарний UUID тип залежно від обраного формату зберігання. А.А 36-character string в a UTF-8 або ASCII колонка 36 bytes, у порівнянні з 8 bytes для 64-місце ціле. Індекс на рядку-UUID стовпчик три рази більше, ніж індекс на цілому стовпці, що припустимо, не наносити компресійні методи. Більші індекси, що містять менші індексні сторінки, що підходять в буферному басейні, що означає менше кеш-пам'яті при перетворенні дерева. Довгий індекс, який підходить в RAM виконує краще, ніж великий індекс, який повинен прочитати з диска на кожному запиту, незалежно від вставки замовлення або шаблонів робочого навантаження.
У роботі прикладу — однаковий робочий навантаження, описаний для випадкових клавіш і часового замовлення, якісно, без винайдених бендиктів
Відмінність зберігання значно відрізняється як для первинних, так і вторинних індексів, оскільки кожен вторинний індекс, який включає в себе основний ключ, повинен зберігати повну 36-чарівник UUID або 16-бунейджери UUID значення. Це робить вторинні індекси значно більшими, ніж індекси, використовуючи ціле ключ для основних ключових пошуків. Відстеження, резервні копії та результат запиту встановлює всі пропорційно з більшим розміром індексу. Мистецтво ToolAcre UUID генератор виробляє бінарні значення; зберігають їх як бінарні (16) або GUID типи залежно від бази даних економить простір порівняно з варchar(36) і покращує ефективність кешу на борту. Ця оптимізація зберігання є критичною для масштабних систем.
Що це не криється — застібка-організованих таблиць і баз даних, де основний ключ не кластерований, де ефект менший
Поширена оптимізація - зберігати UUID як бінарний внутрішньо і відображати його як рядок тільки при необхідності для API або інтерфейсів користувача. Індекс і приєднатися роботи на компактній бінарній формі API відповідність або код програми перетворюється на рядок представлення. Деякі бази даних пропонують вбудовані GUID або UUID типи, які автоматично керують перетворенням. Інші вимагають відкладень. Відмінність продуктивності між 36-завтра і 16-відкриті стовпчики реально: стіл з мільйонами рядків і 36-завтра versus 16-бага UUID ключ стовпа відрізняється по 20 MB за рівнем індексу, що може бути різним між індексною фітингою в кеші L3 і вимагає від фіксатора пам'яті.
Потрібні: ви знаєте, що ваш індекс перед тим, як вибрати версію — це ToolAcre генератор виробляє випадкові UUIDs; використовувати повідомлення, щоб вирішити, чи підходить ваш двигун зберігання
Зняття між вставкою, розмірами індексу та характеристиками запиту вимагає архітектурних рішень на основі шаблонів робочого навантаження. У випадку, якщо рядки є загартованими, наприклад, часові рядки, але споживати однаковий простір, як випадкові UUIDs і протікання часової інформації. Пожертвувати UUID є послідовно очищувачем і не має часової компоненти для витоку, але повільніше вставляти в кластерний індекс і більший в загальний обсяг зберігання. Додаткові альтернативи UUIDv7 об'єднують переваги, зберігаючи локалізацію вставки, уникаючи часових витоків у версії 4 випадкові ідентифікатори.