Entwicklertools · UUID Generator
Von 128 Bits zu 36 Zeichen: So funktioniert die UUID Textkodierung
· Wie es funktioniert
UUID Kryptographie Browser-APIs
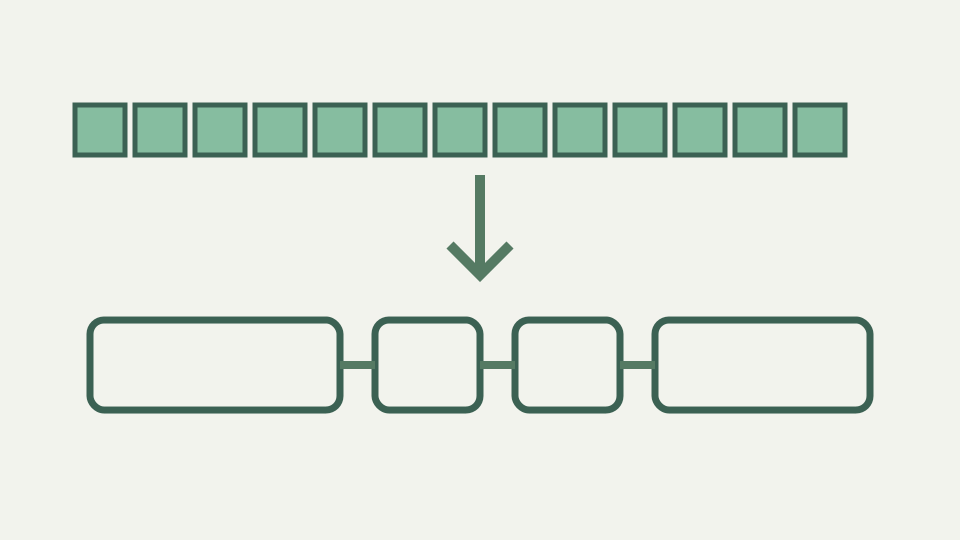
Ein UUID besteht aus 16 Bytes, die bekannte Form besteht jedoch aus 36 Zeichen. In diesem Beitrag werden die hexadezimale Verdoppelung, die Bindestriche, die Groß-/Kleinschreibung und die kürzeren Kodierungen erläutert, die verwendet werden, wenn die Standardform zu lang ist.
Warum die Spalte breiter als der Wert ist – der 16-Byte-Wert, der 36 Zeichen im Text kostet und was das für URLs und Speicher bedeutet
Die Speicherspaltenbreite explodiert, wenn Sie ein UUID-Format wählen. Ein 128-Bit-Wert besteht aus 16 Bytes, aber seine Textdarstellung hängt von der Kodierung ab: hexadezimal (36 Zeichen mit Bindestrichen, 32 ohne), base64url (22 Zeichen), base58 (22–23 Zeichen), Crockford base32 (26 Zeichen). Wenn Ihr Schema UUIDs als VARCHAR(36) speichert, geben Sie in jeder Zeile 36 Zeichen aus. In einer Tabelle mit 1 Milliarden Zeilen und keinen anderen Spalten sind das 36 Gigabyte Textaufwand im Vergleich zu 16 Gigabyte Binärdaten. Die Wahl ist nicht nur kosmetischer Natur; Dies wirkt sich auf die Abfragegröße, Netzwerk-Roundtrips und den Cache-Druck aus. Das kanonische Format ist 36 Zeichen: acht Hexadezimalziffern, Bindestrich, vier Hexadezimalziffern, Bindestrich, vier Hexadezimalziffern, Bindestrich, vier Hexadezimalziffern, Bindestrich, zwölf Hexadezimalziffern.
Hex verdoppelt alles – jedes Byte wird zu zwei Zeichen und vier Bindestriche vervollständigen den 36
Jedes Byte wird zu genau zwei hexadezimalen Zeichen (0–9, a–f). Die Bindestriche sind aus Gründen der Lesbarkeit und aus Gründen des Legacy vorhanden, seit UUIDs zum ersten Mal angegeben wurden. Die hexadezimale Kodierung verdoppelt die Byteanzahl: 16 Bytes werden zu 32 Hexadezimalziffern plus 4 Bindestriche. Es ist die langsamste und längste Kodierung, aber für Menschen lesbar und wird überall unterstützt. Groß-/Kleinschreibung: RFC 9562 schreibt Kleinbuchstaben für die kanonische Ausgabe vor, bei der Eingabe wird die Groß-/Kleinschreibung jedoch nicht beachtet. Durch das Speichern von Großbuchstaben wird die Gelegenheit zur Normalisierung verschwendet. Speichern Sie daher Kleinbuchstaben und vergleichen Sie die Eingabe ohne Berücksichtigung der Groß- und Kleinschreibung. Die Base64url-Kodierung stellt drei Bytes als vier Zeichen unter Verwendung eines 64-Zeichenalphabets dar (A–Z, a–z, 0–9, Minus, Unterstrich). Sechzehn Bytes werden zu 21 Zeichen plus einem Füllzeichen, also insgesamt 22 Zeichen. Base64url entfernt die Auffüllung und die Standardzeichen (Plus und Schrägstrich), die in URLs reserviert sind.
Fallregeln – Kleinschreibung bei der Ausgabe, Berücksichtigung der Groß-/Kleinschreibung bei der Eingabe und warum Vergleiche mit gemischter Groß-/Kleinschreibung stille Nichtübereinstimmungen verursachen
Ein UUID im Base64URL-Format spart 14 Zeichen im Vergleich zu Hex und ist in URLs ohne Prozentkodierung gültig. Der Nachteil: Es ist weniger lesbar (Kleinbuchstaben sehen aus wie Ziffern; b, 8, B und 8 sind leicht zu verwechseln). Base58 wird von Bitcoin und anderen Blockchains verwendet und entfernt mehrdeutige Zeichen (0, O, I, l), sodass das Ergebnis 22–23 Zeichen ist und dennoch lesbar bleibt. Crockford base32 (entwickelt für Prüfsummen-ISBN-ähnliche Formate) verwendet 26 Zeichen und gibt der Korrektheit Vorrang vor der Kürze. Der Microsoft GUID-Bytereihenfolge-Trap gilt für den UUID-Speicher in einigen Datenbanken. RFC 9562 gibt die Netzwerk-Byte-Reihenfolge (Big-Endian) für alle Bytes an. Einige Microsoft SQL Server-Konfigurationen speichern GUIDs mit Little-Endian-Bytereihenfolge in den ersten drei Feldern.
Kürzere Codierungen – base64url mit 22 Zeichen, base58 und Crockford base32, mit ihren Kompromissen in Bezug auf Lesbarkeit und Sicherheit beim Kopieren und Einfügen
Der gleiche 128-Bit-Wert, der in Big-Endian und Little-Endian gespeichert ist, erzeugt unterschiedliche Hex-Strings. Ein als Microsoft GUID gespeicherter UUID 550e8400-e29b-41d4-a716-446655440000 kann als 00840e55-9be2-d441-a716-446655440000 (Bytes 0–3) abgerufen werden. und 4–5 und 6–7 umgekehrt). Wenn Ihr System eine Brücke zwischen RFC-kompatiblen und Microsoft-Systemen schlägt, müssen Sie sich dessen bewusst sein und entweder an der Grenze normalisieren oder dokumentieren, welches Format Sie in jeder Spalte verwenden. Bearbeitetes Beispiel: Die Version 4 UUID 9b2e4f1a-4f3e-4c1a-8a7d-1b2c3d4e5f60 im Hexadezimalformat belegt 36 Zeichen. Als 16 Bytes ist es 9b 2e 4f 1a 4f 3e 4c 1a 8a 7d 1b 2c 3d 4e 5f 60. In base64url: in Drei-Byte-Blöcke aufteilen, in Base64 konvertieren, Auffüllung entfernen: my5PGk8-TBqKfRssPTRPX2A. Im Hexadezimalformat ohne Bindestriche: 9b2e4f1a4f3e4c1a8a7d1b2c3d4e5f60 (32 Zeichen).
Die Microsoft-Byte-Reihenfolge-Falle – wie die ersten drei Felder einer GUID im Little-Endian-Verfahren gespeichert werden, sodass dieselben Bytes als zwei verschiedene Zeichenfolgen gedruckt werden können
Base64url spart 14 Zeichen; base58 würde ungefähr das Gleiche sparen; Hexadezimal ist der Standard. Wählen Sie basierend auf Ihrem Anwendungsfall: Wenn die Kennung in URLs vorkommt und jedes Zeichen wichtig ist, verwenden Sie base64url; Wenn es in Protokollen und Benutzeroberflächen erscheint, in denen Menschen es lesen, verwenden Sie die hexadezimale kanonische Form. Wenn Sie ein Blockchain-System oder ein verteiltes System aufbauen, bei dem es auf die Prüfsumme ankommt, verwenden Sie base58 oder Crockford base32. Speichern Sie bei der Auswahl eines Spaltentyps den Wert, der für Ihr tatsächliches Zugriffsmuster optimal ist. Wenn Sie UUIDs häufig abfragen und einen Abgleich ohne Berücksichtigung der Groß- und Kleinschreibung benötigen, speichern Sie Binary(16) und überlassen Sie die Darstellung der Datenbank. Wenn Sie nach Teilzeichenfolgen abfragen (nach UUIDs suchen, die mit einem Präfix beginnen), ist Hexadezimal in der Debug-Ausgabe besser lesbar.
Arbeitsbeispiel – ein Bezeichner, geschrieben als Bytes, kanonischer Hexadezimalwert und eine verkürzte Form, die jeden Konvertierungsschritt zeigt
Wenn Sie nach CSV exportieren und E-Mails an technisch nicht versierte Benutzer senden, ist Hexadezimal besser erkennbar. Wenn Ihr Speicherplatz begrenzt ist (mobile App mit lokalem Cache), spart base64url oder base58 Bandbreite. Der ToolAcre-Generator gibt das kanonische 36-Zeichen-Hexadezimalformat aus; Wenn Sie eine andere Codierung benötigen, funktioniert die wohlgeformte Prüfung weiterhin, da sie alle gültigen Darstellungen normalisiert, bevor das Format überprüft wird. Beim Kodieren oder Dekodieren von Millionen von UUIDs spielen Leistungsaspekte eine Rolle. Die hexadezimale Kodierung ist einfach: Konvertieren Sie jedes Byte in O(1) Zeit pro Byte in zwei Zeichen. Die Dekodierung ist ebenso einfach. Base64-Kodierung und -Dekodierung verwenden Nachschlagetabellen und sind etwas langsamer (ungefähr 2–3x langsamer als Hex pro Byte, abhängig von Hardware und Implementierung). Base58 ist deutlich langsamer, da es sich im Wesentlichen um eine Basiskonvertierung handelt und modulare Arithmetik erfordert.
Was dies nicht abdeckt – Datenbankspaltenoptionen wie native UUID-Typen im Vergleich zu Binärdateien (16), die separat behandelt werden
Wenn Ihr System UUIDs in einer Hot-Loop (Hochfrequenz-ID-Generierung, Massenexport) kodiert oder dekodiert, ist Hexadezimal schneller. Wenn die Codierung selten vorkommt und die Einsparung von 14-Zeichen von Bedeutung ist, ist base64url ein vernünftiger Kompromiss. Der ToolAcre-Generator gibt Hex aus, sodass Sie einen Leistungsvorteil erzielen, ohne die Kompatibilität zu beeinträchtigen. Die Semantik des String-Vergleichs unterscheidet sich je nach Codierung. Hexadezimale UUIDs können als Zeichenfolgen verglichen werden: 550e8400-e29b-41d4-a716-446655440000 < 550e8400-e29b-41d4-a716-446655440001 (lexikografischer Vergleich funktioniert). Binäre UUIDs können als Bytes verglichen werden: Der Byte-für-Byte-Vergleich ist dasselbe wie der numerische Vergleich. Base64url- und base58-codierte UUIDs behalten jedoch beim lexikografischen Zeichenfolgenvergleich nicht die numerische Reihenfolge bei. Wenn Ihr System auf der lexikografischen Sortierung von UUIDs basiert (ein überraschend häufiges Muster zum Erstellen von Indizes oder Datenbankschlüsseln), müssen Sie entweder hexadezimal, binär oder eine sortierbare UUID-Variante (v6 oder v7) verwenden.
Takeaway: Behalten Sie die kanonische Form an den Grenzen bei – der ToolAcre-Generator gibt Standard-UUIDs mit 36-Zeichen aus und seine Prüfung akzeptiert Zeichenfolgen in dieser Form
Der ToolAcre-Generator erzeugt derzeit v4-UUIDs, die nicht nach der Codierungsreihenfolge sortiert werden können. Interoperabilität erfordert die Standardisierung einer einzigen Kodierung. Ein System, das UUIDs in Hex, Base64 und Base58 gleichzeitig akzeptiert, muss alle Eingaben vor der Verarbeitung in eine kanonische Form normalisieren. Dies ist möglich, erhöht jedoch die Komplexität. Externe APIs oder Datenbanken erfordern möglicherweise eine bestimmte Codierung: Einige APIs erwarten urn:uuid: mit dem Präfix Hex, andere erwarten Hex ohne Bindestrich, wieder andere erwarten base64url. Dokumentieren Sie die UUID-Codierungserwartungen Ihres Systems klar und deutlich in API-Verträgen. Der ToolAcre-Generator gibt immer kanonisches Hex aus; Wenn Sie andere Kodierungen benötigen, führen Sie die Konvertierung explizit durch und dokumentieren Sie die Kompromisse (Speicherplatz, Leistung, Lesbarkeit, Sortierbarkeit) gegenüber dem Team.