Ferramentas para desenvolvedores · Gerador UUID
De 128 Bits a 36 caracteres: como funciona a codificação de texto UUID
· Como funciona
uuid criptografia APIs do navegador
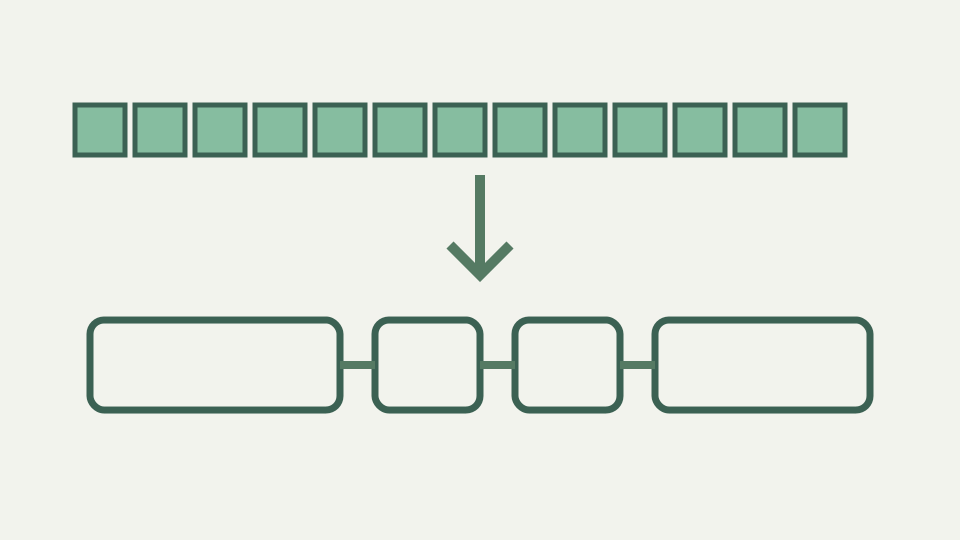
Um UUID é 16 bytes, mas sua forma familiar tem 36 caracteres. Esta postagem explica a duplicação hexadecimal, os hífens, as regras de caso e as codificações mais curtas que as pessoas usam quando o formulário padrão é muito longo.
Por que a coluna é mais larga que o valor — o valor de 16 bytes que custa 36 caracteres em texto e o que isso significa para URLs e armazenamento
A largura da coluna de armazenamento explode quando você escolhe um formato UUID. Um valor de 128 bits é 16 bytes, mas sua representação de texto depende da codificação: hexadecimal (36 caracteres com hífens, 32 sem), base64url (22 caracteres), base58 (22–23 caracteres), Crockford base32 (26 caracteres). Se o seu esquema armazena UUIDs como VARCHAR(36), você está gastando 36 caracteres em cada linha. Em uma tabela com 1 bilhões de linhas e nenhuma outra coluna, isso representa 36 gigabytes de sobrecarga de texto em comparação com 16 gigabytes de binário. A escolha não é apenas cosmética; afeta o tamanho da consulta, as viagens de ida e volta da rede e a pressão do cache. O formato canônico é de 36 caracteres: oito dígitos hexadecimais, hífen, quatro dígitos hexadecimais, hífen, quatro dígitos hexadecimais, hífen, quatro dígitos hexadecimais, hífen, doze dígitos hexadecimais.
Hex duplica tudo – cada byte se torna dois caracteres e quatro hífens completam o 36
Cada byte se torna exatamente dois caracteres hexadecimais (0–9, a–f). Os hífens existem por motivos de legibilidade e legado desde quando os UUIDs foram especificados pela primeira vez. A codificação hexadecimal duplica a contagem de bytes: 16 bytes torna-se 32 dígitos hexadecimais mais 4 hífens. É a codificação mais lenta e mais longa, mas legível e suportada em todos os lugares. Regras de maiúsculas e minúsculas: RFC 9562 exige letras minúsculas para saída canônica, mas a entrada não diferencia maiúsculas de minúsculas. Armazenar letras maiúsculas desperdiça uma oportunidade de normalização; portanto, armazene letras minúsculas e compare a entrada sem distinção entre maiúsculas e minúsculas. A codificação Base64url representa três bytes como quatro caracteres usando um alfabeto de 64 caracteres (A – Z, a – z, 0–9, menos, sublinhado). Dezesseis bytes tornam-se 21 caracteres mais um caractere de preenchimento, totalizando 22 caracteres. Base64url remove o preenchimento e os caracteres padrão (mais e barra) reservados em URLs.
Regras de maiúsculas e minúsculas - letras minúsculas na saída, sem distinção entre maiúsculas e minúsculas na entrada e por que comparações com maiúsculas e minúsculas causam incompatibilidades silenciosas
Um UUID no formato base64url salva 14 caracteres em comparação com hexadecimal e é válido em URLs sem codificação percentual. A desvantagem: é menos legível (letras minúsculas parecem dígitos; b, 8, B e 8 são fáceis de confundir). Base58 é usado pelo Bitcoin e outros blockchains e remove caracteres ambíguos (0, O, I, l), tornando o resultado 22–23 caracteres enquanto permanece legível. Crockford base32 (projetado para formatos semelhantes a ISBN com soma de verificação) usa caracteres 26 e prioriza a correção em vez da brevidade. A armadilha de ordem de bytes GUID da Microsoft se aplica ao armazenamento UUID em alguns bancos de dados. RFC 9562 especifica a ordem de bytes da rede (big-endian) para todos os bytes. Algumas configurações do servidor Microsoft SQL armazenam GUIDs com ordem de bytes little-endian nos três primeiros campos.
Codificações mais curtas — base64url em 22 caracteres, base58 e Crockford base32, com suas compensações em legibilidade e segurança de copiar e colar
O mesmo valor de 128 bits armazenado em big-endian e little-endian produz strings hexadecimais diferentes. Um UUID 550e8400-e29b-41d4-a716-446655440000 armazenado como um Microsoft GUID pode ser recuperado como 00840e55-9be2-d441-a716-446655440000 (bytes 0–3 e 4–5 e 6–7 invertidos). Se o seu sistema fizer uma ponte entre os sistemas compatíveis com RFC e os sistemas Microsoft, você deverá estar ciente disso e normalizar no limite ou documentar o formato que está usando em cada coluna. Exemplo resolvido: o v4 UUID 9b2e4f1a-4f3e-4c1a-8a7d-1b2c3d4e5f60 em hexadecimal ocupa 36 caracteres. Como 16 bytes é 9b 2e 4f 1a 4f 3e 4c 1a 8a 7d 1b 2c 3d 4e 5f 60. Em base64url: divida em pedaços de três bytes, converta para base64, remova o preenchimento: my5PGk8-TBqKfRssPTRPX2A. Em hexadecimal sem hífens: 9b2e4f1a4f3e4c1a8a7d1b2c3d4e5f60 (32 caracteres).
A armadilha da ordem de bytes da Microsoft - como os três primeiros campos de GUID são armazenados em little endian, para que os mesmos bytes possam ser impressos como duas strings diferentes
Base64url salva 14 caracteres; base58 economizaria aproximadamente o mesmo; hexadecimal é o padrão. Escolha com base no seu caso de uso: se o identificador aparecer em URLs e todos os caracteres forem importantes, use base64url; se aparecer em logs e UIs onde humanos o leem, use a forma canônica hexadecimal; se você estiver construindo um sistema blockchain ou sistema distribuído onde a soma de verificação é importante, use base58 ou Crockford base32. Ao escolher um tipo de coluna, armazene o valor que otimiza seu padrão de acesso real. Se você consulta UUIDs com frequência e precisa de correspondência sem distinção entre maiúsculas e minúsculas, armazene binary(16) e deixe o banco de dados lidar com a representação. Se você consultar por substring (procurando por UUIDs que começam com um prefixo), o hexadecimal será mais legível na saída de depuração.
Exemplo resolvido - um identificador escrito como bytes, hexadecimal canônico e uma forma abreviada, mostrando cada etapa de conversão
Se você exportar para CSV e enviar e-mail para usuários não técnicos, o hexadecimal será mais reconhecível. Se você tiver restrição de espaço (aplicativo móvel com cache local), base64url ou base58 economiza largura de banda. O gerador ToolAcre gera formato hexadecimal canônico de 36 caracteres; se você precisar de uma codificação diferente, a verificação bem formada ainda funcionará porque normaliza qualquer representação válida antes de verificar o formato. As considerações de desempenho são importantes ao codificar ou decodificar milhões de UUIDs. A codificação hexadecimal é simples: converta cada byte em dois caracteres em tempo O(1) por byte. A decodificação é igualmente simples. A codificação e decodificação Base64 usam tabelas de pesquisa e são um pouco mais lentas (aproximadamente 2–3x mais lentas que hexadecimal por byte, dependendo do hardware e da implementação). Base58 é significativamente mais lento porque é essencialmente uma conversão de base e requer aritmética modular.
O que isso não cobre — opções de coluna do banco de dados, como tipos uuid nativos versus binário(16), abordadas separadamente
Se o seu sistema codifica ou decodifica UUIDs em um hot loop (geração de identificador de alta frequência, exportação em massa), o hexadecimal é mais rápido. Se a codificação acontecer com pouca frequência e a economia de 14 caracteres for importante, base64url é uma compensação razoável. O gerador ToolAcre gera hexadecimal, então você obtém vantagem de desempenho sem sacrificar a compatibilidade. A semântica de comparação de strings difere pela codificação. UUIDs hexadecimais podem ser comparados como strings: 550e8400-e29b-41d4-a716-446655440000 < 550e8400-e29b-41d4-a716-446655440001 (comparação lexicográfica funciona). UUIDs binários podem ser comparados como bytes: a comparação byte a byte é igual à comparação numérica. UUIDs codificados em Base64url e base58, no entanto, não preservam a ordem numérica na comparação de strings lexicográficas. Se o seu sistema depende da classificação lexicográfica de UUIDs (um padrão surpreendentemente comum para construir índices ou chaves de banco de dados), você deve usar hexadecimal, binário ou uma variante UUID classificável (v6 ou v7).
Conclusão: mantenha a forma canônica nos limites - o gerador ToolAcre gera UUIDs padrão de 36 caracteres e sua verificação aceita strings nesse formato
O gerador ToolAcre atualmente produz UUIDs v4, que não podem ser classificados por ordem de codificação. A interoperabilidade requer padronização em uma única codificação. Um sistema que aceita UUIDs em hexadecimal, base64 e base58 simultaneamente deve normalizar todas as entradas para um formato canônico antes do processamento. Isso é possível, mas adiciona complexidade. APIs ou bancos de dados externos podem exigir uma codificação específica: algumas APIs esperam urn:uuid: hex prefixado, outras esperam hexadecimal sem hífen, outras ainda esperam base64url. Documente claramente a expectativa de codificação UUID do seu sistema em contratos API. O gerador ToolAcre sempre gera hexadecimal canônico; se precisar de outras codificações, execute a conversão explicitamente e documente as compensações (espaço, desempenho, legibilidade, classificação) para a equipe.