Video & Untertitel · Untertitel-Toolkit
Warum é in Untertiteln zu é wird: Textkodierungen und wie Browser sie dekodieren
· Wie es funktioniert
Untertitel Zeichenkodierung Browser-Verarbeitung
Mojibake in Untertiteln ist fast immer ein Kodierungskonflikt. In diesem Beitrag wird erklärt, wie Bytes zu Zeichen werden, warum UTF-8 und ältere Windows-Codepages nicht übereinstimmen und wie ein browserbasiertes Tool eine Datei dekodiert, ohne sie irgendwohin zu senden.
Die Akzente sind Müll, aber das Timing ist perfekt – wie Kodierungsprobleme auftreten
Die Aussage ist, dass bis auf die Charaktere alles in Ordnung ist. Die Timings sind exakt, die Cue-Reihenfolge stimmt, die Datei wird geladen und nur die Buchstaben mit Akzent sind falsch. Diese Kombination schließt einen Strukturfehler aus, da ein Parser, der die Datei nicht lesen konnte, keine korrekten Timings erzeugt hätte. Was schief lief, geschah vor dem Parsen, als eine Folge von Bytes in eine Folge von Zeichen umgewandelt wurde.
Dies erklärt auch, warum der Fehler häufig in der Mitte eines Arbeitsablaufs und nicht an der Quelle auftritt. Die Datei, die in einem Editor korrekt aussah, kann im nächsten falsch aussehen, ohne dass sie dazwischen geändert wurde. Nichts hat es verändert; Das zweite Programm ging von der Bedeutung der Bytes anders aus.
Bytes im Vergleich zu Zeichen – warum dieselben Bytes je nach Decoder als „é“ oder „é“ gelesen werden können
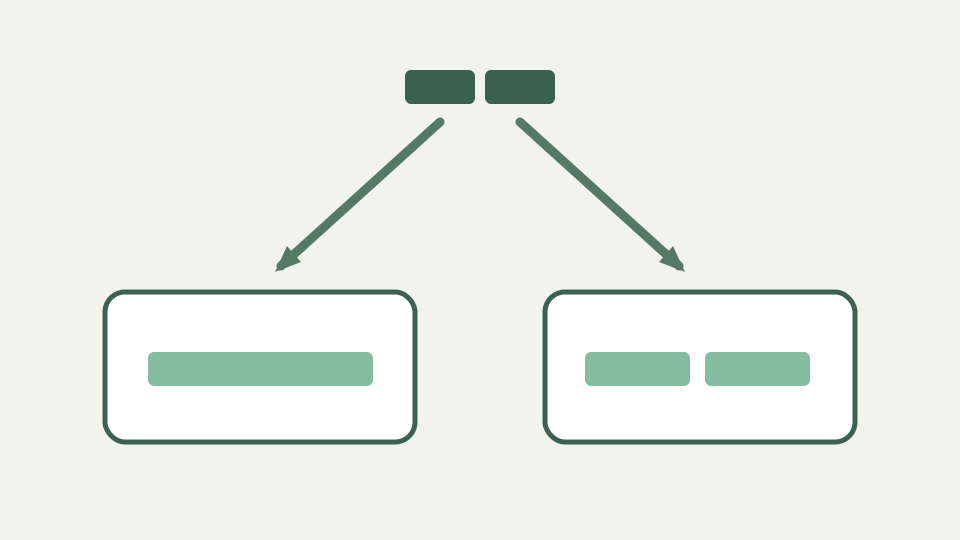
Eine Datei auf der Festplatte besteht aus Bytes. Zeichen existieren nur, wenn etwas eine Kodierung anwendet, bei der es sich um eine Tabelle handelt, die Bytesequenzen Zeichen zuordnet. UTF-8 stellt einen akzentuierten lateinischen Buchstaben wie e-acute als zwei Bytes dar. Windows-1252 stellt denselben Buchstaben wie ein einzelnes Byte dar und gibt den beiden UTF-8-Bytes völlig unterschiedliche Bedeutungen: Das erste ist ein großes A mit Tilde und das zweite ist ein Copyright-Zeichen.
Das bekannte verstümmelte Paar ist also keine Korruption. Es handelt sich um ein originalgetreues, verlustfreies Lesen der richtigen Bytes unter der falschen Tabelle. Jedes Byte hat überlebt; nur die Interpretation änderte sich. Aus diesem Grund ist der Schaden in der Regel reversibel und es lohnt sich, die Richtung der Nichtübereinstimmung zu ermitteln, anstatt die sichtbaren Zeichen manuell zu bearbeiten.
UTF-8, Windows-1252 und Freunde – die kodierten Untertiteldateien tauchen tatsächlich auf
Untertiteldateien werden in einer kleinen Anzahl von Kodierungen angezeigt. UTF-8 ist der moderne Standard und der einzige, den WebVTT zulässt. Windows-1252 kommt häufig in Dateien vor, die mit älteren westeuropäischen Tools erstellt wurden, und sein enger Verwandter ISO-8859-1 deckt weitgehend den gleichen Bereich ab. Dateien aus mitteleuropäischen, kyrillischen oder griechischen Quellen erscheinen in den entsprechenden Windows-Codepages, und ostasiatisches Material fügt mehrere weitere hinzu.
Keine dieser Kodierungen zeichnet ihre eigene Identität in der Datei auf. Eine SRT-Datei enthält keine Deklaration der zum Schreiben verwendeten Kodierung, was die Wurzel des gesamten Problems ist: Der Leser muss entscheiden, und es gibt nichts, was maßgeblich ist und gelesen werden könnte.
Die Byte-Reihenfolge-Markierung – ein hilfreicher Hinweis für einige Spieler und ein sichtbarer Fehler bei anderen
Eine Byte-Reihenfolgemarkierung ist die einzige teilweise Ausnahme. Es handelt sich um ein bestimmtes Zeichen ganz am Anfang einer Datei, das, sofern vorhanden, die Kodierung signalisiert. Bei manchen Spielern hilft es, bei anderen taucht es als verirrtes Zeichen vor dem ersten Untertitelindex auf, weshalb Dateien mit einem solchen Zeichen in genau einem Programm fehlschlagen und überall sonst funktionieren können.
Der Parser entfernt es, bevor er etwas anderes tut, da sich eine an Ort und Stelle belassene Markierung an die erste Indexnummer anfügt und den ersten Hinweis kostet. Die Formaterkennung ist so geschrieben, dass sie dies ebenfalls toleriert, sodass eine WebVTT-Datei, die mit einer Markierung vor ihrem Header beginnt, weiterhin als WebVTT erkannt und nicht als SRT behandelt wird.
Wie ein Browser eine Datei lokal dekodiert – die TextDecoder-API und warum die Erkennung eine Vermutung ist, wenn keine Kodierung deklariert ist
Wenn das Tool eine Datei lädt, ruft es die Datei-API-Textmethode auf und diese Methode wird zum Dekodieren als UTF-8 angegeben. Es gibt keinen Codierungsparameter und keine Aushandlung. Eine Datei, die wirklich UTF-8 ist, wird korrekt gelesen; Eine Windows-1252-Datei, die einen Einzelbyte-Buchstaben mit Akzent enthält, stellt ein Byte dar, das keine gültige UTF-8-Sequenz beginnen kann, und der Decoder ersetzt ein Ersatzzeichen, anstatt zu raten.
Das ist wissenswert, weil es das Symptom verändert. Das Lesen einer UTF-8-Datei mit einer Legacy-Tabelle erzeugt die bekannte zweistellige Verstümmelung. Das Lesen einer Legacy-Datei als UTF-8 erzeugt stattdessen Ersatzzeichen, die schwarzen Rauten oder leeren Kästchen. Die Dekodierung als etwas anderes als UTF-8 erfordert die explizite Benennung der Kodierung über die Browser-Decoder-API, und die Benennung ist der schwierige Teil: Ohne Deklaration in der Datei ist jede automatische Auswahl eine Schlussfolgerung aus Bytemustern, was eine Vermutung ist, die normalerweise richtig und gelegentlich sicher falsch ist.
Arbeitsbeispiel: Rettung einer Windows-1252-Datei – Identifizieren der Quellkodierung und erneutes Speichern als UTF-8 vor der Konvertierung
Um eine ältere Datei zu retten, führen Sie die Konvertierung vor der Untertitelarbeit und nicht danach durch. Öffnen Sie es in einem Editor, in dem Sie die Codierung auf beiden Seiten angeben können, weisen Sie ihn an, die Datei als Windows-1252 erneut zu öffnen, und überprüfen Sie, ob die Zeichen mit Akzent korrekt angezeigt werden. Wenn ja, war die Vermutung richtig. Speichern Sie die Datei dann explizit als UTF-8.
Überprüfen Sie eine Zeile, die Sie vorhersagen können, und nicht die Datei als Ganzes. Wählen Sie einen Cue mit einem Akzent aus, von dem Sie wissen, dass er vorhanden sein sollte, und überprüfen Sie ihn in der konvertierten Ausgabe. Wenn Sie dies zunächst tun, erhält das Untertitel-Tool eine Datei, deren Bytes bereits mit der Kodierung übereinstimmen, die es annehmen wird, und beim Konvertierungsschritt kann nichts mehr schief gehen.
Was dies nicht abdeckt – Dateien, die durch zwei Runden falscher Konvertierung beschädigt wurden, wobei die ursprünglichen Bytes bereits verloren gegangen sind
Eine Datei, die zwei falsche Konvertierungen durchlaufen hat, ist ein anderes Problem. Wenn eine Datei falsch gelesen und dann in diesem Fehlerzustand gespeichert wurde, wurden die falschen Zeichen als echte Zeichen ausgeschrieben und die ursprünglichen Bytes sind nirgendwo mehr darin vorhanden. Zu diesem Zeitpunkt gibt es nichts, was man neu interpretieren müsste, da die Datei nun tatsächlich den verstümmelten Text enthält.
Diese Fälle können manchmal durch Umkehren der genauen Reihenfolge fehlerhafter Codierungen behoben werden, aber nur, wenn jeder Schritt bekannt ist und bei keinem Schritt Informationen verloren gehen. Ein Byte, das zum Ersatzzeichen wurde, ist dauerhaft verschwunden: Der Ersatz ist ein einzelnes Zeichen, das für ein Byte steht, das der Decoder nicht verwenden konnte, und es wird nicht aufgezeichnet, um welches Byte es sich handelte. Die zuverlässige Lösung besteht darin, zur Originaldatei zurückzukehren.
Fazit: Standardisieren Sie vor der Konvertierung UTF-8 – wie das Subtitle Toolkit mit Ihrer Datei im Browser funktioniert und warum die WebVTT-Ausgabe per Definition UTF-8 ist
Standardisieren Sie UTF-8, bevor Sie etwas konvertieren. Die Datei selbst enthält keine Angaben zu ihrer Kodierung, daher geht jedes Programm, das sie öffnet, von einer Annahme aus, und die Möglichkeit, widersprüchliche Annahmen zu vermeiden, besteht darin, sie alle richtig zu machen. WebVTT beseitigt die Mehrdeutigkeit per Definition, da das Format UTF-8 erfordert, was ein praktischer Grund ist, SRT für die Webbereitstellung in WebVTT zu konvertieren.
Die Konvertierung wird für die Datei im Browser-Tab ausgeführt. Überprüfen Sie das Ergebnis anhand einer Zeile, deren Akzente Sie vorhersagen können, anstatt nach etwas zu suchen, das falsch aussieht, denn eine Datei mit einer Handvoll akzentuierter Wörter in neunhundert Hinweisen lässt sich leicht abzeichnen, ohne den Teil untersucht zu haben, der fehlschlagen würde.