Vídeo y subtítulos · Descargador directo de medios
Cómo un navegador descarga un archivo desde un enlace directo con fetch y Blob
· Cómo funciona
Publicado por ToolAcre · Revisión editorial
descargas APIS del navegador cors
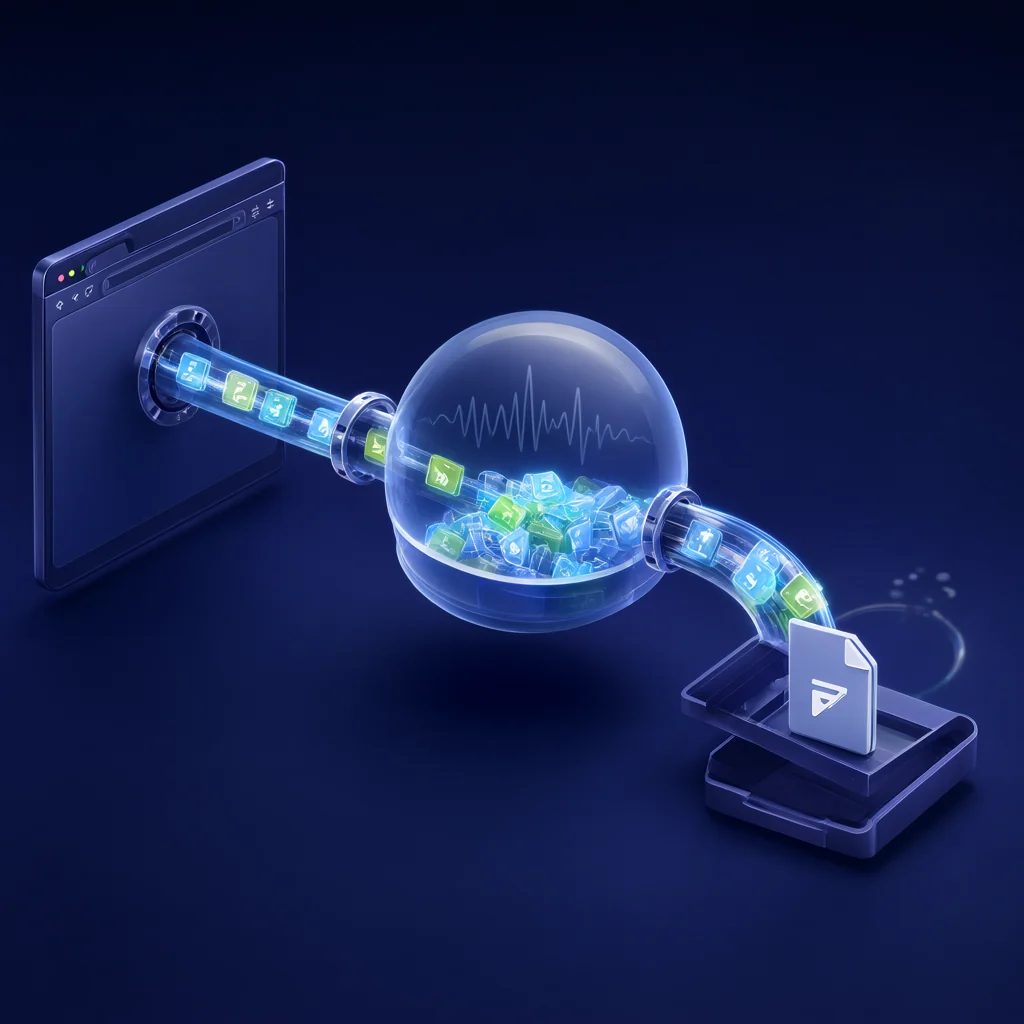
Recorre el proceso que utiliza una herramienta de navegador para convertir un enlace directo en un archivo guardado: recupera los bytes, mantenlos como un Blob y entrégalos al atributo de descarga. Explica por qué no se necesita ningún servidor en ningún paso.
El enlace abre un reproductor en lugar de guardar un archivo; al hacer clic en un enlace directo de MP4 o MP3 generalmente se reproduce en línea, que es el problema que resuelve un descargador.
Al hacer clic en un enlace directo de MP3 se puede abrir un reproductor porque el navegador sabe cómo reproducir ese tipo MIME. Guardar los mismos bytes es una acción independiente. La palabra clave es directa: un enlace a una respuesta de archivo real, no una página web que contenga un reproductor o un manifiesto que enumere segmentos de medios. ToolAcre hace esta distinción antes de ofrecer una descarga y no pretende que la URL de una página sea una URL de archivo.
Paso uno: fetch() le pregunta al host los bytes: cómo se ve una solicitud GET al host anunciado y qué devuelve
Después de elegir Verificar enlace, el navegador puede emitir una solicitud HEAD a la URL que proporcionó para inspeccionar el estado, el tipo y la longitud. La recuperación del archivo utiliza una solicitud GET a ese host, no un proxy ToolAcre. La solicitud omite deliberadamente las credenciales, por lo que un host que requiera su inicio de sesión puede rechazarla. El servidor remoto también debe permitir lecturas de scripts de orígenes cruzados; Si CORS bloquea el acceso, la herramienta explica el rechazo en lugar de evitarlo a través de un relé oculto. Una redirección puede cambiar el destino, así que verifique el host anunciado.
Paso dos: el cuerpo de la respuesta se convierte en un Blob: cómo se recopilan los bytes en la memoria y por qué el Blob tiene un tipo MIME
El cuerpo de respuesta se lee como una corriente de trozos de byte. Los avances pueden usar Content-Length cuando el anfitrión lo expone; sin una longitud conocida la herramienta puede mostrar bytes recibidos pero no un porcentaje confiable. Ejecute un techo de memoria mientras recoge pedazos, luego monta un Blob con el tipo de contenido devuelto. Esto es más seguro que llamar response.blob() en un flujo ilimitado, pero no es la transmisión de memoria cero al disco: el Blob completado todavía ocupa espacio en su sesión del navegador.
Paso tres: URL.createObjectURL y el atributo de descarga: cómo un blob temporal: URL más un ancla activa el cuadro de diálogo para guardar
Un Blob son datos en la memoria, no una dirección de Internet. El navegador puede crear un blob temporal: URL de objeto y adjuntarlo a un ancla con un nombre de archivo de descarga; Al hacer clic en ese ancla, se le solicita al navegador que guarde los bytes. El nombre del archivo puede provenir de un encabezado de disposición de contenido o de la ruta URL en lugar del título de la página. Dado que el enlace ahora es una URL de Blob de la misma página, el navegador puede guardar el resultado sin alojarlo en ToolAcre. Aún así es aconsejable inspeccionar la extensión y el tipo MIME antes de abrir un archivo de una fuente desconocida.
Ejemplo resuelto: guardar un episodio de podcast desde su enlace adjunto, siguiendo un MP3 desde la URL pegada a un archivo en el disco
Imagina un editor de podcasts que exponga un recinto autorizado URL terminando episode.mp3. Pruebe esa dirección exacta, inspeccione el host anunciado y utilice el enlace Check. Si HEAD se permite que pueda mostrar audio/mpeg y un recuento de byte esperado; Fetch entonces pide al editor para el MP3 bytes, los transmite en un Blob y salva episode.mp3. Si el anfitrión omite CORS encabezados, el navegador puede jugar el enlace en su propia pestaña mientras que esta página no puede buscarlo por script; “Guardar enlace como” puede ser la ruta correcta. El derecho del usuario a guardar el archivo está separado de si su servidor permite técnicamente buscarlo.
Limpieza: revocar la URL del objeto y liberar memoria: por qué un programa de descarga bien diseñado libera el Blob una vez que se completa el guardado
Las URL de objetos temporales mantienen referencias a sus Blobs de respaldo. Un programa de descarga que deja vivas todas las URL puede retener archivos grandes en una pestaña de larga duración. La utilidad de descarga compartida de ToolAcre crea una URL local para la acción de guardar y la revoca cuando finaliza; la cancelación libera el lector de respuestas y descarta fragmentos parciales. Para archivos muy grandes, una descarga normal del navegador desde el host es mejor que recopilar la respuesta completa en la memoria de la página.
Lo que esto no cubre: URL de páginas, manifiestos de transmisión, DRM y enlaces que requieren un inicio de sesión.
Esta herramienta no encontrará medios ocultos detrás de una página de video, no analizará manifiestos HLS/DASH .m3u8 o .mpd, no omitirá DRM, falsificará encabezados ni accederá a una transmisión protegida por sesión. No descarga contenido privado por usted y no decide si una licencia otorga permiso para copiar un archivo. Un 403, una redirección a una página de inicio de sesión o un error de CORS es un límite que hay que comprender, no una señal para buscar un proxy no documentado.
Conclusión: tres API de navegador, sin servidor: cómo Direct Media Downloader aplica esta canalización al enlace que pega
La canalización se recupera del host proporcionado → recibe fragmentos → crea un Blob → activa una descarga local. No interviene ninguna retransmisión de ToolAcre, pero sí una solicitud real al host de terceros; sus registros pueden ver la conexión. Direct Media Downloader anuncia ese contacto antes de realizarlo y le avisa cuando las reglas de seguridad del navegador rechazan una lectura de origen cruzado.