वीडियो और उपशीर्षक · उपशीर्षक टूलकिट
उपशीर्षक फ़ाइल को 'साफ करने' का क्या अर्थ है: टैग, कोड और आवारा स्वरूपण
· यह काम किस प्रकार करता है
उपशीर्षक पाठ प्रसंस्करण फ़ाइल स्वरूपों
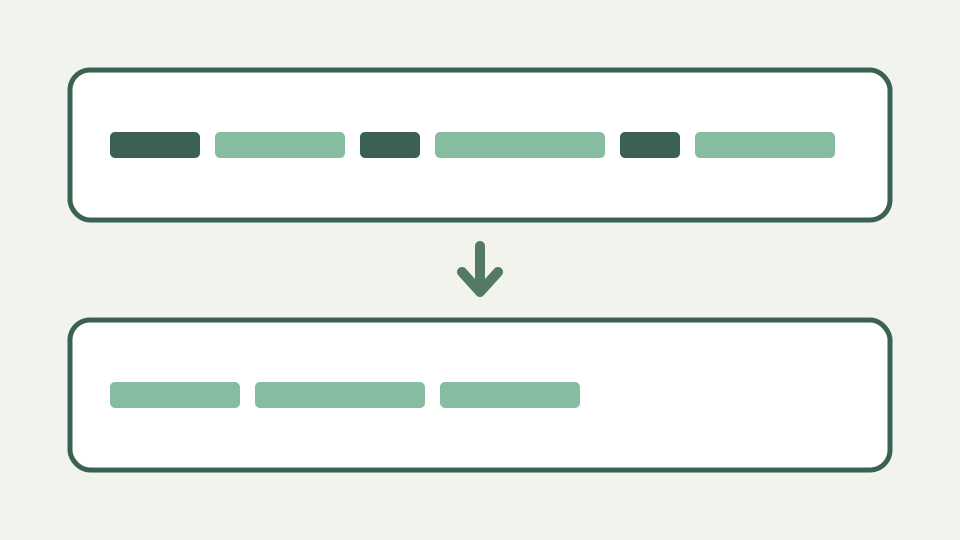
उपशीर्षक फ़ाइलें कबाड़ इकट्ठा करती हैं: HTML-जैसे टैग, अन्य प्रारूपों से स्टाइलिंग कोड, भटके हुए बीओएम और मिश्रित लाइन अंत। यह पोस्ट बताती है कि प्रत्येक प्रकार की अव्यवस्था क्या है, यह कहां से आती है और कैसे एक साफ कदम शब्दों को छुए बिना इसे दूर कर देता है।
कैप्शन स्क्रीन पर '{\an8}' और '<i>' प्रदर्शित करते हैं - एक अशुद्ध उपशीर्षक फ़ाइल के दृश्यमान लक्षण
जब कोई कैप्शन किसी टैग का पालन करने के बजाय उसके वर्ण प्रदर्शित करता है, तो प्लेयर आपको बता रहा है कि वह उस मार्कअप को लागू नहीं करता है। SRT में कोई स्वरूपण विनिर्देश नहीं है, इसलिए समर्थन पारंपरिक है: कई खिलाड़ी HTML-जैसे टैग के एक छोटे सेट का सम्मान करते हैं, और उस सेट के बाहर कुछ भी शाब्दिक पाठ के रूप में तैयार किया जाता है। एक फ़ाइल जो एक प्लेयर में सही ढंग से प्रस्तुत होती है और दूसरे में ब्रेसिज़ दिखाती है, वह नहीं बदली है; केवल टैग के सेट को सम्मानित किया जा रहा है।
यही कारण है कि कॉस्मेटिक सफ़ाई के बजाय सफ़ाई एक वास्तविक कार्य है। अव्यवस्था कोई सजावट नहीं है जो कुरूप हो जाए। यह एक प्रारूप के लिए लिखे गए निर्देश हैं जिन्हें एक अलग खिलाड़ी संवाद के रूप में पढ़ता है, और इसका समाधान यह है कि प्रत्येक शब्द को बरकरार रखते हुए निर्देशों को हटा दिया जाए।
अव्यवस्था कहां से आती है - स्टाइल-भारी प्रारूपों से निर्यात, OCR आउटपुट और एडिटर जो अपना स्वयं का मार्कअप जोड़ते हैं
अधिकांश अव्यवस्था रूपांतरण के माध्यम से आती है। ASS या SSA जैसे स्टाइल-हैवी प्रारूप में लिखी गई फ़ाइल स्थिति और उपस्थिति निर्देशों को इनलाइन करती है, और एक कन्वर्टर जो समय को ईमानदारी से मैप करता है वह अक्सर उन निर्देशों को पाठ के रूप में पारित कर देगा। कैप्शनिंग एडिटर स्पीकर की पहचान और जोर देने के लिए अपना स्वयं का मार्कअप जोड़ते हैं, और बर्न-इन उपशीर्षक की ऑप्टिकल कैरेक्टर पहचान में छिटपुट विराम चिह्न और दोगुने स्थान शामिल होते हैं जिन्हें किसी भी लेखक ने टाइप नहीं किया है।
इनमें से कोई भी स्रोत अपनी दुनिया में विकृत नहीं है। ASS ओवरराइड ब्लॉक ASS में सार्थक है। समस्या यह है कि SRT का कोई समकक्ष नहीं है, इसलिए दोषरहित दिखने वाला रूपांतरण एक फ़ाइल बनाता है जहां निर्देश व्यवहार के बजाय वर्णों के रूप में जीवित रहता है।
फ़ॉर्मेटिंग टैग - इटैलिक, बोल्ड और फ़ॉन्ट टैग, कौन से खिलाड़ी उनका सम्मान करते हैं और कौन से उन्हें अक्षरशः दिखाते हैं
कोण-ब्रैकेट टैग को पहले नियंत्रित किया जाता है, एक नियमित अभिव्यक्ति के साथ जो कम-से-कम और अगले बड़े-से-के बीच सब कुछ हटा देता है। इसमें इटैलिक और बोल्ड टैग, क्यू क्लास एनोटेशन जैसे WebVTT क्लास टैग और स्पीकर का नाम देने वाले वॉयस टैग शामिल हैं। महत्वपूर्ण गुण यह है कि यह एक टेक्स्ट प्रतिस्थापन है, न कि HTML पार्सर, और यह शुरुआती टैग को बंद करने वाले टैग से मिलाने का प्रयास नहीं करता है।
उस सरलता की कीमत जानने लायक होती है। संवाद की एक पंक्ति जिसमें वास्तव में कम-से-कम और अधिक-से-अधिक शामिल है, जैसे कि बोली जाने वाली असमानता, उनके बीच के पाठ को कोष्ठक के साथ हटा दिया जाएगा। यह संवाद में दुर्लभ है और तकनीकी कैप्शन में आम है, इसलिए कोड या गणित पर चर्चा करने वाली सामग्री पर सफाई पास के आउटपुट को स्कैन करना उचित है।
पोज़िशन और स्टाइल कोड—ASS/SSA में {\an8} जैसे कोड का क्या मतलब है और SRT में वे अनचाहे टेक्स्ट क्यों बनते हैं
ब्रेस कोड को दूसरे प्रतिस्थापन द्वारा हटा दिया जाता है, जिसमें खुलने और बंद होने वाले ब्रेस के बीच सब कुछ शामिल होता है। सबस्टेशन प्रारूपों में ये ओवरराइड ब्लॉक होते हैं, और सबसे अधिक बार देखा जाने वाला वह है जो एक रेखा को फ्रेम के शीर्ष पर ले जाता है ताकि यह बर्न-इन टेक्स्ट से न टकराए। अन्य लोग फ़ॉन्ट, रंग, रोटेशन या कराओके समय निर्धारित करते हैं।
SRT फ़ाइल में उनमें से किसी का भी कोई मतलब नहीं है, यही कारण है कि उन्हें अनुवादित करने के बजाय हटा दिया जाता है। स्थिति निर्देश में अनुवाद करने के लिए कोई SRT समकक्ष नहीं है: प्रारूप में केवल प्लेसमेंट नहीं होता है। कोड को हटाने से लेखक का इरादा खत्म हो जाता है कि लाइन फ्रेम के शीर्ष पर होनी चाहिए, और यह नुकसान वास्तविक है, लेकिन दर्शक के लिए कोड को प्रिंट करना बेहतर है।
अदृश्य अव्यवस्था - बाइट-ऑर्डर चिह्न, मिश्रित CRLF और LF लाइन अंत और अनुगामी स्थान
अदृश्य अव्यवस्था को पार्सिंग के दौरान पहले ही संभाल लिया जाता है, और इसे अलग करना उचित है क्योंकि यह बिल्कुल भी पाठ का हिस्सा नहीं है। फ़ाइल की शुरुआत में एक बाइट ऑर्डर चिह्न किसी भी अन्य चीज़ से पहले हटा दिया जाता है, क्योंकि अन्यथा यह पहले इंडेक्स नंबर से जुड़ जाता है और पहले क्यू की लागत आती है। कैरिज रिटर्न को सामान्यीकृत किया जाता है, विंडोज़ जोड़ी और एक लोन कैरिज रिटर्न दोनों, इसलिए दो प्लेटफ़ॉर्म पर संपादित फ़ाइल सही ढंग से ब्लॉक में विभाजित हो जाती है।
क्UK अंदर व्हाइटस्पेस को टैग के साथ नियंत्रित किया जाता है। दो या दो से अधिक रिक्त स्थान या टैब के रन एक ही स्थान पर सिमट जाते हैं, प्रत्येक पंक्ति को अलग-अलग ट्रिम किया जाता है, और लाइनों के दोबारा जुड़ने के बाद क्यू को समग्र रूप से ट्रिम किया जाता है। चरित्र संस्थाओं को जानबूझकर अकेला छोड़ दिया जाता है: एक एम्परसेंड इकाई वह सामग्री है जिसे एक दर्शक को देखना चाहिए, मार्कअप नहीं, और एक क्लीनर जिसने इसे डीकोड किया है वह निर्देशों को हटाने के बजाय संवाद को संपादित करेगा।
कारगर उदाहरण: 200-क्यू निर्यात को साफ करना - क्या बदलता है, क्या रहता है और परिणाम की जांच कैसे करें
किसी बड़े निर्यात को साफ़ करने से जितना दिखाई देता है उससे कम परिवर्तन होता है। दो-सौ क्यू फ़ाइल लें जहां एक कन्वर्टर ने शीर्ष-फ़्रेम कोड को साठ संकेतों से पहले जोड़ा है और आगे चालीस के चारों ओर जोर टैग लपेटे हैं। दो प्रतिस्थापन कोड और टैग को हटा देते हैं, व्हाइटस्पेस पास हटाए गए दोगुने स्थानों को ढहा देता है, और दो सौ संकेत समान शब्दों और समान समय के साथ दो सौ संकेत बन जाते हैं।
आगे के दो कदम मायने रखते हैं। एक क्यू जिसकी पूरी सामग्री एक भटका हुआ कोड था, कोड खत्म हो जाने के बाद खाली हो जाता है, और खाली संकेतों को खाली ब्लॉक के रूप में उत्सर्जित करने के बजाय एक अलग पास में हटा दिया जाता है, क्योंकि टाइमस्टैम्प और बिना पाठ वाला क्यू एक अंतराल है जिसे कुछ खिलाड़ी फ्लैश के रूप में प्रस्तुत करते हैं। फ़ाइल को वापस लिखने से संकेतों को एक से पुनः क्रमांकित किया जाता है और उन्हें सन्निहित रखा जाता है, ताकि निष्कासन अनुक्रम में कोई छेद न छोड़े। क्यू गणना की तुलना करके और किसी भी लाइन की स्पॉट-चेकिंग करके परिणाम की जांच करें जिसमें मूल रूप से एक इकाई शामिल थी।
इसमें क्या शामिल नहीं है - पाठ को दोबारा लिखना, वर्तनी या अनुवाद; शब्द आपके हैं
सफाई से मार्कअप हट जाता है और भाषा पर असर नहीं पड़ता है। यह वर्तनी को ठीक नहीं करता, संक्षिप्ताक्षरों का विस्तार नहीं करता, प्रतिलेखन त्रुटियों को ठीक नहीं करता, या अनुवाद नहीं करता। यदि कोई कैप्शन गलत शब्द कहता है, तो वह बाद में गलत शब्द कहेगा, सही ढंग से स्वरूपित किया गया। वह सीमा जानबूझकर बनाई गई है: एक टूल जो चुपचाप संवाद को फिर से लिखता है उस सामग्री पर भरोसा करना असंभव होगा जिसे वह नहीं समझता है।
यह संरचना की मरम्मत भी नहीं करता है. जिस फ़ाइल के ब्लॉक में टाइमस्टैम्प की कमी है, उसमें पार्सिंग समस्या है, फ़ॉर्मेटिंग समस्या नहीं है, और इसमें से टैग हटाने से संकेत उत्पन्न नहीं होंगे। एन्कोडिंग दोष वैसे ही दायरे से बाहर हैं। गलत कैरेक्टर सेट के साथ डीकोड की गई फ़ाइल पूरी तरह से अच्छी तरह से गठित संकेत उत्पन्न करती है जिसका पाठ गलत है, और टैग हटाने की कोई भी मात्रा इसका पता नहीं लगाती है, क्योंकि संरचना के बारे में कुछ भी टूटा नहीं है।
टेकअवे: मार्कअप हटाएं, अर्थ रखें - उपशीर्षक टूलकिट का साफ-सुथरा कदम आम अव्यवस्था को कैसे संभालता है और जो कुछ छोड़ता है उसे दस्तावेजित करता है
नियम है मार्कअप हटाओ, अर्थ रखो। एंगल-ब्रैकेट टैग और ब्रेस कोड इसलिए चलते हैं क्योंकि ये ऐसे निर्देश हैं जिन्हें खिलाड़ी या तो अनदेखा कर देता है या प्रिंट कर देता है। दोगुनी जगहें और प्रति-पंक्ति पैडिंग इसलिए जाती है क्योंकि वे हटाने या मूल निर्यात की कलाकृतियाँ हैं। इकाईयाँ, विराम चिह्न और प्रत्येक शब्द बने रहते हैं, क्योंकि दर्शक को यही पढ़ना चाहिए।
उपशीर्षक टूलकिट कन्वर्टर के माध्यम से एक टैग-भारी निर्यात चलाएं और एक नज़र में आउटपुट पर भरोसा करने के बजाय इसकी तुलना मूल से करें। पुष्टि करें कि क्यू गणना अपरिवर्तित है, सिवाय इसके कि जहां संकेत वास्तव में खाली थे, जांचें कि किसी इकाई वाली किसी भी पंक्ति में अभी भी वह शामिल है, और उन लाइनों को स्कैन करें जो एक आवारा कोण ब्रैकेट में खोए गए पाठ के लिए कोड या गणित पर चर्चा करते हैं।