Herramientas de desarrollo · Escapador de entidades HTML
Decodificación de entidades HTML sin internalHTML: cómo funciona un decodificador de tabla de búsqueda
· Cómo funciona
Publicado por ToolAcre · Revisión editorial
html seguridad codificación
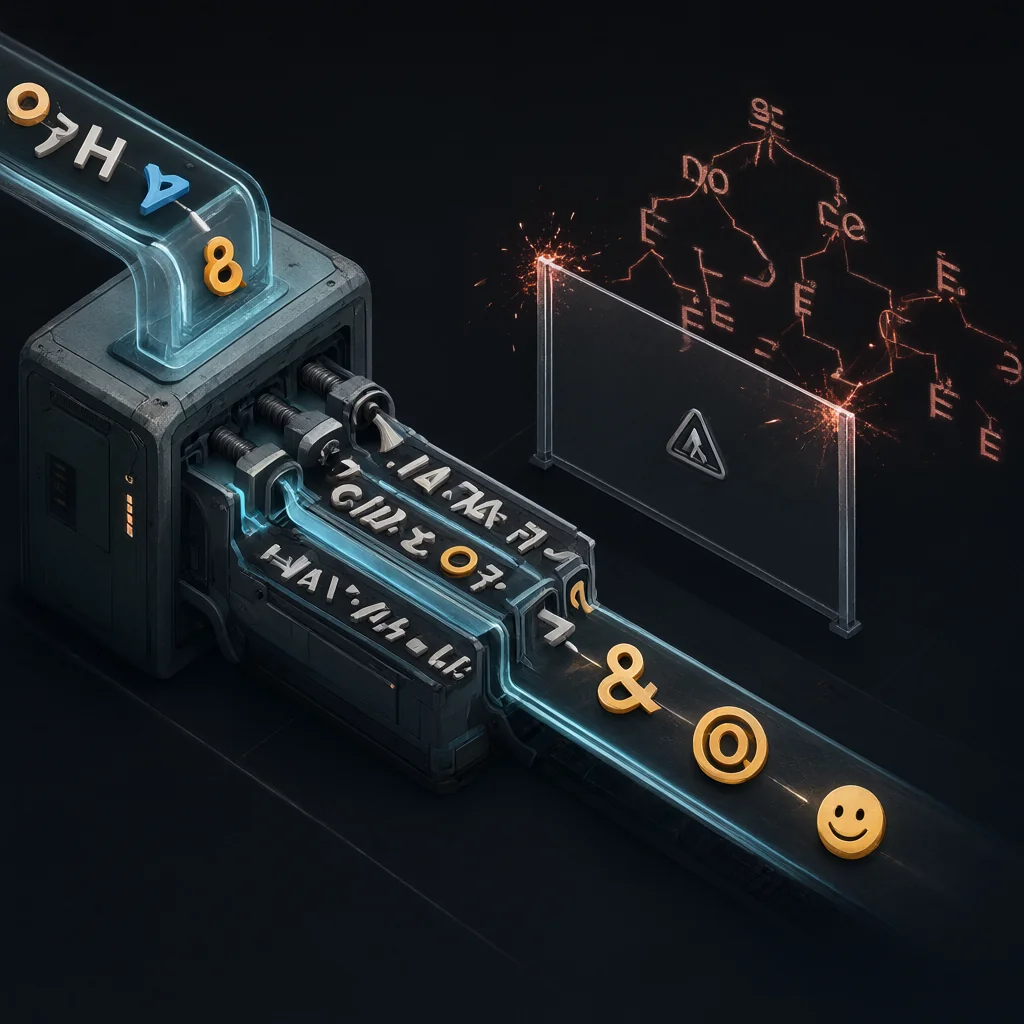
El truco popular de decodificar entidades asignándolas a internalHTML ejecuta su entrada a través del analizador HTML, que es exactamente lo que no desea. Esta publicación explica el enfoque basado en tablas más seguro y cómo maneja las referencias con nombre, decimales y hexadecimales.
El decodificador que ejecutó un <img onerror>: un caso concreto en el que 'simplemente decodificarlo' se convirtió en ejecución de script
Uso element.innerHTML decodificaciones & pero también pares HTML. Un valor como <img src=x onerror=...> puede crear un elemento y un atributo de gestor de eventos. Cuando el objetivo es sólo descifrar las referencias de caracteres, siga pegado HTML-como texto como datos en lugar de analizarlo en un DOM árbol.
Qué hace realmente InnerHTML con una cadena: análisis, creación de elementos y atributos del controlador de eventos, no solo reemplazo de entidades
internalHTML invoca el analizador HTML: las etiquetas se convierten en nodos, los atributos adquieren significado en el navegador y una lectura posterior de textContent elimina el marcado del resultado. Una etiqueta <strong> que pretendía conservar como entrada literal puede desaparecer como formato de texto. Un elemento desprendido no es una garantía de seguridad general; el código a menudo reinserta ese subárbol o usa el HTML resultante en otro lugar. Si necesita mostrar entradas que no son de confianza, asigne textContent y desinfecte solo cuando elija deliberadamente representar HTML.
El enfoque de la tabla de búsqueda: una expresión regular para &name;, &#NNN; y &#xHHH;, y un mapa de nombres a personajes
ToolAcre’s decoder utiliza una expresión regular atada para encontrar una referencia de la forma &name;, { o {. Las referencias nombradas se examinan en una tabla explícita práctica, incluyendo amp, lt, gt, citas y tipografía común. Un nombre desconocido se deja como escrito en lugar de adivinarlo. Este enfoque no crea elementos y no llama HTML parser; simplemente reemplaza subestrings reconocidos en una cadena. La mesa es deliberadamente un subconjunto, no todos HTML referencias de carácter.
Manejo de referencias numéricas: análisis de puntos de código decimal y hexadecimal y su conversión en cadenas, incluidos caracteres astrales
Para una referencia numérica, analice el decimal después de &# o el hexadecimal después de &#x, luego convierta el punto del código numérico en un carácter con String.fromCodePoint. Un valor astral como 0x1F600 produce un emoji, no dos caracteres imprimibles independientes. La implementación también asigna valores históricos de rango de control de Windows-1252 como lo hacen los navegadores; cero, los puntos de código sustituto y los valores superiores a U+10FFFF se convierten en un carácter de reemplazo. Ese manejo explícito de errores evita que un número no válido bloquee el decodificador.
Ejemplo trabajado: decodificar una cuerda que mezcla &, © y 😀 - cada partido resuelto de la tabla o del número
Decodificar la entrada literal &, © y 😀: los primeros mapas de referencia a través de la tabla llamada a " decimal 169 se convierte en ©, y hex 1F600 se convierte en 😀. Incluir una cruda <img onerror="alert(1)"> a su lado. El decodificador devuelve esa secuencia de aspecto de etiquetas como caracteres de cuerda ordinarios; no crea una imagen o ejecuta un evento. Al poner el resultado en una página real más tarde, utilice un fregadero de texto seguro en lugar de tomar la cadena decodificada y asignarlo de nuevo a la parte interna de la página.
Lo que el enfoque de tabla no hará: referencias heredadas sin punto y coma y peculiaridades de recuperación de errores del analizador, a menos que se implementen deliberadamente
El enfoque de búsqueda no reproduce intencionalmente las reglas de recuperación sin punto y coma heredadas del analizador HTML. &la copia sin punto y coma puede permanecer intacta. La tabla con nombre fijo también omite muchas de las más de dos mil referencias con nombre HTML5. Esas limitaciones son compensaciones honestas para un decodificador pequeño y predecible; aceptar sólo referencias terminadas explícitamente evita tratar la prosa arbitraria que contiene un signo comercial como marca. Verifique los nombres compatibles documentados de la herramienta si es esencial la compatibilidad total del navegador.
Lo que esto no cubre: desinfectar el HTML que pretendes renderizar, que es un problema diferente
Decodificar referencias no es desinfectar HTML para su visualización. Si el texto decodificado contiene una secuencia <script>, sigue siendo peligroso si una parte diferente de una aplicación lo inserta posteriormente como marcado. Contextos como un atributo HTML, una cadena de JavaScript y una URL necesitan cada uno su propia codificación y política de salida. ToolAcre devuelve texto; no puede hacer que un futuro fregadero inseguro sea seguro.
Conclusión: trate la entrada como datos: cómo el escape de entidad HTML se decodifica con una tabla de búsqueda en lugar del analizador HTML, para que su entrada siga siendo texto
Trata la entrada como datos. El escape de entidades HTML decodifica con una tabla y aritmética de puntos de código, no con un truco de HTML interno, por lo que las cargas útiles que buscan marcas permanecen como caracteres inertes dentro de la herramienta. Pruebe las tres referencias, luego inspeccione el texto decodificado y cómo planea usarlo a continuación: el límite de seguridad se pierde si lo analiza como HTML.