Ferramentas de desenvolvedor · HTML escapador de entidade
Decodificando entidades HTML sem innerHTML: como funciona um decodificador de tabela de consulta
· Como funciona
Publicado por ToolAcre · Revisão editorial
HTML segurança codificação
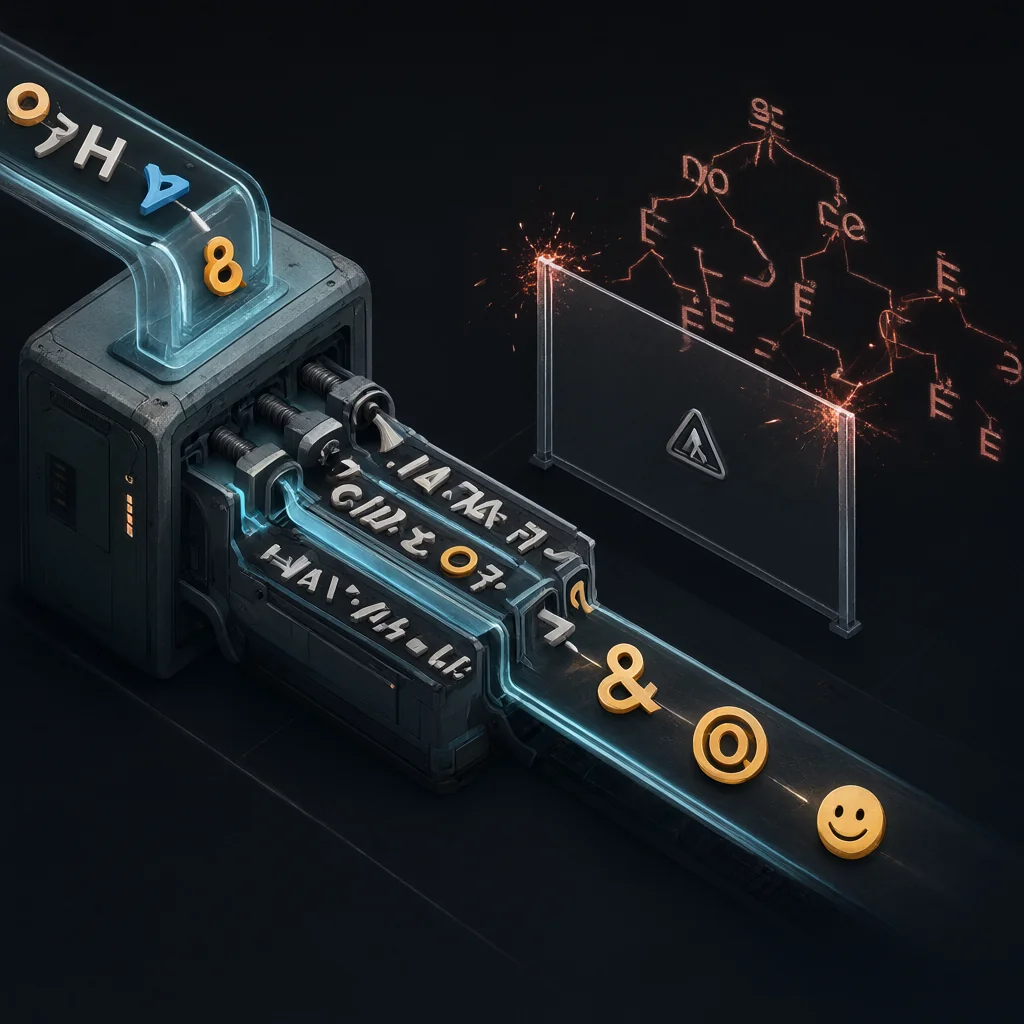
O truque popular de decodificar entidades atribuindo a innerHTML executa sua entrada por meio do analisador HTML, que é exatamente o que você não deseja. Esta postagem explica a abordagem mais segura baseada em tabela e como ela lida com referências nomeadas, decimais e hexadecimais.
O decodificador que executou um <img onerror> — um caso concreto onde 'apenas decodifique' se tornou execução de script
Utilização element.innerHTML decodificações & mas também analisa HTML. Um valor como <img src=x onerror=...> pode criar um atributo elemento e event-handler. Quando o objetivo é apenas decodificar referências de caracteres, mantenha colado HTML- como texto como dados em vez de analisá-lo em um DOM árvore.
O que o innerHTML realmente faz com uma string – análise, criação de elementos e atributos do manipulador de eventos, não apenas substituição de entidade
innerHTML invoca o analisador HTML: as tags se tornam nós, os atributos adquirem o significado do navegador e uma leitura textContent posterior remove a marcação do resultado. Uma tag <strong> que você pretendia preservar como entrada literal pode desaparecer como formatação de texto. Um elemento destacado não é uma garantia geral de segurança; o código geralmente reinsere essa subárvore ou usa o HTML resultante em outro lugar. Se você precisar exibir entradas não confiáveis, atribua textContent e sanitize somente quando você escolher deliberadamente renderizar HTML.
A abordagem da tabela de consulta — uma expressão regular para &name;, &#NNN; e &#xHHH;, e um mapa de nomes para caracteres
ToolAcreo decodificador utiliza uma expressão regular limitada para encontrar uma referência ao formulário &name;, { ou {. Referências nomeadas são pesquisadas em uma tabela explícita prática, incluindo amp, lt, gt, aspas e tipografia comum. Um nome desconhecido é deixado como escrito em vez de adivinhado. Esta abordagem não cria elementos e chama não HTML parser; ele simplesmente substitui substrings reconhecidos em uma string. A tabela é deliberadamente um subconjunto, não todos HTML referências de caracteres.
Tratamento de referências numéricas — análise de pontos de código decimais e hexadecimais e conversão deles em strings, incluindo caracteres astrais
Para uma referência numérica, analise decimal após &# ou hexadecimal após &#x e, em seguida, transforme o ponto de código numérico em um caractere com String.fromCodePoint. Um valor astral como 0x1F600 produz um emoji, não dois caracteres independentes para impressão. A implementação também mapeia valores históricos do intervalo de controle do Windows-1252 como os navegadores fazem; zero, pontos de código substitutos e valores acima de U+10FFFF tornam-se um caractere de substituição. Esse tratamento de erros explícito evita que um número inválido trave o decodificador.
Exemplo trabalhado: decodificar uma string que mistura &, © e 😀 — cada correspondência resolvida a partir da tabela ou do número
Descodificar a entrada literal &, © e 😀: o primeiro mapa de referência através da tabela nomeada para &, decimal 169 torna-se ©, e hex 1F600 torna-se . Incluir um bruto <img onerror="alert(1)"> ao lado deles. O decodificador retorna essa sequência de caracteres de texto como caracteres de string comuns; ele não cria uma imagem ou executa um evento. Ao colocar o resultado em uma página real mais tarde, use um dissipador de texto seguro em vez de pegar a string decodificada e atribuir de volta ao inerHTML.
O que a abordagem de tabela não fará — referências herdadas sem ponto e vírgula e peculiaridades de recuperação de erros do analisador, a menos que seja implementada deliberadamente
A abordagem de pesquisa intencionalmente não reproduz as regras de recuperação herdadas sem ponto e vírgula do analisador HTML. © sem ponto e vírgula pode permanecer inalterado. A tabela com nome fixo também omite muitas das mais de duas mil referências nomeadas HTML5. Essas limitações são compensações honestas para um decodificador pequeno e previsível; aceitar apenas referências terminadas explícitas evita tratar a prosa arbitrária contendo um "e" comercial como marcação. Verifique os nomes suportados documentados da ferramenta se a compatibilidade total do navegador for essencial.
O que isso não cobre – higienização de HTML que você pretende renderizar, o que é um problema diferente
A decodificação de referências não limpa HTML para exibição. Se o texto decodificado contiver uma sequência <script>, continuará sendo perigoso se uma parte diferente de um aplicativo a inserir posteriormente como marcação. Contextos como um atributo HTML, uma string JavaScript e um URL precisam cada um de sua própria codificação e política de saída. ToolAcre retorna texto; não pode tornar seguro um futuro inseguro.
Conclusão: trate a entrada como dados - como o escapador de entidade HTML decodifica com uma tabela de pesquisa em vez do analisador HTML, para que sua entrada permaneça como texto
Trate a entrada como dados. HTML o escapador de entidade é decodificado com uma tabela e aritmética de ponto de código, não um truque innerHTML, portanto, cargas úteis com aparência de marcação permanecem caracteres inertes dentro da ferramenta. Experimente as três referências e, em seguida, inspecione o texto decodificado e como você planeja usá-lo em seguida: o limite de segurança será perdido se você analisá-lo novamente como HTML.