开发者工具 · HTML 实体转义器
在没有innerHTML的情况下解码HTML实体:查找表解码器如何工作
· 工作原理
出版人: ToolAcre · 编辑审查
html 安全 编码
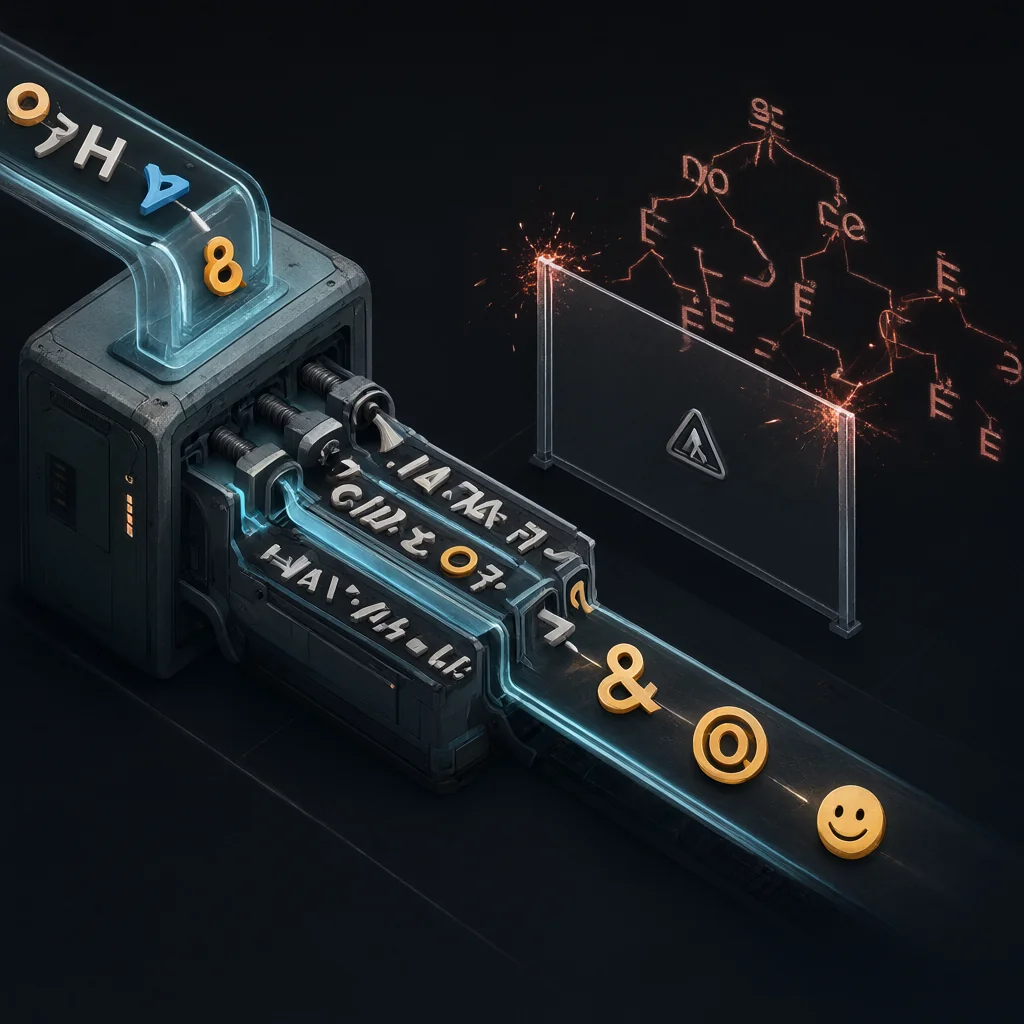
通过分配给innerHTML 来解码实体的流行技巧通过HTML 解析器运行您的输入,这正是您不想要的。这篇文章解释了更安全的基于表的方法以及它如何处理命名、十进制和十六进制引用。
执行 <img onerror> 的解码器 - 一个具体的例子,其中“只解码它”变成了脚本执行
使用 element.innerHTML 解码 & 但也进行剖析 HTML的数值,例如 <img src=x onerror=...> 可以创建元素和事件处理器属性。 当目标只是为了解码字符引用时,请粘贴 HTML- 喜欢文本作为数据而不是将其解析为 DOM 树.
innerHTML 实际上对字符串做了什么 — 解析、元素创建和事件处理程序属性,而不仅仅是实体替换
innerHTML 调用 HTML 解析器:标签成为节点,属性获取浏览器含义,稍后读取的 textContent 会从结果中去除标记。您打算保留为文字输入的 <strong> 标记可能会随着文本格式而消失。分离的元件并不能保证一般的安全;代码经常重新插入该子树或在其他地方使用生成的 HTML。如果您需要显示不受信任的输入,请仅在您故意选择呈现 HTML 时分配 textContent 并进行清理。
查找表方法 — &name;, &#NNN; 的正则表达式和 &#xHHH;,以及从名字到角色的映射
ToolAcre其解码器使用有边框的正则表达式来查找窗体的参考 &name;, { 或 单 {。命名的参考文献在实用的清晰表格中查找,包括 amp、lt、gt、引文和常用打字。 未知名被保留为正文而非猜想. 这种方法没有产生任何要素,称为 " 不 " HTML parser; 它简单地替换字符串中识别的子字符串。 表格是故意的,不是所有的 HTML 名称字符引用.
处理数字引用 - 解析十进制和十六进制代码点并将它们转换为字符串,包括星体字符
对于数字引用,解析 &# 后的十进制或 &#x 后的十六进制,然后使用 String.fromCodePoint 将数字代码点转换为字符。诸如 0x1F600 之类的星体值会产生一个表情符号,而不是两个独立的可打印字符。该实现还像浏览器一样映射历史 Windows-1252 控制范围值;零、代理代码点和 U+10FFFF 以上的值成为替换字符。这种显式的错误处理可以防止无效的数字导致解码器崩溃。
工作示例: 解码混合的字符串 &, © 财务报告和已审计财务报表 😀 —— 从表格或数字中解析出每张匹配
解码字面输入 &, © 财务报告和已审计财务报表 😀: 首个通过命名表格到小数点的参考地图( c) 169 变成"","六"1F600变成". 包含原始 <img onerror="alert(1)"> 旁边 解码器将标记外观序列作为普通字符串;它不会创建图像或执行一个事件. 稍后将结果放入真实页面时,使用安全文本槽,而不是取出解码后被分配回内HTML.
表方法不会做什么 - 遗留的无分号引用和解析器错误恢复怪癖,除非故意实现
查找方法有意不重现 HTML 解析器的旧版无分号恢复规则。不带分号的 © 可能保持不变。固定命名表还省略了两千多个 HTML5 命名引用中的许多内容。对于小型可预测解码器来说,这些限制是诚实的权衡。仅接受显式终止引用可以避免将包含&符号的任意散文视为标记。如果完整的浏览器兼容性是必要的,请检查该工具记录的支持名称。
这不包括什么 - 清理你打算渲染的 HTML,这是一个不同的问题
解码引用不会清理 HTML 以供显示。如果解码的文本包含 <script> 序列,那么如果应用程序的不同部分稍后将其作为标记插入,则仍然很危险。 HTML 属性、JavaScript 字符串和 URL 等上下文都需要自己的输出编码和策略。 ToolAcre 返回文本;它不能使未来不安全的水槽变得安全。
要点:将输入视为数据 — HTML 实体转义器如何使用查找表而不是 HTML 解析器进行解码,因此您的输入仍然是文本
将输入视为数据。 HTML 实体转义器使用表和代码点算术进行解码,而不是使用 insideHTML 技巧,因此看起来标记的有效负载在工具中仍然是惰性字符。尝试这三个引用,然后检查解码后的文本以及您接下来计划如何使用它:如果您将其重新解析为 HTML,则安全边界将会丢失。