Entwicklertools · Textvergleich
Suchen nach hinzugefügten und entfernten Einträgen zwischen zwei Listen oder Datenexporten
· Warum es wichtig ist
Text-Diff Datenbereinigung Listen
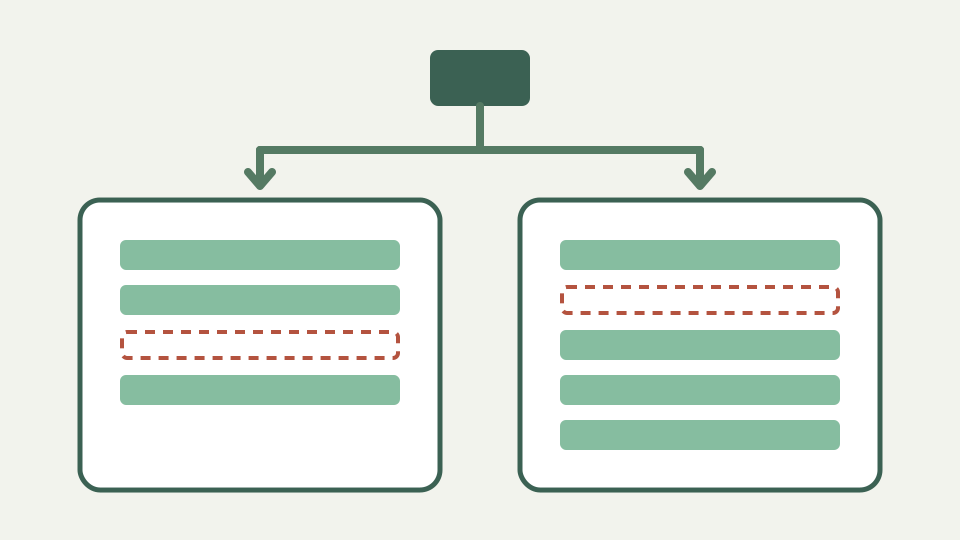
Zeigt, wie man zwei Exporte in sortierten Text mit einem Element pro Zeile umwandelt und diese vergleicht, um genau herauszufinden, welche Einträge angezeigt oder verschwunden sind.
Welche zwanzig Zeilen haben sich zwischen diesen beiden Exporten geändert? – beginnt mit dem Versöhnungsproblem
Eine Abgleichsfrage beginnt oft mit zwei Exporten und keinem nützlichen Änderungsprotokoll: Welche Einträge sind verschwunden und welche sind angekommen? Ein roher Linienunterschied kann antworten, aber nur, wenn identische Elemente ausgerichtet werden können. Unterschiedliche Sortierreihenfolgen erzeugen eher eine scheinbare Bewegung als eine klare, gruppenartige Ansicht.
Erstellen Sie Kopien, anstatt die Beweise zu ändern. Behalten Sie die ursprünglichen Exporte bei, extrahieren Sie das eine abzugleichende Feld und sortieren Sie beide Kopien mit derselben Regel. Der Vergleich meldet dann entfernte linke Zeilen und hinzugefügte rechte Zeilen um stabile gemeinsame Einträge.
Warum das Sortieren zuerst einen Diff in einen Mengenvergleich umwandelt – erklärt, dass eine identische Reihenfolge es einem Zeilendiff ermöglicht, reine Hinzufügungen und Entfernungen zu melden
Beim Sortieren werden gleiche Werte in entsprechenden Nachbarschaften platziert, sodass das geordnete LCS sie behalten kann. Ohne Sortierung kann es vorkommen, dass dasselbe Element an einer anderen Position entfernt und eingefügt erscheint, da beim Zeilenvergleich die relative Reihenfolge erhalten bleibt. Durch das Sortieren ändert sich die Frage von einer Reihenfolgenänderung hin zu einer Mitgliedschaftsänderung.
Es handelt sich immer noch nicht um eine mathematische Mengenoperation. Doppelte Zeilen bleiben doppelte Sequenzeinheiten und der Algorithmus kann Änderungen in ihrer Anzahl melden. Entscheiden Sie vor der Deduplizierung, ob Duplikate sinnvoll sind, denn wenn Sie sie während der Vorbereitung löschen, würden Beweise für wiederholte Datensätze verschwinden.
Ein Element pro Zeile, konsistente Formatierung – umfasst das Zuschneiden, die Anpassung der Groß-/Kleinschreibung und das Entfernen von Kopfzeilen, damit die Einträge ausgerichtet werden
Verwenden Sie ein Element pro Zeile und eine Darstellung pro Element. Entfernen Sie nur einen Header aus der Einweg-Vergleichskopie und notieren Sie diese Entscheidung. Durch die manuelle Anpassung von Groß- und Kleinschreibung oder Auffüllung können Unterschiede verborgen bleiben. Beginnen Sie daher mit einem genauen Vergleich und prüfen Sie die Varianten, bevor Sie Optionen anwenden.
Wenn Werte eingebettete Zeilenumbrüche oder mehrere CSV Spalten enthalten, ist der einfache Zeilenvergleich das falsche Modell. Ein CSV-fähiges Tool versteht Angebotserstellung und Aufzeichnungen. Text diff sieht nur Zeichenfolgen, die nach der Zeilenumbruchnormalisierung getrennt wurden, und kann keine tabellarischen Felder beibehalten, die durch einen Schlüssel verknüpft sind.
Arbeitsbeispiel: zwei Listen mit SKUs – sortiert beide Listen, vergleicht sie und liest drei entfernte und fünf hinzugefügte Einträge ab
Angenommen, gestern gab es die SKUs A100, B210, C300 und E900, während heute A100, C300, D450 und F800 enthalten sind. Sortieren Sie jede Liste, vergleichen Sie sie und lesen Sie B210 und E900 als Entfernungen sowie D450 und F800 als Ergänzungen. Gemeinsam genutzte Zeilen verankern den Bericht.
Überprüfen Sie die Anzahl anhand jeder Quelle, bevor Sie Maßnahmen ergreifen. Eine kopierte Teilmenge, ein gefilterter Export oder ein geänderter Header können eine Bestandsbewegung nachahmen. Der Diff identifiziert die Textzugehörigkeit in den vorbereiteten Listen; es beweist kein Lagerereignis, keine Löschanforderung oder keinen gültigen Katalogstatus.
Verwenden von Groß-/Kleinschreibung und Leerzeichen ignorieren für unordentliche Exporte – zeigt die Optionen an, die inkonsistente Groß- und Kleinschreibung und Auffüllung ohne Bearbeitung der Daten absorbieren
Groß-/Kleinschreibung ignorieren kann `sku-a` mit `SKU-A` abgleichen, und Leerzeichen ignorieren kann aufgefüllte Varianten nach dem Zuschneiden und Komprimieren abgleichen. Diese Optionen sind bei der Diagnose inkonsistenter Exporte hilfreich, können aber auch eindeutige Bezeichner verbergen, wenn Groß- und Kleinschreibung oder Abstände von Bedeutung sind.
Führen Sie jede Option separat aus und speichern Sie die strengen Ergebnisse. Wenn normalisierte Ergebnisse die Änderungsanzahl verringern, leiten Sie diese Einträge in eine Datenqualitätsprüfung weiter, anstatt sie stillschweigend als identisch zu behandeln. Die ursprünglichen Zeilen bleiben die Quelle der Wahrheit für Korrekturen.
Wenn eine Tabellenkalkulation das bessere Werkzeug ist – erkennt an, dass Suchvorgänge über mehrere Spalten hinweg eine Aufgabe für eine Tabellenkalkulation und kein Textunterschied sind
Eine Tabellenkalkulation oder Datenbank ist besser, wenn Datensätze in einem Schlüssel übereinstimmen müssen, während sich andere Spalten ändern. Es kann Zeilen verbinden, Felder vergleichen und eingegebene Werte beibehalten. Ein Zeilenunterschied kann nicht wissen, dass zwei CSV-Zeilen eine gemeinsame E-Mail-Adresse haben, obwohl ihre Zeitstempel unterschiedlich sind.
Verwenden Sie ToolAcre für eine einspaltige Liste, einen redigierten Export oder eine schnelle Überprüfung geordneter Datensätze. Wechseln Sie zum tabellenbasierten Abgleich, wenn Trennzeichen in Anführungszeichen, zusammengesetzte Schlüssel, numerische Toleranzen oder Richtlinien zur Duplikatauflösung in die Anforderung eingehen.
Was dies nicht abdeckt – das Abgleichen von Datensätzen auf einem Schlüssel, während sich andere Spalten ändern, oder das Vergleichen von CSV-Dateien als Tabellen
Dieser Workflow vergleicht CSV nicht als Tabellen, leitet keine umbenannten Einträge ab und wählt nicht aus, welche Quelle maßgeblich ist. Bei einer entfernten Zeile kann es sich um eine Löschung, eine Filteränderung oder eine Formatierungsabweichung handeln. Eine hinzugefügte Zeile kann neu, dupliziert oder lediglich anders normalisiert sein.
Außerdem wird keine Datei hochgeladen, da keine Datei akzeptiert wird. Benutzer fügen Zeichenfolgen in Editoren ein. Dieser lokale Aufrufpfad ist für redigierte Listen nützlich, aber die Betriebsrichtlinie bestimmt immer noch, ob Quelldaten in eine Browser-Registerkarte kopiert werden dürfen.
Takeaway: Sortieren, dann vergleichen – fasst die Technik zusammen und wie der Textvergleich von ToolAcre Listen im Browser verarbeitet, ohne dass etwas hochgeladen wurde
Sortieren, Duplikate bewahren, streng vergleichen und jede Normalisierung erklären. Diese vier Schritte verwandeln einen undurchsichtigen Exportunterschied in eine überprüfbare Liste, ohne das Wissen des Algorithmus zu überbewerten. Bewahren Sie das Zubereitungsrezept neben dem Ergebnis auf, damit eine andere Person es nachvollziehen kann.
Das Browser-Tool liefert Zeilennummern, Zeilentypen und Zusammenfassungszahlen. Ihr Versöhnungsprozess liefert Herkunft, Schlüsselbedeutung und Zustimmung. Wenn diese Verantwortlichkeiten getrennt bleiben, wird ein einfacher Zeilenunterschied zu einem zuverlässigen ersten Durchgang und nicht zu einer versehentlichen Datenbereinigungsrichtlinie.