开发者工具·文本比较
查找两个列表或数据导出之间添加和删除的条目
· 为什么它很重要
文本差异 数据清理 列表
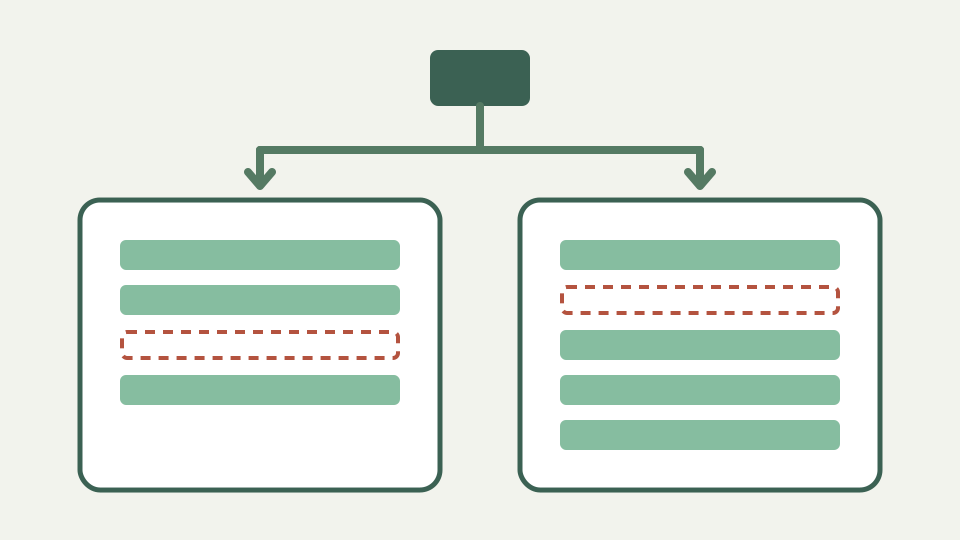
展示如何将两个导出转换为排序的、每行一项的文本,并对它们进行比较以准确找到哪些条目出现或消失。
这两个导出之间哪二十行发生了变化? ——以对账问题开头
协调问题通常以两个导出和没有有用的更改日志开始:哪些条目消失了,哪些条目到达了?原始行差异可以回答,但前提是相同的项目可以对齐。不同的排序顺序会产生明显的移动,而不是干净的类似集合的视图。
准备副本而不是更改证据。保留原始导出,提取正在协调的一个字段,并使用相同的规则对两个副本进行排序。然后比较报告在稳定共享条目周围删除的左行和添加的右行。
为什么排序首先将差异转化为集合比较 - 解释了相同的排序可以让行差异报告纯添加和删除
排序将相等的值放置在相应的邻域中,允许有序的 LCS 保留它们。如果不进行排序,不同位置的同一项目可能会出现被删除和插入的情况,因为行比较保留了相对顺序。排序将问题从顺序改变转变为成员资格改变。
它仍然不是数学集合运算。重复的行仍然是重复的序列单元,并且算法可以报告其计数的变化。在重复数据删除之前确定重复项是否有意义,因为在准备期间删除它们会删除有关重复记录的证据。
每行一个项目,格式一致 - 包括修剪、匹配大小写和删除标题以使条目对齐
每行使用一个项目,每个项目使用一个表示。仅从一次性比较副本中删除标题,并记录该决定。手动匹配大小写或填充可以隐藏差异,因此在应用选项之前首先进行严格比较并检查变体。
如果值包含嵌入的换行符或多个 CSV 列,则纯行比较是错误的模型。 CSV 感知工具可以理解引用和记录。文本差异只能看到换行规范化后分隔的字符串,并且无法保持通过键关联的表格字段。
工作示例:两个 SKU 列表 — 对两个列表进行排序、比较它们并读取三个已删除的条目和五个已添加的条目
假设昨天包含 SKU A100、B210、C300 和 E900,而今天包含 A100、C300、D450 和 F800。对每个列表进行排序、比较并读取 B210 和 E900 作为删除项,以及 D450 和 F800 作为添加项。共享行锚定报表。
在采取行动之前验证每个来源的计数。复制的子集、过滤的导出或更改的标题可以模拟库存移动。差异标识了准备好的列表中的文本成员资格;它不证明仓库事件、删除请求或有效的目录状态。
使用忽略大小写和忽略空白进行混乱的导出 — 显示在不编辑数据的情况下吸收不一致的大写和填充的选项
忽略大小写可以匹配 `sku-a` 和 `SKU-A`,忽略空白可以匹配修剪和压缩后的填充变体。这些选项有助于诊断不一致的导出,但它们也可能隐藏大小写或间距很重要的不同标识符。
单独运行每个选项并保存严格的结果。如果标准化结果减少了更改计数,请将这些条目路由到数据质量审核中,而不是默默地将它们视为相同。原始行仍然是纠正的真实来源。
当电子表格是更好的工具时 - 承认跨多列的查找是电子表格的工作,而不是文本差异
当记录必须在一个键上匹配而其他列发生变化时,电子表格或数据库会更好。它可以连接行、比较字段并保留键入的值。行差异无法知道两个 CSV 行共享一封电子邮件,但它们的时间戳不同。
使用 ToolAcre 进行单列列表、编辑导出或快速检查有序记录。当引用分隔符、复合键、数字容差或重复解决策略满足要求时,转向表感知协调。
这不包括什么 - 在其他列更改时匹配键上的记录,或者将 CSV 文件作为表进行比较
此工作流不会将 CSV 作为表进行比较、推断重命名的条目或选择哪个来源是权威的。删除的行可能是删除、过滤器更改或格式不匹配。添加的行可能是新的、重复的或只是以不同的方式标准化。
它也不会上传文件,因为它不接受文件;用户将字符串粘贴到编辑器中。该本地调用路径对于编辑列表很有用,但操作策略仍然决定是否可以将源数据复制到浏览器选项卡中。
要点:排序,然后比较 — 总结该技术以及 ToolAcre 的文本比较如何在没有上传任何内容的情况下处理浏览器中的列表
排序、保留重复项、严格比较并解释每个标准化。这四个步骤将不透明的导出差异转换为可审查的列表,而不会夸大算法所知道的内容。将制备配方放在结果旁边,以便其他人可以重现它。
浏览器工具提供行号、行类型和汇总计数。您的协调过程提供出处、关键含义和批准。当这些职责保持独立时,简单的行差异就成为可靠的第一遍,而不是意外的数据清理策略。