डेवलपर टूल · पाठ तुलना
दो सूचियों या डेटा निर्यातों के बीच जोड़ी गई और हटाई गई प्रविष्टियाँ ढूँढना
· यह क्यों मायने रखती है
पाठ-अंतर डेटा-सफाई सूचियों
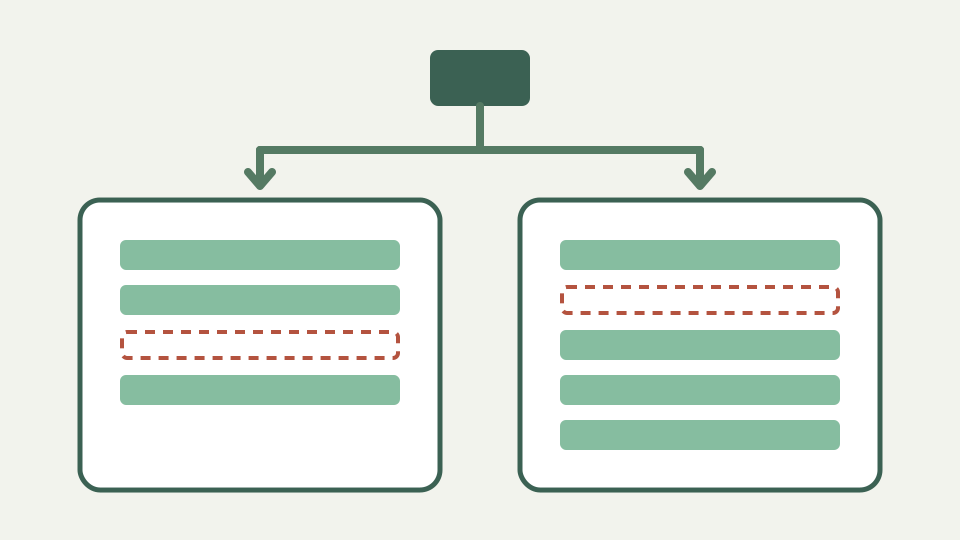
दिखाता है कि कैसे दो निर्यातों को क्रमबद्ध, एक-आइटम-प्रति-पंक्ति पाठ में बदला जाए और उनकी तुलना करके पता लगाया जाए कि वास्तव में कौन सी प्रविष्टियाँ दिखाई दीं या गायब हो गईं।
इन दोनों निर्यातों के बीच कौन सी बीस पंक्तियाँ बदल गईं? - समाधान समस्या के साथ खुलता है
एक समाधान प्रश्न अक्सर दो निर्यातों से शुरू होता है और कोई उपयोगी परिवर्तन लॉग नहीं होता है: कौन सी प्रविष्टियाँ गायब हो गईं, और कौन सी आ गईं? एक अपरिष्कृत रेखा अंतर उत्तर दे सकता है, लेकिन केवल तभी जब समान आइटम संरेखित हो सकते हैं। अलग-अलग सॉर्ट ऑर्डर एक साफ़ सेट-जैसे दृश्य के बजाय स्पष्ट आंदोलन बनाते हैं।
सबूतों में बदलाव करने के बजाय प्रतियां तैयार करें। मूल निर्यात को सुरक्षित रखें, मिलान किए जा रहे एक फ़ील्ड को निकालें, और दोनों प्रतियों को एक ही नियम से क्रमबद्ध करें। तुलना के बाद रिपोर्ट में बाईं पंक्तियों को हटा दिया गया और स्थिर साझा प्रविष्टियों के आसपास दाईं पंक्तियों को जोड़ दिया गया।
क्यों पहले क्रमबद्ध करना एक अंतर को एक सेट तुलना में बदल देता है - बताता है कि समान क्रम एक पंक्ति अंतर को शुद्ध परिवर्धन और निष्कासन की रिपोर्ट करने देता है
सॉर्टिंग संबंधित पड़ोस में समान मान रखता है, जिससे आदेशित LCS को उन्हें बनाए रखने की अनुमति मिलती है। छँटाई के बिना, एक अलग स्थिति में एक ही आइटम हटाया और डाला हुआ दिखाई दे सकता है क्योंकि लाइन तुलना सापेक्ष क्रम को सुरक्षित रखती है। क्रमबद्ध करने से प्रश्न अनुक्रम परिवर्तन से सदस्यता परिवर्तन की ओर बदल जाता है।
यह अभी भी गणितीय सेट ऑपरेशन नहीं है। डुप्लिकेट लाइनें डुप्लिकेट अनुक्रम इकाइयां बनी रहती हैं, और एल्गोरिदम उनकी गिनती में बदलाव की रिपोर्ट कर सकता है। डिडुप्लिकेट करने से पहले तय करें कि डुप्लिकेट सार्थक हैं या नहीं, क्योंकि तैयारी के दौरान उन्हें हटाने से बार-बार रिकॉर्ड किए जाने के बारे में सबूत निकल जाएंगे।
प्रति पंक्ति एक आइटम, सुसंगत स्वरूपण - ट्रिमिंग, मिलान केस और हेडर को हटाना शामिल है ताकि प्रविष्टियाँ पंक्तिबद्ध हो जाएँ
प्रति पंक्ति एक आइटम और प्रति आइटम एक प्रतिनिधित्व का उपयोग करें। केवल डिस्पोजेबल तुलना कॉपी से हेडर हटाएं और उस निर्णय को रिकॉर्ड करें। केस का मिलान या मैन्युअल रूप से पैडिंग करने से अंतर छिप सकते हैं, इसलिए सख्त तुलना से शुरुआत करें और विकल्पों को लागू करने से पहले वेरिएंट का निरीक्षण करें।
यदि मानों में एम्बेडेड नई लाइनें या कई CSV कॉलम हैं, तो सादा रेखा तुलना गलत मॉडल है। एक CSV-जागरूक टूल उद्धरण और रिकॉर्ड को समझता है। टेक्स्ट डिफ केवल न्यूलाइन सामान्यीकरण के बाद अलग किए गए स्ट्रिंग्स को देखता है और एक कुंजी से जुड़े सारणीबद्ध फ़ील्ड को नहीं रख सकता है।
कार्यान्वित उदाहरण: SKU की दो सूचियाँ - दोनों सूचियों को क्रमबद्ध करती हैं, उनकी तुलना करती हैं और तीन हटाई गई और पाँच जोड़ी गई प्रविष्टियों को पढ़ती हैं
मान लीजिए कि कल में SKU A100, B210, C300 और E900 शामिल हैं, जबकि आज में A100, C300, D450 और F800 शामिल हैं। प्रत्येक सूची को क्रमबद्ध करें, तुलना करें, और B210 और E900 को निष्कासन के रूप में और D450 और F800 को अतिरिक्त के रूप में पढ़ें। साझा पंक्तियाँ रिपोर्ट को एंकर करती हैं।
कार्रवाई करने से पहले प्रत्येक स्रोत के विरुद्ध गिनती सत्यापित करें। एक कॉपी किया गया सबसेट, फ़िल्टर किया गया निर्यात या बदला हुआ हेडर इन्वेंट्री मूवमेंट की नकल कर सकता है। अंतर तैयार सूचियों में पाठ्य सदस्यता की पहचान करता है; यह वेयरहाउस ईवेंट, विलोपन अनुरोध या वैध कैटलॉग स्थिति साबित नहीं करता है।
अव्यवस्थित निर्यात के लिए इग्नोर-केस और इग्नोर-व्हाट्सएप का उपयोग करना - डेटा को संपादित किए बिना असंगत पूंजीकरण और पैडिंग को अवशोषित करने वाले विकल्प दिखाता है
इग्नोर केस `sku-a` को `SKU-A` से मेल कर सकता है, और इग्नोर व्हाइटस्पेस ट्रिमिंग और कंडेंसिंग के बाद पैडेड वेरिएंट से मेल खा सकता है। वे विकल्प असंगत निर्यातों का निदान करने में सहायक होते हैं, लेकिन वे विशिष्ट पहचानकर्ताओं को भी छिपा सकते हैं जहां मामला या रिक्ति महत्वपूर्ण है।
प्रत्येक विकल्प को अलग से चलाएँ और सख्त निष्कर्षों को सहेजें। यदि सामान्यीकृत परिणाम परिवर्तन की संख्या को कम करते हैं, तो उन प्रविष्टियों को चुपचाप समान मानने के बजाय उन्हें डेटा-गुणवत्ता समीक्षा में रूट करें। मूल पंक्तियाँ सुधार के लिए सत्य का स्रोत बनी हुई हैं।
जब एक स्प्रेडशीट बेहतर टूल है - यह स्वीकार करता है कि कई कॉलमों में लुकअप एक स्प्रेडशीट के लिए एक काम है, न कि टेक्स्ट अंतर
एक स्प्रेडशीट या डेटाबेस तब बेहतर होता है जब रिकॉर्ड एक कुंजी पर मेल खाने चाहिए जबकि अन्य कॉलम बदलते हैं। यह पंक्तियों को जोड़ सकता है, फ़ील्ड की तुलना कर सकता है और टाइप किए गए मानों को संरक्षित कर सकता है। एक पंक्ति अंतर यह नहीं जान सकता कि दो CSV पंक्तियाँ एक ईमेल साझा करती हैं जबकि उनके टाइमस्टैम्प भिन्न होते हैं।
एकल-स्तंभ सूची, संशोधित निर्यात या ऑर्डर किए गए रिकॉर्ड की त्वरित जांच के लिए ToolAcre का उपयोग करें। जब उद्धृत सीमांकक, समग्र कुंजी, संख्यात्मक सहनशीलता या डुप्लिकेट-रिज़ॉल्यूशन नीतियां आवश्यकता दर्ज करती हैं तो तालिका-जागरूक समाधान पर जाएं।
इसमें क्या शामिल नहीं है - अन्य कॉलम बदलते समय कुंजी पर रिकॉर्ड का मिलान करना, या CSV फ़ाइलों की तालिकाओं के रूप में तुलना करना
यह वर्कफ़्लो तालिकाओं के रूप में CSV की तुलना नहीं करता है, नामांकित प्रविष्टियों का अनुमान नहीं लगाता है या यह नहीं चुनता है कि कौन सा स्रोत आधिकारिक है। हटाई गई पंक्ति विलोपन, फ़िल्टर परिवर्तन या स्वरूपण बेमेल हो सकती है। एक जोड़ी गई पंक्ति नई, डुप्लिकेट या केवल अलग तरीके से सामान्यीकृत हो सकती है।
यह किसी फ़ाइल को अपलोड भी नहीं करता क्योंकि यह किसी फ़ाइल को स्वीकार नहीं करता; उपयोगकर्ता एडिटर में स्ट्रिंग चिपकाते हैं। वह स्थानीय कॉल पथ संशोधित सूचियों के लिए उपयोगी है, लेकिन परिचालन नीति अभी भी यह निर्धारित करती है कि स्रोत डेटा को ब्राउज़र टैब में कॉपी किया जा सकता है या नहीं।
टेकअवे: क्रमबद्ध करें, फिर तुलना करें - तकनीक का सारांश देता है और कैसे ToolAcre की टेक्स्ट तुलना ब्राउज़र में सूचियों को बिना कुछ अपलोड किए संभालती है
क्रमबद्ध करें, डुप्लिकेट को सुरक्षित रखें, सख्ती से तुलना करें और प्रत्येक सामान्यीकरण की व्याख्या करें। वे चार चरण एक अपारदर्शी निर्यात अंतर को एल्गोरिथम के ज्ञान को बढ़ा-चढ़ाकर बताए बिना एक समीक्षा योग्य सूची में बदल देते हैं। परिणाम के बगल में तैयारी का नुस्खा रखें ताकि कोई अन्य व्यक्ति इसे पुन: पेश कर सके।
ब्राउज़र टूल पंक्ति संख्या, पंक्ति प्रकार और सारांश गणना प्रदान करता है। आपकी सुलह प्रक्रिया उद्गम, मुख्य अर्थ और अनुमोदन प्रदान करती है। जब वे ज़िम्मेदारियाँ अलग रहती हैं, तो एक सरल रेखा अंतर एक आकस्मिक डेटा-सफाई नीति के बजाय एक विश्वसनीय पहला पास बन जाता है।