डेवलपर टूल · Base64 एनकोडर और डिकोडर
Base64 बनाम Base64url: एक मानक डिकोडर अस्वीकार क्यों करता है - और _
· यह काम किस प्रकार करता है
Base64 एन्कोडिंग डेवलपर-वर्कफ़्लो
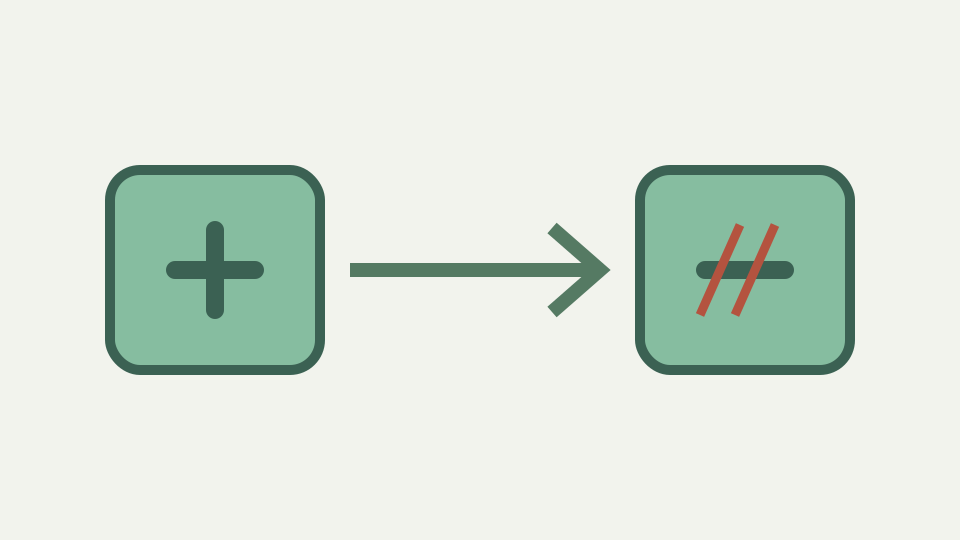
Base64url + और / के लिए - और _ को स्वैप करता है ताकि आउटपुट बिना भागे URL और फ़ाइल नामों में यात्रा कर सके। यह पोस्ट दो अक्षरों के बारे में बताती है, उनके बीच कैसे रूपांतरण करें और पैडिंग को आमतौर पर क्यों हटा दिया जाता है।
वह टोकन जो आपके कोड को छोड़कर हर जगह डिकोड करता है - एक अमान्य-वर्ण त्रुटि जो एकल - या _ के कारण होती है
एक JWT खंड अमान्य वर्ण त्रुटि नामकरण डैश के साथ मानक Base64 डिकोडर में डिकोड करने में विफल रहता है। लेकिन देखने में कोई डैश दिखाई नहीं देता। फिर से देखो—ऐसा होता है। Base64url संस्करण का उपयोग करता है - जहां मानक Base64 + का उपयोग करता है, और _ जहां यह /. का उपयोग करता है कई डिकोडर केवल एक वर्णमाला स्वीकार करते हैं, और URL सुरक्षा के लिए एन्कोड किए गए टोकन को RFC 4648 मानक Base64 की अपेक्षा वाले कोड द्वारा अस्वीकार कर दिया जाएगा।
दोनों अक्षर समतुल्य हैं; उनके बीच रूपांतरण यांत्रिक चरित्र प्रतिस्थापन है। समस्या इसलिए उत्पन्न होती है क्योंकि URL में + और / का अर्थ होता है। प्लस चिह्न एप्लिकेशन/x-www-form-urlencoded फॉर्म डेटा में स्थान दर्शाता है। फ़ॉरवर्ड स्लैश URL में पथ विभाजक है। यदि आप Base64 को प्रतिशत-एन्कोडिंग के बिना सीधे URL क्वेरी पैरामीटर में एम्बेड करते हैं + और /, डिकोडर उनकी गलत व्याख्या कर सकता है।
URL और फ़ाइल नामों में + और / एक समस्या क्यों हैं - पथों में / का आरक्षित अर्थ और फॉर्म डेटा में एक स्थान के रूप में + का
डिकोडर तक पहुंचने से पहले A+ को स्पेस के रूप में पढ़ा जा सकता है। ए/पैरामीटर मान को गलत स्थान पर विभाजित कर सकता है। RFC 4648 अनुभाग 5 अस्पष्टता को खत्म करने के लिए Base64url वर्णमाला को परिभाषित करता है: + के बजाय - और /, के बजाय _ का उपयोग करें ताकि URL और फ़ाइल नामों में आउटपुट सुरक्षित रहे। दो अक्षरों को छोड़कर बाकी दोनों अक्षर समान हैं।
मानक Base64 62 और 63 पदों पर वर्णों का उपयोग करता है: A–Z (0–25), a–z (26–51), 0–9 (52–61), + (62), / (63)। Base64url A–Z (0–25), a–z (26–51), 0–9 (52–61) का उपयोग करता है, - (62), _ (63). बाकी सब कुछ - बिट रीग्रुपिंग, पैडिंग नियम, इंडेक्स में बिट्स मैपिंग - समान है। मानक Base64 के लिए सूचकांकों की स्ट्रिंग Base64url के लिए सूचकांकों की स्ट्रिंग का उत्पादन करेगी; केवल 62 और 63 पदों पर वर्ण भिन्न होंगे।
RFC 4648 अनुभाग 5 से Base64url वर्णमाला - दो प्रतिस्थापित वर्ण और अन्य कुछ क्यों नहीं बदलता है
यदि इनपुट में कोई सूचकांक 62 या 63 (मानक में कोई + या / नहीं, Base64url में नहीं - या _) शामिल है, तो दोनों अक्षर समान आउटपुट उत्पन्न करते हैं। मानक Base64 को Base64url में परिवर्तित करना सीधा-सीधा ढूंढना और बदलना है: स्वैप + फॉर - और / फॉर _। मानक Base64 में Base64url स्ट्रिंग को डिकोड करने के लिए रिवर्स की आवश्यकता होती है: स्वैप - + के लिए और _ के लिए /.
रूपांतरण सममित और सदैव वैध होता है। यदि आपको ऐसे टोकन का सामना करना पड़ता है जो अमान्य-वर्ण त्रुटि नामकरण - या _ के साथ डिकोडिंग में विफल रहता है, तो जांचें कि डिकोडर Base64url को स्वीकार करता है या नहीं। यदि नहीं, तो वर्ण प्रतिस्थापन लागू करें, और यदि इनपुट अन्यथा सुव्यवस्थित है, तो डिकोडिंग सफल होनी चाहिए। JWT हेडर {"alg":"HS256","typ":"JWT"} को Base64url के रूप में एन्कोड करने पर विचार करें। मानक UTF-8 बाइट्स बिट रीग्रुपिंग से गुजरते हैं: तीन बाइट्स चार सूचकांक बन जाते हैं, जिन्हें Base64url वर्णमाला में देखा जाता है। ToolAcre पैडिंग को वर्णमाला टॉगल से बांधने के बजाय एक एनकोडर विकल्प के रूप में उजागर करता है। वह पृथक्करण उपयोगी साक्ष्य है: URL-सुरक्षित आउटपुट पैडेड या अनपैडेड हो सकता है, जबकि डिकोडर ब्राउज़र प्रिमिटिव को कॉल करने से पहले किसी भी फॉर्म को सामान्य कर देता है। वर्णमाला और पैडिंग संबंधित परंपराएं हैं, एक स्विच नहीं।
Base64url में पैडिंग परंपरा के अनुसार वैकल्पिक है - जेडब्ल्यूटी = को क्यों नहीं छोड़ते हैं और एक डिकोडर इसे लंबाई से कैसे पुनर्स्थापित कर सकता है
जब इंडेक्स 62 होता है, तो आउटपुट कैरेक्टर - होता है; जब 63, आउटपुट _ होता है। मानक वर्णमाला के माध्यम से समान बाइट्स सूचकांक 62 पर + और सूचकांक 63 पर उत्पन्न होंगे। Base64url परिणाम को मानक में परिवर्तित करना चरित्र-दर-चरित्र ऑपरेशन है: - के लिए स्कैन करें और + से बदलें, _ के लिए स्कैन करें और /, से बदलें, फिर हमेशा की तरह डीकोड करें।
आपके द्वारा पुनर्प्राप्त बाइट्स समान हैं क्योंकि सूचकांक समान थे; केवल प्रतीक भिन्न हैं। Base64url में पैडिंग परंपरा के अनुसार वैकल्पिक है, भले ही मानक इसकी अनुमति देता हो। JWT को बिंदुओं से जुड़े तीन Base64url खंडों के रूप में संरचित किया गया है; यदि आवश्यक हो तो प्रत्येक खंड पैडिंग का उपयोग करता है, लेकिन कई कार्यान्वयन इसे छोड़ देते हैं और इस तथ्य पर भरोसा करते हैं कि उपभोग करने वाला एप्लिकेशन अपेक्षित बाइट लंबाई जानता है।
व्यावहारिक उदाहरण: JWT हेडर सेगमेंट को मानक Base64 में परिवर्तित करना - वर्णों को बदलना, पैडिंग जोड़ना, JSON में डिकोड करना
एक डिकोडर स्ट्रिंग की लंबाई को चार से विभाजित करके, शेष की गणना करके, 0, 1, या 2 को बराबर चिह्न जोड़कर लापता पैडिंग को पुनर्स्थापित कर सकता है। यदि स्ट्रिंग की लंबाई चार से अधिक नहीं है, तो गायब पैडिंग स्पष्ट है। यदि लंबाई चार से अधिक है, तो स्ट्रिंग या तो पैडेड थी, फिर पैडिंग हटा दी गई, या इनपुट पहले से ही चार बाइट्स का मल्टीपल था (अंतिम ब्लॉक में तीन बाइट्स के साथ समाप्त होता है, पैडिंग की आवश्यकता नहीं होती है)।
Base64url खंडों को जोड़ने के लिए पैडिंग पर ध्यान देने की आवश्यकता है। यदि तीन खंड प्रत्येक = के साथ समाप्त होते हैं, तो सीधे संयोजित करने से AAAA=BBBB=CCCC= जैसी स्ट्रिंग्स उत्पन्न होती हैं, जहां बीच में पैडिंग अब भटके हुए अक्षर हैं, न कि अंतिम मार्कर। यही कारण है कि JWTs प्रत्येक खंड में पैडिंग को छोड़ देते हैं: तीन-खंड संरचना स्पष्ट है, इसलिए डिकोडिंग प्रत्येक भाग पर स्वतंत्र रूप से आगे बढ़ती है, और संयोजित स्ट्रिंग के बीच में पैडिंग अनावश्यक है और पार्सिंग को तोड़ देगी।
सामान्य गलतियाँ - अक्षरों को एक स्ट्रिंग में मिलाना, या Base64url का उपयोग करने के बजाय प्रतिशत-एन्कोडिंग मानक Base64
यदि मल्टी-सेगमेंट पेलोड का निर्माण कर रहे हैं, तो प्रारंभ में पैडिंग कन्वेंशन पर निर्णय लें: या तो प्रत्येक सेगमेंट में शामिल करें और कभी भी सीधे संयोजित न करें, या केवल डिकोडिंग के समय लंबाई से हटा दें और पुनर्स्थापित करें। RFC 4648 मानक दोनों अक्षरों पर अधिकार रखता है। अनुभाग 4 मानक Base64 निर्दिष्ट करता है; अनुभाग 5 Base64url निर्दिष्ट करता है। प्रत्येक अनुरूप डिकोडर को स्पष्ट रूप से बताना चाहिए कि वह किस वर्णमाला को स्वीकार करता है।
कोड Base64url स्वीकार कर रहा है लेकिन मानक Base64 नहीं (या इसके विपरीत) केवल सबसेट लागू कर रहा है। Base64url वर्णमाला URL और फ़ाइल नाम बाधाओं के साथ संगतता के लिए मौजूद है; यह सुधार या प्रतिस्थापन नहीं है, केवल विशिष्ट संदर्भ के लिए भिन्न है। जब आप API या टोकन प्रारूप लिखते हैं, तो एक वर्णमाला चुनें और कौन सा दस्तावेज़ चुनें। एक सामान्य गलती Base64url का उपयोग करने के बजाय प्रतिशत-एन्कोडिंग मानक Base64 है। कार्यान्वयन लेख सीमा की भी व्याख्या करता है। यह डिकोडिंग से पहले हाइफ़न और अंडरस्कोर को सामान्य करता है, लेकिन यह टोकन हस्ताक्षर को सत्यापित नहीं करता है या दावों की व्याख्या नहीं करता है। JWT खंड को बाइट्स में परिवर्तित करने से JSON प्रकट हो सकता है; यह स्थापित नहीं कर सकता कि JSON किसने जारी किया या क्या किसी ने इसे बदला।
इसमें क्या शामिल नहीं है - JWT हस्ताक्षर, आधार32 और अन्य RFC 4648 एन्कोडिंग का सत्यापन
%2B + के लिए प्रतिशत कोड है; %2F /. के लिए प्रतिशत कोड है। प्रतिशत-एन्कोडिंग TWFu को TWFu में अपरिवर्तित (कोई विशेष वर्ण नहीं) में बदल देती है, लेकिन TE9S+g== को TE9S%2Bg%3D%3D (संभालने के लिए बहुत सारे वर्ण) में बदल देती है। सही समाधान Base64url का उपयोग करना है, जो पहले से ही URL-सुरक्षित आउटपुट उत्पन्न करता है। प्रतिशत-एन्कोडिंग Base64 अनावश्यक और बेकार है। संदर्भ के लिए सही वर्णमाला का प्रयोग करें. Base64 एनकोडर और डिकोडर दोनों अक्षरों को स्वचालित रूप से स्वीकार करता है।
यदि आप - युक्त स्ट्रिंग पेस्ट करते हैं, तो यह इसे Base64url के रूप में मानता है; यदि पेस्ट स्ट्रिंग में + है, तो यह इसे मानक Base64 के रूप में मानता है। टूल URL भी स्वीकार करता है और उन्हें URL-सुरक्षित इनपुट मानता है। इसलिए एक व्यावहारिक जांच के दो स्वतंत्र परिणाम होते हैं: बाइट्स राउंड-ट्रिप, और चुना गया प्रतिनिधित्व उसके चैनल में फिट बैठता है। पहले को पारित करना कहता है कि परिवर्तन प्रतिवर्ती है। दूसरे को पास करने पर कहा गया है कि विराम चिह्न और पैडिंग को URL, फ़ाइल नाम, कुकी या इसे ले जाने वाले प्रोटोकॉल द्वारा दोबारा नहीं लिखा जाएगा।
टेकअवे: दो अक्षर, एक बिट लेआउट - Base64 एनकोडर और डिकोडर ब्राउज़र में मानक वर्णमाला को कैसे संभालता है, और इसका टूल पेज कहां बताता है कि यह क्या स्वीकार करता है
जब JWT सेगमेंट या URL-सुरक्षित टोकन को डीकोड किया जाता है, तो आप रूपांतरण के बिना सीधे पेस्ट कर सकते हैं, और टूल संदर्भ से वर्णमाला की पहचान करता है। विफल डिकोड को डीबग करना सरल हो जाता है: टोकन पेस्ट करें, देखें कि क्या टूल इसे स्वीकार करता है, और यदि नहीं, तो मैन्युअल रूप से वर्णों को स्वैप करें और पुनः प्रयास करें।
प्रतिस्थापन स्वयं कोड की एक पंक्ति है, लेकिन एक असफल डिकोड असंभव लंबाई, गलत पैडिंग, भ्रष्टाचार या गैर-Base64 इनपुट से भी आ सकता है। टूल स्वचालित रूप से दोनों अक्षरों को सामान्य कर देता है, इसलिए स्वीकृति केवल यह पुष्टि करती है कि बाइट्स पुनर्प्राप्त किए जा सकते हैं। एक डिकोड किया गया JWT पेलोड अभी भी एक अहस्ताक्षरित दावा है जब तक कि एक अलग सत्यापनकर्ता उसके हस्ताक्षर और अपेक्षित एल्गोरिदम की जांच नहीं करता है।