डेवलपर टूल · Base64 एनकोडर और डिकोडर
कैसे Base64 चरण दर चरण तीन बाइट्स को चार वर्णों में बदल देता है
· यह काम किस प्रकार करता है
Base64 एन्कोडिंग यूनिकोड
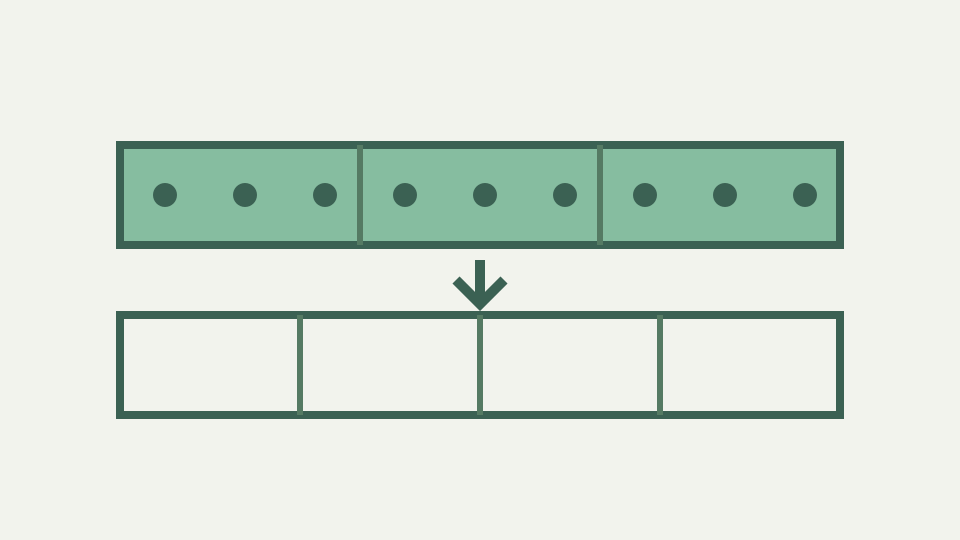
Base64 बिट्स को पुनः समूहीकृत करने से अधिक कुछ नहीं है: 24 bits इन, चार 6-बिट इंडेक्स बाहर। यह पोस्ट टेबल लुकअप, बिट शिफ्टिंग और रिवर्स ट्रिप के माध्यम से चलती है ताकि प्रारूप ब्लैक बॉक्स बनना बंद हो जाए।
स्ट्रिंग 'TWFu' और वह शब्द जो इसे छिपाता है - एक वास्तविक चार-अक्षर वाले ब्लॉक से शुरू करना और पूछना कि प्रत्येक अक्षर कहाँ से आया है
चार-अक्षर Base64 स्ट्रिंग TWFu तीन-बाइट अनुक्रम मैन को डिकोड करता है। तीन बाइट्स चार अक्षर कैसे बन जाते हैं, इससे पता चलता है कि Base64 एन्क्रिप्शन या संपीड़न नहीं है, बल्कि शुद्ध बिट रीग्रुपिंग है। एक बार जब आप बिट लेआउट देख लेते हैं, तो Base64 आउटपुट अपारदर्शी होना बंद हो जाता है और पूर्वानुमानित हो जाता है। आप मैन को हाथ से एन्कोड कर सकते हैं, इसे TWFu के विरुद्ध सत्यापित कर सकते हैं, और समझ सकते हैं कि Base64 हमेशा इनपुट के तीन बाइट्स में चार अक्षर क्यों आउटपुट करता है।
Base64 का जादू यह है कि तीन बाइट्स (24 bits) छह बिट्स के चार टुकड़ों में पूरी तरह से पुन: एकत्रित हो जाते हैं। छह बिट्स 0 से 63 का प्रतिनिधित्व करते हैं, यही कारण है कि वर्णमाला में बिल्कुल 64 प्रतीक होते हैं: A–Z (26), a–z (26), 0–9 (10), और + और / (2). प्रत्येक छह-बिट खंड एक आउटपुट कैरेक्टर उत्पन्न करने के लिए वर्णमाला में अनुक्रमित होता है। रिवर्स भी समान रूप से साफ है: चार छह-बिट खंडों को पुनर्प्राप्त करने के लिए चार वर्णों को वर्णमाला में अनुक्रमित किया जाता है, जो तीन बाइट्स में पुन: एकत्रित हो जाते हैं।
बाइट्स से 6-बिट इंडेक्स तक - कैसे 24 bits को चार समूहों में विभाजित किया जाता है और क्यों 64 प्रतीक बिल्कुल पर्याप्त हैं
यही कारण है कि Base64 हर जगह स्वाभाविक लगता है। ASCII में तीन बाइट्स M, a, n लें: 0x4D, 0x61, 0x6E। बाइनरी में लिखें: 01001101, 01100001, 01101110। सभी 24 bits को जोड़ें: 010011010110000101101110। छह बिट्स के चार हिस्सों में पुनः समूहित करें: 010011 010110 000101 101110। बाइनरी संख्याओं के रूप में व्याख्या करें: 19, 22, 5, 46। Base64 वर्णमाला में अनुक्रमणिका (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). सूचकांक 19 T है, सूचकांक 22 W है, सूचकांक 5 F है, सूचकांक 46 u है।
आउटपुट: TWFu. सूचकांक लुकअप यांत्रिक है. Base64 वर्णमाला अनुक्रम है जहां स्थिति मायने रखती है: प्रत्येक कार्यान्वयन एक ही क्रम का उपयोग करता है A-Z, a-z, 0–9, +, /. अलग-अलग क्रम अलग आउटपुट उत्पन्न करता है; क्रम बदलना ठीक उसी तरह है जैसे Base64url काम करता है। मानक वर्णमाला में, बड़े अक्षरों में सूचकांक 0–25, छोटे अक्षर 26–51, अंक 52–61, विशेष वर्ण 62–63 होते हैं। यह आदेश मनमाना है लेकिन RFC द्वारा तय किया गया है; प्रत्येक डिकोडर समान मैपिंग की अपेक्षा करता है।
वर्णमाला तालिका और सूचकांक लुकअप - A–Z, a–z, 0–9, + और / क्रम में, और तुलना के लिए क्रम क्यों मायने रखता है
यदि आप कागज पर वर्णमाला लिखते हैं और ध्यान से गिनते हैं, तो आप कंप्यूटर के बिना मैन्युअल रूप से एनकोड कर सकते हैं: 19 देखें, A B C...T गिनें, T लिखें, दोहराएं। उलटना भी उतना ही सीधा है। TWFu को देखते हुए, वर्णमाला में प्रत्येक वर्ण को देखें: T है 19, W है 22, F है 5, u है 46। बाइनरी में कन्वर्ट करें (छह बिट्स के लिए अग्रणी शून्य): 010011, 010110, 000101, 101110। संयोजित: 010011010110000101101110.
आठ बिट्स के तीन बाइट्स में समूहित करें: 01001101, 01100001, 01101110। दशमलव या हेक्स के रूप में व्याख्या करें: 77, 97, 110 या 0x4D, 0x61, 0x6E। ASCII में कन्वर्ट करें: एम, ए, एन। आपने मूल तीन बाइट्स पुनः प्राप्त कर लिए हैं। यही कारण है कि Base64 प्रतिवर्ती है और पैडिंग केवल तीन से विभाज्य न होने वाले इनपुट के लिए आवश्यक क्यों हो जाती है। Base64 सटीक बाइट्स को एन्कोड करता है और इससे अधिक कुछ नहीं। एन्कोडिंग मैन और एन्कोडिंग बाइट्स (77, 97, 110) समान ऑपरेशन हैं; Base64 वर्णों, भाषा या एन्कोडिंग के बारे में न तो जानता है और न ही उसकी परवाह करता है।
व्यावहारिक उदाहरण: 'मैन' को हाथ से एन्कोड करना - एम, ए और एन की बाइनरी, चार सूचकांक और चार आउटपुट वर्ण
यह बाइट्स देखता है. टूल का एनकोडर और डिकोडर अलग-अलग चिंता का विषय है: मैन जैसा टेक्स्ट इनपुट पहले टेक्स्टएनकोडर से होकर गुजरता है, UTF-8 बाइट्स में बदल जाता है। वे बाइट्स Base64 इनपुट हैं। आउटपुट TWFu टेक्स्ट (ASCII अक्षर) है, लेकिन बाइट्स के लिए है, शब्द के लिए नहीं। TWFu पढ़ने वाले विभिन्न टूल बाइट्स (77, 97, 110) को पुनर्प्राप्त करते हैं और उन्हें स्वतंत्र रूप से निर्णय लेना होगा कि क्या वे किसी अन्य एन्कोडिंग में शब्द, छवि, संदेश का प्रतिनिधित्व करते हैं या कुछ और।
बड़े इनपुट इस पैटर्न की कई पुनरावृत्तियाँ हैं। एक 300-बाइट फ़ाइल तीन बाइट्स के 300/3 = 100 ब्लॉक का उपयोग करती है, प्रत्येक चार वर्ण बन जाता है, जिससे 400 आउटपुट वर्ण उत्पन्न होते हैं। जब अंतिम ब्लॉक गद्देदार होता है, तो एक डिकोडर दूसरे बाइट का निर्माण करने के बजाय शून्य भरण को हटा देता है। वह सीमा दो-बाइट इनपुट के साथ दिखाई देती है: तीन उपयोगी सूचकांक जीवित रहते हैं, चौथी स्थिति एक बराबर चिह्न है, और केवल सोलह पुनर्निर्मित बिट्स परिणाम से संबंधित हैं।
प्रक्रिया को उलटना - इंडेक्स लुकअप, बिट पैकिंग और चार वर्णों को तीन बाइट्स में डिकोड करते समय पैडिंग बिट्स कहां जाते हैं
क्योंकि पैटर्न नियमित है, ऑपरेशन तेज़ है: बिट शिफ्ट, ऊपर देखें, लिखें। एकमात्र अनियमितता अंतिम ब्लॉक है जब इनपुट लंबाई तीन से अधिक नहीं होती है, जिसे पैडिंग द्वारा नियंत्रित किया जाता है। क्योंकि प्रत्येक ब्लॉक स्वतंत्र है - एक ब्लॉक के बिट्स अगले को प्रभावित नहीं करते हैं - Base64 वृद्धिशील रूप से एन्कोड कर सकता है: पूरे इनपुट की प्रतीक्षा किए बिना, बाइट्स फ़ीड करें, अक्षर बाहर निकालें।
Base64url केवल वर्णमाला प्रतिस्थापन में भिन्न है। सूचकांक 62 और 63 + के बजाय - और _ बन जाते हैं और /. बिट पुनर्समूहन समान है; बाइट-टू-कैरेक्टर मैपिंग समान है; केवल लुकअप तालिका बदलती है. इसलिए एक हैंड डिकोडर मानक Base64 से प्रत्येक शिफ्ट और मास्क का पुन: उपयोग कर सकता है, केवल उन दो टर्मिनल प्रतीकों को प्रतिस्थापित कर सकता है।
परिणाम बाइट्स का अनुक्रम क्यों है, टेक्स्ट का नहीं - अलग चरण जो बाइट्स को UTF-8 वर्णों में बदल देता है
यही कारण है कि RFC 4648 अनुभाग 5 इसे अलग वर्णमाला के रूप में वर्णित करता है, अलग एन्कोडिंग के रूप में नहीं। मानक Base64 में स्ट्रिंग TWFu स्पष्ट है: इसका मतलब केवल सूचकांक (19, 22, 5, 46) हो सकता है। Base64url में, स्ट्रिंग को अलग करने के लिए - या _ का होना आवश्यक है, और इनके मौजूद न होने पर, समान सूचकांक लागू होते हैं।
कार्यान्वयन में त्रुटियों में आमतौर पर बिट शिफ्ट या गलत वर्णमाला मैपिंग में एक-एक करके गलतियाँ शामिल होती हैं। यदि ए और ए की अदला-बदली की जाती है तो गलत वर्णमाला क्रम का उपयोग करने वाला एनकोडर अलग-अलग आउटपुट उत्पन्न करता है। अंतिम आंशिक ब्लॉक (जब पैडिंग मौजूद हो) को गलत तरीके से संभालने वाला डिकोडर गलत संख्या में बाइट्स पुनर्प्राप्त कर सकता है। Base64 एनकोडर और डिकोडर मानक वर्णमाला का उपयोग करता है और RFC 4648 द्वारा पैडिंग को संभालता है, ताकि आप किसी भी हाथ से गणना किए गए उदाहरण को पेस्ट कर सकें और काम की जांच कर सकें।
इसमें क्या शामिल नहीं है - Base64url, MIME लाइन रैपिंग और बड़े बफ़र्स का प्रदर्शन
क्योंकि बिट गणित नियतिवादी है, मैन्युअल एन्कोडिंग में कोई भी त्रुटि डिकोड होने पर अलग-अलग आउटपुट उत्पन्न करेगी, जिससे गलती तुरंत हो जाएगी। Base32 (RFC 4648 अनुभाग 6) सिद्धांत को पांच-बिट खंडों तक विस्तारित करता है: 32 प्रतीक (A–Z और 2–7), इसलिए पांच बिट बिल्कुल एक वर्ण में फिट होते हैं, और 40 bits (पांच बाइट्स) आठ वर्णों में पुनः समूहित करें। वही पुनर्समूहन तर्क लागू होता है; अंतर वर्णमाला के आकार और परिणामस्वरूप इनपुट बाइट्स और आउटपुट वर्णों के अनुपात का है।
हेक्साडेसिमल (Base16) 256 संभावित प्रतीक संयोजनों में से आठ का उपयोग करता है और एक बाइट को बिना किसी पुनर्समूहन के दो वर्णों में मैप करता है। Base64 को बिट रीग्रुपिंग के रूप में समझना वेरिएंट को अवधारणात्मक रूप से सरल बनाता है: प्रति वर्ण बिट्स चुनें, तदनुसार समूह इनपुट करें, प्रत्येक समूह को वर्णमाला में देखें। Base64 को डिबग करते समय, बिट चित्र आपका टूल है। यदि बाइट्स दूषित हो गए थे, तो उन्हें फिर से एन्कोड करें और आउटपुट कैरेक्टर की तुलना कैरेक्टर से करें। यदि अनिश्चित है कि TWFu में कौन से बाइट्स हैं, तो इसे डीकोड करें और हेक्स में आउटपुट की जांच करें।
टेकअवे: Base64 बिट्स का एक प्रतिवर्ती पुनर्समूहन है - कैसे Base64 एनकोडर और डिकोडर आपको ब्राउज़र में किसी भी हाथ से गणना किए गए ब्लॉक को तुरंत जांचने देता है
Base64 एन्कोडर और डिकोडर अक्षर और हेक्स दृश्य दोनों दिखाता है, जिससे यह सत्यापित करना आसान हो जाता है कि क्या टेक्स्ट बाइट्स को देखा जा रहा है (सुपाठ्य टेक्स्ट को डिकोड किया जाएगा) या बाइनरी डेटा (हेक्स के रूप में दिखाया गया है और बाइट्स के रूप में रखा जाना चाहिए, टेक्स्ट नहीं)। चरण-दर-चरण प्रक्रिया - बाइट्स से बिट्स, बिट्स से इंडेक्स, इंडेक्स से कैरेक्टर्स - नियतात्मक, तेज और हर अनुपालन कार्यान्वयन में समान है। RFC 4648 Base64 को औपचारिक रूप से परिभाषित करता है ताकि कार्यान्वयन की तुलना की जा सके।
मानक वर्णमाला, बिट लेआउट, पैडिंग नियम और MIME में लाइन रैपिंग को कैसे नियंत्रित किया जाता है निर्दिष्ट करता है। मानक जानने से यह सत्यापित करना आसान हो जाता है कि क्या डिकोडर इसका सख्ती से पालन करता है (कैनोनिकल Base64) या वेरिएंट स्वीकार करता है (गायब पैडिंग या URL-सुरक्षित वर्ण)। कई वास्तविक दुनिया के एप्लिकेशन Base64 को थोड़ा अलग तरीके से उपयोग करते हैं: कुछ पैडिंग को छोड़ देते हैं, कुछ URL-सुरक्षित वर्णों का उपयोग करते हैं, कुछ अलग लाइन लंबाई पर लपेटते हैं। Base64 एनकोडर और डिकोडर स्वचालित रूप से विविधताओं को संभालते हैं, लेकिन मानक को समझने से डिबगिंग एकीकरण के मुद्दे बहुत आसान हो जाते हैं।