Herramientas de desarrollo · Codificador y decodificador Base64
Cómo Base64 convierte tres bytes en cuatro caracteres, paso a paso
· Cómo funciona
base64 codificación Unicode
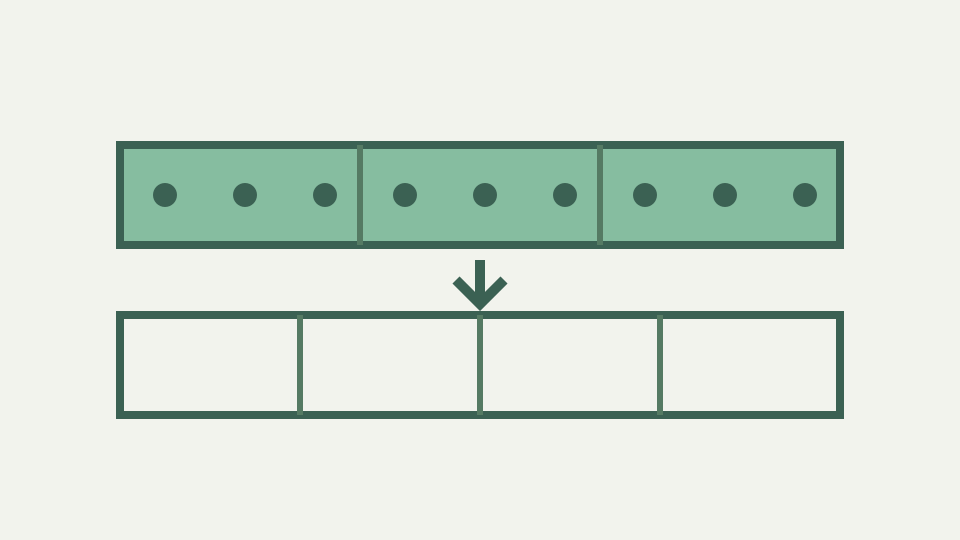
Base64 no es más que reagrupar bits: 24 bits adentro, cuatro índices de 6 bits afuera. Esta publicación recorre la búsqueda de tablas, el desplazamiento de bits y el viaje inverso para que el formato deje de ser un cuadro negro.
La cadena 'TWFu' y la palabra que oculta, empezando por un bloque real de cuatro caracteres y preguntando de dónde viene cada letra.
La cadena Base64 de cuatro caracteres TWFu se decodifica en la secuencia Man de tres bytes. La forma en que tres bytes se convierten en cuatro caracteres revela que Base64 no es cifrado ni compresión, sino pura reagrupación de bits. Una vez que vea el diseño de bits, la salida Base64 deja de ser opaca y se vuelve predecible. Puede codificar Man a mano, verificarlo con TWFU y comprender por qué Base64 siempre genera cuatro caracteres por cada tres bytes de entrada.
La magia de Base64 es que tres bytes (24 bits) se reagrupan perfectamente en cuatro fragmentos de seis bits. Seis bits representan 0 a 63, razón por la cual el alfabeto contiene exactamente 64 símbolos: A–Z (26), a–z (26), 0–9 (10), y + y / (2). Cada fragmento de seis bits se indexa en el alfabeto para producir un carácter de salida. Lo contrario es igualmente claro: cuatro caracteres indexados en el alfabeto para recuperar cuatro fragmentos de seis bits, que se reagrupan en tres bytes.
De bytes a índices de 6 bits: cómo se dividen los bits 24 en cuatro grupos y por qué los símbolos 64 son exactamente suficientes
Es por eso que Base64 se siente natural en todas partes. Tome tres bytes M, a, n en ASCII: 0x4D, 0x61, 0x6E. Escribe en binario: 01001101, 01100001, 01101110. Concatene todos los 24 bits: 010011010110000101101110. Reagrupe en cuatro fragmentos de seis bits: 010011 010110 000101 101110. Interpretar como números binarios: 19, 22, 5, 46. Índice en alfabeto Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). El índice 19 es T, el índice 22 es W, el índice 5 es F, el índice 46 es u.
Salida: TWFu. La búsqueda de índice es mecánica. El alfabeto Base64 es una secuencia donde la posición importa: cada implementación usa el mismo orden A–Z, a–z, 0–9, +, /. Un orden diferente produce resultados diferentes; cambiar el orden es exactamente cómo funciona base64url. En el alfabeto estándar, las letras mayúsculas ocupan índices 0–25, minúsculas 26–51, dígitos 52–61, caracteres especiales 62–63. Este orden es arbitrario pero está fijado por RFC; cada decodificador espera el mismo mapeo.
La tabla alfabética y la búsqueda de índices: A–Z, a–z, 0–9, + y / en orden, y por qué el orden es importante para la comparación.
Si escribe el alfabeto en papel y cuenta con cuidado, puede codificar manualmente sin computadora: busque 19, cuente A B C...T, escriba T, repita. Revertir es igualmente sencillo. Dado TWFu, busque cada carácter en el alfabeto: T es 19, W es 22, F es 5, u es 46. Convertir a binario (ceros a la izquierda para seis bits): 010011, 010110, 000101, 101110. Concatenar: 010011010110000101101110.
Agrupa en tres bytes de ocho bits: 01001101, 01100001, 01101110. Interpretar como decimal o hexadecimal: 77, 97, 110 o 0x4D, 0x61, 0x6E. Convertir a ASCII: M, a, n. Recuperaste los tres bytes originales. Esta es la razón por la que Base64 es reversible y por la que el relleno se vuelve necesario sólo para las entradas que no son divisibles por tres. Base64 codifica bytes exactos y nada más. La codificación Man y los bytes de codificación (77, 97, 110) son operaciones idénticas; Base64 no conoce ni se preocupa por los caracteres, el idioma o la codificación.
Ejemplo resuelto: codificación manual de 'Man': el binario de M, a y n, los cuatro índices y los cuatro caracteres de salida
Ve bytes. El codificador y el decodificador de la herramienta tienen una preocupación separada: la entrada de texto como Man pasa primero por TextEncoder y se convierte en UTF-8 bytes. Esos bytes son entrada Base64. El TWFU de salida es texto (caracteres ASCII), pero representa bytes, no palabras. Diferentes herramientas de lectura TWFU recuperan bytes (77, 97, 110) y deben decidir de forma independiente si representan una palabra, una imagen, un mensaje en otra codificación o algo más.
Las entradas grandes son muchas repeticiones de este patrón. Un archivo de 300 bytes utiliza 300/3 = 100 bloques de tres bytes, cada uno de los cuales se convierte en cuatro caracteres, lo que produce 400 caracteres de salida. Cuando se rellena el último bloque, un decodificador descarta el relleno de ceros en lugar de fabricar otro byte. Ese límite es visible con una entrada de dos bytes: sobreviven tres índices útiles, la cuarta posición es un signo igual y sólo dieciséis bits reconstruidos pertenecen al resultado.
Invertir el proceso: búsqueda de índice, empaquetado de bits y dónde van los bits de relleno al decodificar cuatro caracteres en tres bytes
Debido a que el patrón es regular, la operación es rápida: desplazamiento de bits, búsqueda, escritura. La única irregularidad es el bloque final cuando la longitud de entrada no es múltiplo de tres, manejado mediante relleno. Debido a que cada bloque es independiente (los bits de un bloque no afectan el siguiente), Base64 puede codificar de forma incremental: introduce bytes, saca caracteres, sin esperar la entrada completa.
Base64url difiere solo en la sustitución del alfabeto. Los índices 62 y 63 se convierten en - y _ en lugar de + y /.. La reagrupación de bits es idéntica; la asignación de byte a carácter es idéntica; sólo cambia la tabla de búsqueda. Por lo tanto, un decodificador manual puede reutilizar cada turno y máscara de Base64 estándar, reemplazando solo esos dos símbolos terminales.
Por qué el resultado es una secuencia de bytes, no texto: el paso independiente que convierte los bytes en UTF-8 caracteres
Esta es la razón por la que la sección 5 del RFC 4648 lo describe como un alfabeto distinto, no una codificación diferente. La cadena TWFu en Base64 estándar no es ambigua: solo puede significar índices (19, 22, 5, 46). En base64url, la cadena debería contener - o _ para diferir, y sin ellos, se aplican los mismos índices.
Los errores en la implementación generalmente involucran errores uno por uno en cambios de bits o mapeo alfabético incorrecto. Un codificador que utiliza un orden alfabético incorrecto produce una salida diferente si se intercambian a y A. Un decodificador que maneje mal el último bloque parcial (cuando hay relleno) podría recuperar un número incorrecto de bytes. El codificador y decodificador Base64 utiliza un alfabeto estándar y maneja el relleno mediante RFC 4648, por lo que puede pegar cualquier ejemplo calculado manualmente y verificar el trabajo.
Lo que esto no cubre: base64url, ajuste de línea MIME y rendimiento de buffers grandes
Debido a que la matemática de bits es determinista, cualquier error en la codificación manual producirá resultados diferentes cuando se decodifique, lo que hará que el error sea inmediato. Base32 (RFC 4648 sección 6) extiende el principio a fragmentos de cinco bits: 32 símbolos (A–Z y 2–7), por lo que cinco bits caben exactamente en un carácter y 40 bits (cinco bytes) se reagrupan en ocho caracteres. Se aplica la misma lógica de reagrupación; La diferencia es el tamaño del alfabeto y, en consecuencia, la relación entre bytes de entrada y caracteres de salida.
Hexadecimal (base16) utiliza ocho de 256 posibles combinaciones de símbolos y asigna un byte a dos caracteres sin reagrupación. Comprender Base64 como reagrupación de bits hace que las variantes sean conceptualmente simples: seleccione bits por carácter, agrupe la entrada en consecuencia, busque cada grupo en alfabeto. Al depurar Base64, la imagen de bits es su herramienta. Si los bytes estaban dañados, codifíquelos nuevamente y compare la salida carácter por carácter. Si no está seguro de qué bytes contiene TWFu, decodifíquelo y examine la salida en hexadecimal.
Conclusión: Base64 es una reagrupación reversible de bits: cómo el codificador y descodificador Base64 le permite verificar cualquier bloque calculado manualmente instantáneamente en el navegador
El codificador y decodificador Base64 muestra caracteres y vista hexadecimal, lo que simplifica la verificación de si se miran bytes de texto (se decodificarán en texto legible) o datos binarios (se muestran como hexadecimales y es mejor conservarlos como bytes, no como texto). El proceso paso a paso (bytes a bits, bits a índices, índices a caracteres) es determinista, rápido y el mismo en todas las implementaciones compatibles. RFC 4648 define Base64 formalmente para que se puedan comparar las implementaciones.
El estándar especifica el alfabeto, el diseño de bits, las reglas de relleno y cómo se maneja el ajuste de línea en MIME. Conocer el estándar facilita verificar si el decodificador lo sigue estrictamente (Base64 canónico) o acepta variantes (faltan relleno o caracteres seguros para URL). Muchas aplicaciones del mundo real usan Base64 de manera ligeramente diferente: algunas omiten el relleno, otras usan caracteres seguros para URL y otras se ajustan a diferentes longitudes de línea. El codificador y decodificador Base64 maneja las variaciones automáticamente, pero comprender el estándar simplifica mucho la depuración de los problemas de integración.