開發者工具 · Base64 編碼器和解碼器
Base64 如何逐步將三個位元組轉換為四個字符
· 工作原理
base64 編碼 統一碼
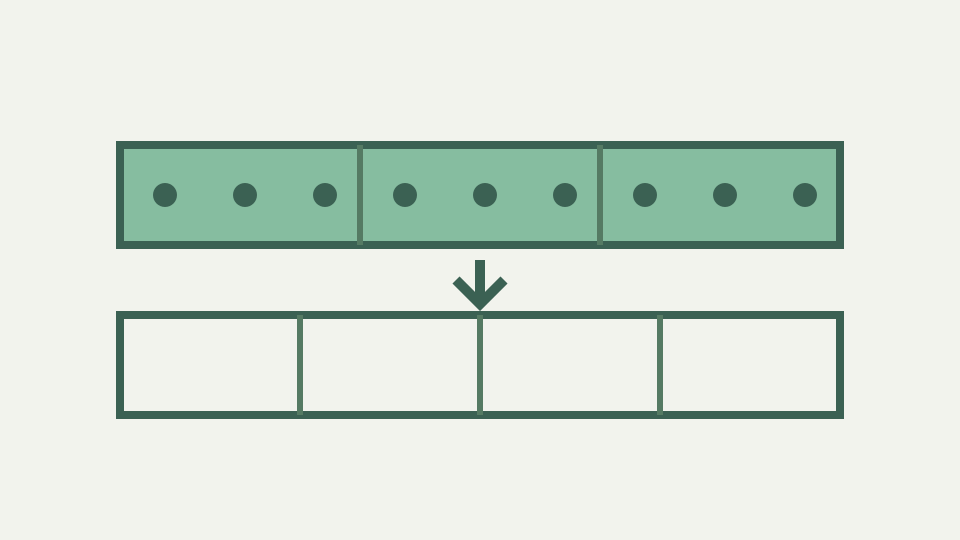
Base64 只不過是重新組合位元:24 位元輸入,四個 6 位元索引輸出。這篇文章介紹了表格查找、位移位和反向行程,因此格式不再是黑盒子。
字串“TWFu”及其隱藏的單字 - 從真正的四個字元區塊開始並詢問每個字母來自哪裡
四個字元 Base64 字串 TWFu 解碼為三位元組序列 Man。三個位元組變成四個字元的過程揭示了 Base64 不是加密或壓縮,而是純粹的位元重組。一旦您看到位元佈局,Base64 輸出就不再是不透明的,而是變得可預測。您可以手動對 Man 進行編碼,根據 TWFu 進行驗證,並理解為什麼 Base64 總是每三個輸入位元組輸出四個字元。
Base64 的神奇之處在於,三個位元組(24 位元)完美地重新組合成四個六位元區塊。六位代表 0 到 63,這就是為什麼字母表恰好包含 64 個符號:A–Z (26)、a–z (26)、0–9 (10) 以及 + 和 / (2)。每個六位元區塊索引到字母表中以產生一個輸出字元。反之亦然:四個字元索引到字母表中以恢復四個六位元區塊,這些區塊重新組合成三個位元組。
從位元組到 6 位元索引 — 24 位元如何分成四組以及為什麼 64 符號就足夠了
這就是為什麼 Base64 到處都感覺很自然。取ASCII中的三個位元組M、a、n:0x4D、0x61、0x6E。以二進位寫入:01001101、01100001、01101110。連接所有 24 位元:010011010110000101101110。重新組合成四個六位元區塊:010011 010110 000101 101110。解釋為二進位數: 19、22、5、46。 Base64 字母索引(A=0、B=1、...Z=25、a=26、...z=51、0=52、...9=61、+=62、/=63)。索引 19 是 T,索引 22 是 W,索引 5 是 F,索引 46 是 u。
輸出:TWFu。索引查找是機械的。 Base64 字母表是位置很重要的序列:每個實現都使用相同的順序 A–Z、a–z、0–9、+、/。不同的順序產生不同的輸出;更改順序正是 base64url 的工作原理。在標準字母表中,大寫字母佔據索引 0-25,小寫字母佔據索引 26-51,數字佔據索引 52-61,特殊字元佔據索引 62-63。此順序是任意的,但由 RFC 固定;每個解碼器都期望相同的映射。
字母與索引查找 — A–Z、a–z、0–9、+ 和 / 依序排列,以及為什麼順序對比較很重要
如果您在紙上寫下字母並仔細數數,則無需計算機即可手動編碼:查找 19,數 A B C...T,寫 T,重複。倒車同樣簡單。給定 TWFu,尋找字母中的每個字元:T 是 19,W 是 22,F 是 5,u 是 46。轉換為二進位(六位前導零):010011、010110、000101、101110。連接:010011010110000101101110。
分為三個位元組,每組八位元:01001101、01100001、01101110。解釋為十進位或十六進位:77、97、110 或 0x4D、0x61、0x6E。轉換為 ASCII:M、a、n。您恢復了原始的三個位元組。這就是為什麼 Base64 是可逆的,以及為什麼只有對於不能被三整除的輸入才需要填滿。 Base64 編碼精確的字節,僅此而已。編碼 Man 和編碼位元組 (77, 97, 110) 是相同的操作; Base64 不知道也不關心字元、語言或編碼。
工作範例:手動編碼「Man」——M、a 和 n 的二進位、四個索引和四個輸出字符
它看到位元組。該工具的編碼器和解碼器分別關注:像 Man 這樣的文字輸入首先經過 TextEncoder,變成 UTF-8 位元組。這些位元組是 Base64 輸入。輸出 TWFu 是文字(ASCII 字元),但代表字節,而不代表字。讀取 TWFu 的不同工具會恢復位元組(77、97、110),並必須獨立決定它們是否表示另一種編碼中的單字、圖片、訊息或其他內容。
大輸入是這種模式的多次重複。 300 位元組檔案使用 300/3 = 100 三個位元組區塊,每個區塊變成四個字符,產生 400 輸出字元。當最後一個區塊被填充時,解碼器丟棄零填充而不是製造另一個位元組。這個邊界對於兩個位元組輸入是可見的:三個有用的索引保留下來,第四個位置是等號,並只有十六個重構位元屬於結果。
反轉該過程 - 索引查找、位元打包以及將四個字元解碼為三個位元組時填充位的位置
由於模式是規則的,所以操作速度很快:移位、尋找、寫入。唯一的不規則之處是當輸入長度不是三的倍數時的最終區塊,透過填充處理。因為每個區塊都是獨立的(一個區塊的位元不會影響下一個區塊),所以 Base64 可以增量編碼:輸入字節,取出字符,無需等待整個輸入。
Base64url 僅在字母替換方面有所不同。索引 62 和 63 變成 - 和 _ 而不是 + 和 /. 位元重組相同;位元組到字元的對應是相同的;僅查找表格發生變化。因此,手動解碼器可以重複使用標準 Base64 中的每個移位和掩碼,僅替換這兩個終端符號。
為什麼結果是位元組序列,而不是文字 - 將位元組轉換為 UTF-8 字元的單獨步驟
這就是為什麼 RFC 4648 部分 5 將其描述為不同的字母表,而不是不同的編碼。標準 Base64 中的字串 TWFu 是明確的:它只能表示索引 (19、22、5、46)。在 base64url 中,字串需要包含 - 或 _ 來區分,如果沒有這些,則套用相同的索引。
實作中的錯誤通常涉及位移位中的差一錯誤或不正確的字母表映射。如果交換 a 和 A,使用錯誤字母順序的編碼器會產生不同的輸出。解碼器錯誤處理最後一個部分區塊(當存在填充時)可能會恢復錯誤的位元組數。 Base64 編碼器和解碼器使用標準字母並透過 RFC 4648 處理填充,因此您可以貼上任何手動計算的範例並檢查工作。
這不包括什麼——base64url、MIME 換行和大緩衝區的效能
由於位元數學是確定性的,因此手動編碼中的任何錯誤都會在解碼時產生不同的輸出,從而立即出錯。 Base32(RFC 4648 第 6 節)將原理擴展到五位區塊:32 個符號(A-Z 和 2-7),因此 5 位元正好適合一個字符,而 40 位元(五個位元組)重新組合成八個字元。適用相同的重組邏輯;差異在於字母大小以及輸入位元組與輸出字元的比率。
十六進位 (base16) 使用八種 256 可能的符號組合,並將一個位元組映射到兩個字符,無需重新分組。將 Base64 理解為位元重組使得變體在概念上變得簡單:為每個字元選擇位,相應地對輸入進行分組,在字母表中找到每個組。調試 Base64 時,點陣圖是您的工具。如果位元組已損壞,請再次對其進行編碼並逐個字元地比較輸出。如果不確定 TWFu 包含哪些字節,請將其解碼並檢查十六進位輸出。
重點:Base64 是一種可逆的位元重組-Base64 編碼器和解碼器如何讓您在瀏覽器中立即檢查任何手動計算的區塊
Base64 編碼器和解碼器顯示字元和十六進位視圖,從而可以輕鬆驗證是否查看文字位元組(將解碼為清晰的文字)或二進位資料(顯示為十六進位,最好保留為位元組,而不是文字)。逐步過程(位元組到位、位元到索引、索引到字元)是確定性的、快速的,並在每個合規實施中都是相同的。 RFC 4648 正式定義了 Base64,以便可以比較實作。
標準指定字母表、位元佈局、填充規則以及 MIME 中如何處理換行。了解標準可以輕鬆驗證解碼器是否嚴格遵循它(規範的 Base64)或接受變體(缺少填充或 URL 安全字元)。許多實際應用程式使用 Base64 略有不同:有些省略填充,有些使用 URL 安全字符,有些以不同的行長度換行。 Base64 編碼器和解碼器會自動處理變化,但了解標準可以讓偵錯整合問題變得更加簡單。