Инструменты разработчика · Кодер и декодер Base64
Как Base64 шаг за шагом превращает три байта в четыре символа
· Как это работает
base64 кодирование Юникод
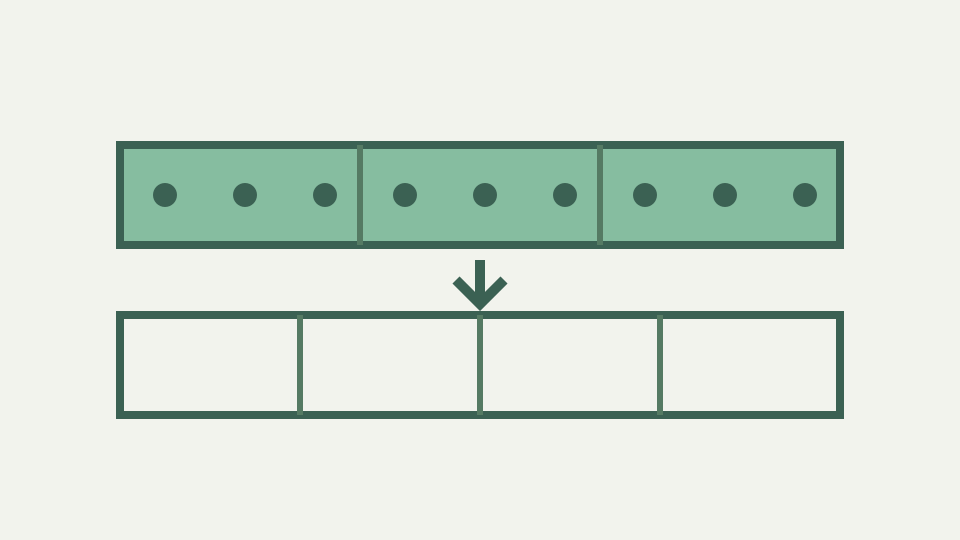
Base64 — это не что иное, как перегруппировка битов: 24 bits на входе, четыре 6-битных индекса на выходе. В этом посте рассматривается поиск по таблице, сдвиг битов и обратный путь, чтобы формат перестал быть черным ящиком.
Строка «TWFu» и скрываемое ею слово — начиная с реального блока из четырех символов и спрашивая, откуда взялась каждая буква.
Четырехсимвольная строка TWFu в формате Base64 декодируется в трехбайтовую последовательность Man. То, как три байта превращаются в четыре символа, показывает, что Base64 — это не шифрование или сжатие, а чистая перегруппировка битов. Как только вы увидите расположение битов, вывод Base64 перестанет быть непрозрачным и станет предсказуемым. Вы можете закодировать Man вручную, сверить его с TWFu и понять, почему Base64 всегда выводит четыре символа на три байта ввода.
Магия Base64 заключается в том, что три байта (24 bits) идеально перегруппировываются в четыре фрагмента по шесть бит. Шесть бит представляют от 0 до 63, поэтому алфавит содержит ровно 64 символов: A–Z (26), a–z (26), 0–9 (10), + и / (2). Каждый шестибитный фрагмент индексируется в алфавит для получения одного выходного символа. Обратное тоже понятно: четыре символа индексируются в алфавит, чтобы восстановить четыре шестибитных фрагмента, которые перегруппировываются в три байта.
От байтов к 6-битным индексам — как 24 bits разбивается на четыре группы и почему символов 64 ровно достаточно
Вот почему Base64 везде чувствует себя естественно. Возьмем три байта M, a, n в ASCII: 0x4D, 0x61, 0x6E. Запишите в двоичном формате: 01001101, 01100001, 01101110. Объедините все 24 bits: 010011010110000101101110. Перегруппируйтесь в четыре фрагмента по шесть бит: 010011 010110 000101 101110. Интерпретируйте как двоичные числа: 19, 22, 5, 46. Индекс в алфавите Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). Индекс 19 — T, индекс 22 — W, индекс 5 — F, индекс 46 — u.
Вывод: TWFu. Поиск по индексу является механическим. Алфавит Base64 — это последовательность, в которой позиция имеет значение: каждая реализация использует один и тот же порядок A–Z, a–z, 0–9, +, /. Разный порядок дает разные выходные данные; порядок изменения — это именно то, как работает base64url. В стандартном алфавите прописные буквы занимают индексы 0–25, строчные 26–51, цифры 52–61, специальные символы 62–63. Этот порядок произволен, но фиксирован RFC; каждый декодер ожидает одинакового отображения.
Алфавитная таблица и поиск по индексу — A–Z, a–z, 0–9, + и / по порядку, и почему порядок важен для сравнения
Если вы напишете алфавит на бумаге и внимательно посчитаете, вы сможете закодировать вручную без компьютера: найдите 19, посчитайте A B C...T, напишите T, повторите. Обратный ход столь же прост. Учитывая TWFu, найдите каждый символ алфавита: T — 19, W — 22, F — 5, u — 46. Преобразовать в двоичный формат (шесть битов ведут нули): 010011, 010110, 000101, 101110. Объединение: 010011010110000101101110.
Сгруппируйте их в три байта по восемь бит: 01001101, 01100001, 01101110. Интерпретировать как десятичный или шестнадцатеричный формат: 77, 97, 110 или 0x4D, 0x61, 0x6E. Преобразовать в ASCII: M, a, n. Вы восстановили исходные три байта. Вот почему Base64 является обратимым и почему заполнение становится необходимым только для входных данных, не кратных трем. Base64 кодирует точные байты и не более того. Кодирование Man и кодирование байтов (77, 97, 110) являются идентичными операциями; Base64 не знает и не заботится о символах, языке или кодировке.
Рабочий пример: кодирование «Человека» вручную — двоичный код M, a и n, четыре индекса и четыре выходных символа.
Он видит байты. Кодировщик и декодер инструмента имеют отдельную задачу: текстовый ввод, такой как Man, сначала проходит через TextEncoder, превращаясь в UTF-8 байты. Эти байты являются входными данными Base64. Выходной TWFu представляет собой текст (ASCII символов), но обозначает байты, а не слова. Другой инструмент чтения TWFu восстанавливает байты (77, 97, 110) и должен самостоятельно решить, представляют ли они слово, изображение, сообщение в другой кодировке или что-то еще.
Большие входные данные представляют собой множество повторений этого шаблона. Файл размером 300 использует 300/3 = 100 блоки по три байта, каждый из которых становится четырьмя символами, что дает 400 выходных символов. Когда последний блок дополняется, декодер отбрасывает нулевое заполнение вместо того, чтобы создавать еще один байт. Эта граница видна при вводе двух байтов: сохраняются три полезных индекса, четвертая позиция — знак равенства, а результату принадлежат только шестнадцать восстановленных битов.
Обратный процесс — поиск по индексу, упаковка битов и куда идут биты заполнения при декодировании четырех символов в три байта
Поскольку шаблон регулярен, операции выполняются быстро: сдвиг битов, поиск вверх, запись. Единственная ошибка — это финальный блок, когда входная длина не кратна трем, и обрабатывается заполнением. Поскольку каждый блок независим — биты одного блока не влияют на следующий — Base64 может кодировать инкрементально: вводить байты, выводить символы, не дожидаясь ввода всего текста.
Base64url отличается только заменой алфавита. Индексы 62 и 63 становятся - и _ вместо + и /. Перегруппировка битов идентична; отображение байтов в символы идентично; меняется только таблица поиска. Таким образом, ручной декодер может повторно использовать каждый сдвиг и маску из стандарта Base64, заменяя только эти два терминальных символа.
Почему результатом является последовательность байтов, а не текст — отдельный шаг, который превращает байты в символы UTF-8
Вот почему раздел RFC 4648 5 описывает его как отдельный алфавит, а не как другую кодировку. Строка TWFu в стандарте Base64 однозначна: она может означать только индексы (19, 22, 5, 46). В base64url строка должна содержать - или _, чтобы отличаться, а без них применяются те же индексы.
Ошибки в реализации обычно включают ошибки смещения битов на единицу или неправильное сопоставление алфавита. Кодировщик, использующий неправильный порядок алфавита, выдает другой результат, если a и A были заменены местами. Декодер, неправильно обрабатывающий последний частичный блок (при наличии заполнения), может восстановить неправильное количество байтов. Кодер и декодер Base64 использует стандартный алфавит и обрабатывает заполнение с помощью RFC 4648, поэтому вы можете вставить любой рассчитанный вручную пример и проверить работу.
Чего это не касается — base64url, перенос строк MIME и производительность больших буферов.
Поскольку битовая математика детерминирована, любая ошибка при ручном кодировании приведет к другому результату при декодировании, что приведет к немедленной ошибке. Base32 (RFC 4648 раздел 6) расширяет принцип до пятибитовых фрагментов: символы 32 (A–Z и 2–7), поэтому пять битов точно помещаются в один символ, а 40 bits (пять байтов) перегруппируйтесь на восемь персонажей. Применяется та же логика перегруппировки; разница заключается в размере алфавита и, следовательно, в соотношении входных байтов и выходных символов.
Шестнадцатеричный формат (с основанием 16) использует восемь из 256 возможных комбинаций символов и отображает один байт в два символа без перегруппировки. Понимание Base64 как перегруппировки бит делает варианты концептуально простыми: выбирайте биты для каждого символа, соответствующим образом группируйте ввод, ищите каждую группу в алфавите. При отладке Base64 вашим инструментом будет битовое изображение. Если байты были повреждены, закодируйте их еще раз и сравните выходные данные посимвольно. Если вы не уверены, какие байты содержит TWFu, раскодируйте его и проверьте вывод в шестнадцатеричном формате.
Вывод: Base64 — это обратимая перегруппировка битов. Кодер и декодер Base64 позволяет мгновенно проверять любой рассчитанный вручную блок в браузере.
Кодер и декодер Base64 отображает как символы, так и шестнадцатеричный вид, упрощая проверку того, просматриваете ли вы текстовые байты (будут декодироваться в разборчивый текст) или двоичные данные (отображаются в шестнадцатеричном виде и лучше всего сохраняются в виде байтов, а не текста). Пошаговый процесс — преобразование байтов в биты, биты в индексы, индексы в символы — является детерминированным, быстрым и одинаковым во всех совместимых реализациях. RFC 4648 формально определяет Base64, поэтому реализации можно сравнивать.
Стандарт определяет алфавит, расположение битов, правила заполнения и способ обработки переноса строк в MIME. Зная стандарт, можно легко проверить, строго ли декодер следует ему (канонический Base64) или принимает варианты (отсутствующие дополнения или URL-безопасные символы). Многие реальные приложения используют Base64 немного по-другому: некоторые пропускают заполнение, некоторые используют символы, безопасные для URL, некоторые переносятся на строки разной длины. Кодер и декодер Base64 автоматически обрабатывают варианты, но понимание стандарта значительно упрощает отладку проблем интеграции.