Alat pengembang · Encoder & decoder Base64
Bagaimana Base64 mengubah tiga byte menjadi empat karakter, langkah demi langkah
· Cara kerjanya
base64 pengkodean unicode
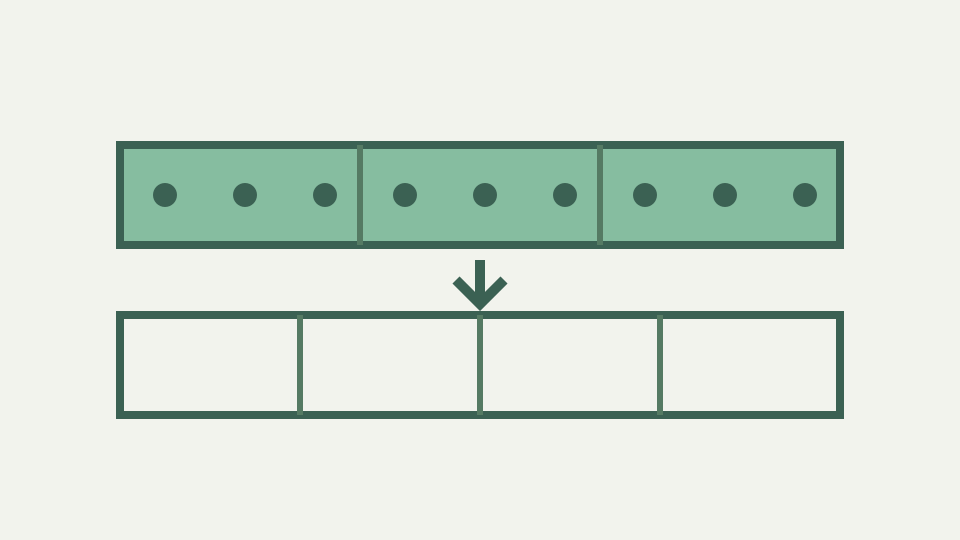
Base64 tidak lebih dari pengelompokan ulang bit: 24 bits masuk, empat indeks 6-bit keluar. Posting ini membahas pencarian tabel, pergeseran bit dan perjalanan terbalik sehingga formatnya berhenti menjadi kotak hitam.
String 'TWFu' dan kata yang disembunyikannya — dimulai dari blok empat karakter sebenarnya dan menanyakan dari mana setiap huruf berasal
String Base64 empat karakter TWFu diterjemahkan ke urutan tiga byte Man. Bagaimana tiga byte menjadi empat karakter mengungkapkan bahwa Base64 bukanlah enkripsi atau kompresi tetapi pengelompokan ulang bit murni. Setelah Anda melihat tata letak bit, keluaran Base64 tidak lagi buram dan dapat diprediksi. Anda dapat menyandikan Man dengan tangan, memverifikasinya dengan TTWFu, dan memahami mengapa Base64 selalu menghasilkan empat karakter per tiga byte input.
Keajaiban Base64 adalah tiga byte (24 bits) berkumpul kembali dengan sempurna menjadi empat bagian enam bit. Enam bit mewakili 0 hingga 63, itulah sebabnya alfabet berisi simbol 64: A–Z (26), a–z (26), 0–9 (10), dan + dan / (2). Setiap potongan enam-bit mengindeks ke dalam alfabet untuk menghasilkan satu karakter keluaran. Kebalikannya sama bersihnya: empat karakter mengindeks ke dalam alfabet untuk memulihkan empat potongan enam-bit, yang dikelompokkan kembali menjadi tiga byte.
Dari byte hingga indeks 6-bit — bagaimana 24 bits dibagi menjadi empat grup dan mengapa simbol 64 sudah cukup
Inilah sebabnya Base64 terasa alami di mana pun. Ambil tiga byte M, a, n di ASCII: 0x4D, 0x61, 0x6E. Tulis dalam biner: 01001101, 01100001, 01101110. Gabungkan semua 24 bits: 010011010110000101101110. Kelompokkan kembali menjadi empat bagian yang terdiri dari enam bit: 010011 010110 000101 101110. Tafsirkan sebagai bilangan biner: 19, 22, 5, 46. Indeks ke dalam alfabet Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). Indeks 19 adalah T, indeks 22 adalah W, indeks 5 adalah F, indeks 46 adalah u.
Keluaran: TWFu. Pencarian indeks bersifat mekanis. Alfabet Base64 adalah urutan yang mengutamakan posisi: setiap implementasi menggunakan urutan yang sama A–Z, a–z, 0–9, +, /. Urutan yang berbeda menghasilkan keluaran yang berbeda; mengubah urutan adalah cara kerja base64url. Dalam alfabet standar, huruf besar menempati indeks 0–25, huruf kecil 26–51, angka 52–61, karakter khusus 62–63. Pemesanan ini bersifat sewenang-wenang tetapi ditetapkan oleh RFC; setiap decoder mengharapkan pemetaan yang sama.
Tabel alfabet dan pencarian indeks — A–Z, a–z, 0–9, + dan / secara berurutan, dan mengapa urutan tersebut penting untuk perbandingan
Jika Anda menulis alfabet di atas kertas dan menghitung dengan cermat, Anda dapat mengkodekan secara manual tanpa komputer: cari 19, hitung A B C...T, tulis T, ulangi. Membalikkan juga sama mudahnya. Mengingat TWFu, cari setiap karakter dalam alfabet: T adalah 19, W adalah 22, F adalah 5, u adalah 46. Konversikan ke biner (angka nol di depan untuk enam bit): 010011, 010110, 000101, 101110. Gabungan: 010011010110000101101110.
Kelompokkan menjadi tiga byte yang terdiri dari delapan bit: 01001101, 01100001, 01101110. Menafsirkan sebagai desimal atau hex: 77, 97, 110 atau 0x4D, 0x61, 0x6E. Konversikan ke ASCII: M, a, n. Anda memulihkan tiga byte asli. Inilah sebabnya Base64 dapat dibalik dan mengapa padding hanya diperlukan untuk input yang tidak habis dibagi tiga. Base64 mengkodekan byte yang tepat dan tidak lebih. Pengkodean Man dan pengkodean byte (77, 97, 110) adalah operasi yang identik; Base64 tidak mengetahui atau peduli dengan karakter, bahasa, atau pengkodean.
Contoh praktis: pengkodean 'Man' dengan tangan - biner dari M, a dan n, empat indeks dan empat karakter keluaran
Ia melihat byte. Masalah encoder dan decoder alat ini berbeda: input tekstual seperti Man melewati TextEncoder terlebih dahulu, berubah menjadi UTF-8 byte. Byte tersebut adalah masukan Base64. Output TWFu adalah teks (ASCII karakter), tetapi singkatan dari byte, bukan kata. Alat pembacaan TWFu yang berbeda memulihkan byte (77, 97, 110) dan harus secara mandiri memutuskan apakah byte tersebut mewakili kata, gambar, pesan dalam pengkodean lain atau yang lainnya.
Masukan yang besar berarti banyak pengulangan pola ini. File 300-byte menggunakan 300/3 = 100 blok tiga byte, masing-masing menjadi empat karakter, menghasilkan 400 karakter keluaran. Ketika blok terakhir diisi, decoder membuang isi nol daripada membuat byte lain. Batas tersebut terlihat dengan masukan dua byte: tiga indeks berguna bertahan, posisi keempat adalah tanda sama dengan, dan hanya enam belas bit yang direkonstruksi menjadi milik hasilnya.
Membalikkan proses - pencarian indeks, pengepakan bit, dan ke mana perginya bit padding saat mendekode empat karakter menjadi tiga byte
Karena polanya teratur, pengoperasiannya cepat: pergeseran bit, cari, tulis. Satu-satunya ketidakteraturan adalah blok terakhir ketika panjang input bukan kelipatan tiga, ditangani dengan padding. Karena setiap blok bersifat independen—bit dari satu blok tidak mempengaruhi blok berikutnya—Base64 dapat mengkodekan secara bertahap: memasukkan byte, mengeluarkan karakter, tanpa menunggu seluruh input.
Base64url hanya berbeda dalam substitusi alfabet. Indeks 62 dan 63 menjadi - dan _ bukannya + dan /. Pengelompokan ulang bit identik; pemetaan byte-ke-karakter identik; hanya tabel pencarian yang berubah. Oleh karena itu, dekoder tangan dapat menggunakan kembali setiap shift dan mask dari Base64 standar, hanya menggantikan dua simbol terminal tersebut.
Mengapa hasilnya berupa urutan byte, bukan teks — langkah terpisah yang mengubah byte menjadi UTF-8 karakter
Inilah sebabnya mengapa RFC 4648 bagian 5 mendeskripsikannya sebagai alfabet yang berbeda, bukan pengkodean yang berbeda. String TWFu dalam Base64 standar tidak ambigu: ini hanya dapat berarti indeks (19, 22, 5, 46). Di base64url, string harus berisi - atau _ agar berbeda, dan tanpa kehadirannya, indeks yang sama akan berlaku.
Kesalahan dalam implementasi biasanya melibatkan kesalahan satu per satu dalam pergeseran bit atau pemetaan alfabet yang salah. Pembuat enkode yang menggunakan urutan alfabet yang salah menghasilkan keluaran yang berbeda jika a dan A ditukar. Decoder yang salah menangani blok parsial terakhir (saat ada padding) mungkin memulihkan jumlah byte yang salah. Encoder & decoder Base64 menggunakan alfabet standar dan menangani padding dengan RFC 4648, sehingga Anda dapat menempelkan contoh apa pun yang dihitung secara manual dan memeriksa pekerjaan.
Apa yang tidak tercakup di sini — base64url, pembungkusan baris MIME dan kinerja buffer besar
Karena matematika bit bersifat deterministik, kesalahan apa pun dalam pengkodean manual akan menghasilkan keluaran yang berbeda ketika didekode, sehingga membuat kesalahan langsung terjadi. Base32 (RFC 4648 bagian 6) memperluas prinsip ke potongan lima bit: 32 simbol (A–Z dan 2–7), sehingga lima bit cocok tepat menjadi satu karakter, dan 40 bits (lima byte) berkumpul kembali menjadi delapan karakter. Logika pengelompokan ulang yang sama juga berlaku; perbedaannya adalah ukuran alfabet dan akibatnya rasio byte masukan terhadap karakter keluaran.
Heksadesimal (base16) menggunakan delapan dari 256 kemungkinan kombinasi simbol dan memetakan satu byte ke dua karakter tanpa pengelompokan ulang. Memahami Base64 sebagai pengelompokan ulang bit membuat varian menjadi sederhana secara konseptual: pilih bit per karakter, kelompokkan input yang sesuai, cari setiap grup dalam alfabet. Saat men-debug Base64, gambar bit adalah alat Anda. Jika byte rusak, kodekan lagi dan bandingkan output karakter demi karakter. Jika tidak yakin apa isi byte TWFu, dekodekan dan periksa output dalam hex.
Kesimpulan: Base64 adalah pengelompokan ulang bit yang dapat dibalik — bagaimana encoder & decoder Base64 memungkinkan Anda memeriksa blok apa pun yang dihitung dengan tangan secara instan di browser
Encoder & decoder Base64 menampilkan karakter dan tampilan hex, memudahkan verifikasi apakah melihat byte teks (akan didekode menjadi teks yang dapat dibaca) atau data biner (ditampilkan sebagai hex dan paling baik disimpan sebagai byte, bukan teks). Proses langkah demi langkah—byte ke bit, bit ke indeks, indeks ke karakter—bersifat deterministik, cepat, dan sama di setiap penerapan yang sesuai. RFC 4648 mendefinisikan Base64 secara formal sehingga implementasi dapat dibandingkan.
Standar menentukan alfabet, tata letak bit, aturan padding, dan cara penanganan pembungkusan garis di MIME. Mengetahui standar memudahkan untuk memverifikasi apakah decoder mengikutinya dengan ketat (Canonical Base64) atau menerima varian (padding tidak ada atau karakter aman URL). Banyak aplikasi dunia nyata menggunakan Base64 sedikit berbeda: beberapa menghilangkan padding, beberapa menggunakan karakter aman URL, beberapa membungkus dengan panjang garis yang berbeda. Encoder & decoder Base64 menangani variasi secara otomatis, tetapi pemahaman standar membuat masalah integrasi debugging menjadi lebih sederhana.