開発者ツール · Base64 エンコーダーおよびデコーダー
Base64 が 3 バイトを 4 文字に段階的に変換する方法
· 仕組み
base64 エンコード ユニコード
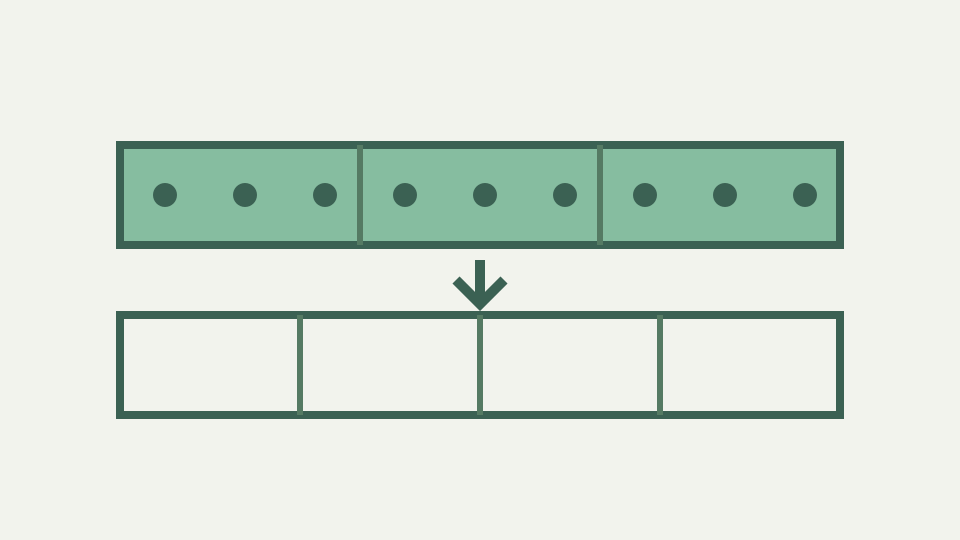
Base64 は、ビットを再グループ化するものにすぎません。24 ビットが入力され、4 つの 6 ビット インデックスが出力されます。この投稿では、テーブル ルックアップ、ビット シフト、およびリバース トリップについて説明し、フォーマットがブラック ボックスでなくなるようにします。
文字列「TWFu」とそれが隠す単語 — 実際の 4 文字のブロックから始まり、それぞれの文字がどこから来たのかを尋ねます
4 文字の Base64 文字列 TWFu は、3 バイトのシーケンス Man にデコードされます。 3 バイトがどのようにして 4 文字になるかを見ると、Base64 が暗号化や圧縮ではなく、純粋なビットの再グループ化であることがわかります。ビット レイアウトが表示されると、Base64 出力は不透明ではなくなり、予測可能になります。 Man を手動でエンコードし、TWFu に対して検証して、Base64 が入力 3 バイトごとに常に 4 文字を出力する理由を理解できます。
Base64 の魔法は、3 バイト (24 ビット) が 6 ビットの 4 つのチャンクに完全に再グループ化されることです。 6 ビットは 0 から 63 を表します。そのため、アルファベットには正確に 64 記号が含まれています: A ~ Z (26)、a ~ z (26)、0–9 (10)、+ および / (2)。各 6 ビット チャンクはアルファベットにインデックス付けされ、1 つの出力文字を生成します。逆も同様にきれいです。4 つの文字がアルファベットにインデックス付けされて 4 つの 6 ビット チャンクが復元され、3 バイトに再グループ化されます。
バイトから 6 ビット インデックスまで — 24 ビットが 4 つのグループに分割される方法と、64 シンボルで十分である理由
これが、Base64 がどこでも自然に感じられる理由です。 ASCII の 3 バイト M、a、n を取得します: 0x4D、0x61、0x6E。バイナリで書き込みます: 01001101、01100001、01101110。すべての 24 ビットを連結します: 010011010110000101101110。 6 ビットの 4 つのチャンクに再グループ化します: 010011 010110 000101 101110。 2 進数として解釈します: 19、22、5、46。 Base64 アルファベットへのインデックス (A=0、B=1、...Z=25、a=26、...z=51、0=52、 ...9=61、+=62、/=63). インデックス 19 は T、インデックス 22 は W、インデックス 5 は F、インデックス 46 は u です。
出力: TWFu。インデックスの検索は機械的に行われます。 Base64 アルファベットは位置が重要な順序です。どの実装でも同じ順序 A ~ Z、a ~ z、0–9、+、/. が使用されます。順序が異なると出力も異なります。順序の変更はまさにbase64urlの仕組みです。標準アルファベットでは、大文字はインデックス 0–25、小文字は 26–51、数字は 52–61、特殊文字は 62–63 を占めます。この順序は任意ですが、RFC によって修正されています。すべてのデコーダは同じマッピングを期待します。
アルファベット テーブルとインデックスの検索 — A–Z、a–z、0–9、+ および / の順序、および比較において順序が重要である理由
紙にアルファベットを書いて注意深く数えると、コンピューターを使わずに手動でエンコードできます。19 を検索し、A B C...T を数え、T を書き込み、繰り返します。後退も同様に簡単です。 TWFu が与えられた場合、アルファベットの各文字を検索します。T は 19、W は 22、F は 5、u は 46 です。バイナリ (6 ビットの先行ゼロ) に変換します: 010011、010110、000101、101110。連結: 010011010110000101101110。
8 ビットの 3 バイトにグループ化します: 01001101、01100001、01101110。 10 進数または 16 進数として解釈します: 77、97、110、または 0x4D、0x61、0x6E。 ASCII に変換: M、a、n。元の 3 バイトが回復されました。これが、Base64 が可逆的であり、3 で割り切れない入力の場合にのみパディングが必要になる理由です。 Base64 は正確なバイトのみをエンコードします。 Man のエンコードとバイトのエンコード (77、97、110) は同一の操作です。 Base64 は、文字、言語、エンコーディングを認識しません。
作業例: 'Man' を手動でエンコード - M、a、n のバイナリ、4 つのインデックス、および 4 つの出力文字
バイトを参照します。ツールのエンコーダとデコーダは別個の関心事です。Man のようなテキスト入力は最初に TextEncoder を通過し、UTF-8 バイトに変わります。これらのバイトは Base64 入力です。出力 TWFu はテキスト (ASCII 文字) ですが、ワードではなくバイトを表します。 TWFu を読み取るさまざまなツールはバイト (77、97、110) を回復し、それらが別のエンコーディングの単語、画像、メッセージを表すかどうかを個別に判断する必要があります。
大きな入力は、このパターンを何度も繰り返すことになります。 300 バイトのファイルは、3 バイトの 300/3 = 100 ブロックを使用し、それぞれが 4 文字になり、400 出力文字を生成します。最後のブロックがパディングされると、デコーダは別のバイトを作成するのではなく、ゼロフィルを破棄します。その境界は 2 バイト入力で表示されます。つまり、3 つの有用なインデックスが残り、4 番目の位置は等号であり、結果には 16 個の再構成ビットだけが属します。
プロセスを逆にする - インデックス検索、ビット パッキング、および 4 文字を 3 バイトにデコードする際のパディング ビットの配置
パターンが規則的であるため、ビットシフト、ルックアップ、書き込みの動作が高速です。唯一不規則なのは、入力長が 3 の倍数ではない場合の最終ブロックであり、パディングによって処理されます。すべてのブロックが独立しているため (1 つのブロックのビットが次のブロックに影響を与えないため)、Base64 は入力全体を待たずに、バイトを入力し、文字を取得するなど、段階的にエンコードできます。
Base64url は、アルファベットの置換のみが異なります。インデックス 62 と 63 は、+ と /. の代わりに - と _ になります。 ビットの再グループ化は同じです。バイトから文字へのマッピングは同一です。ルックアップテーブルのみが変更されます。したがって、ハンド デコーダは、標準 Base64 のすべてのシフトとマスクを再利用し、これら 2 つの終端記号のみを置き換えることができます。
結果がテキストではなくバイトのシーケンスである理由 - バイトを UTF-8 文字に変換する別のステップ
これが、RFC 4648 セクション 5 で、異なるエンコーディングではなく、別個のアルファベットとして説明されている理由です。標準 Base64 の文字列 TWFu は明確です。インデックス (19、22、5、46) のみを意味します。 Base64url では、文字列に - または _ を含めて区別する必要があり、それらが存在しない場合は同じインデックスが適用されます。
実装におけるエラーには、通常、ビット シフトにおける 1 つずつの間違いやアルファベットのマッピングの誤りが含まれます。 a と A が交換された場合、間違ったアルファベット順を使用するエンコーダーは異なる出力を生成します。デコーダが最後の部分ブロックを誤って処理すると (パディングが存在する場合)、間違ったバイト数が回復される可能性があります。 Base64 エンコーダとデコーダは標準のアルファベットを使用し、RFC 4648 によってパディングを処理するため、手動で計算されたサンプルを貼り付けて動作を確認できます。
この内容ではカバーされていないもの — Base64url、MIME 行の折り返し、および大きなバッファーのパフォーマンス
ビット計算は決定論的であるため、手動エンコードでエラーが発生すると、デコード時に異なる出力が生成され、すぐに間違いが発生します。 Base32 (RFC 4648 セクション 6) は、原則を 5 ビットのチャンク、32 シンボル (A ~ Z および 2 ~ 7) に拡張するため、5 ビットが 1 文字に正確に収まり、40 ビット (5 バイト) が 8 文字に再グループ化されます。同じ再グループ化ロジックが適用されます。違いはアルファベットのサイズ、つまり入力バイトと出力文字の比率です。
16 進数 (base16) は、256 の可能な記号の組み合わせのうち 8 つを使用し、再グループ化せずに 1 バイトを 2 文字にマップします。 Base64 をビットの再グループ化として理解すると、バリアントが概念的に単純になります。文字ごとにビットを選択し、それに応じて入力をグループ化し、各グループをアルファベットで検索します。 Base64 をデバッグする場合、ビット ピクチャがツールになります。バイトが破損している場合は、再度エンコードして出力を文字ごとに比較します。 TWFu にどのバイトが含まれているかが不明な場合は、それをデコードし、16 進数での出力を調べてください。
要点: Base64 はビットの可逆的な再グループ化です — Base64 エンコーダーとデコーダーを使用すると、手作業で計算されたブロックをブラウザーで即座に確認できるようになります
Base64 エンコーダーとデコーダーは文字と 16 進数表示の両方を表示するため、テキスト バイト (判読可能なテキストにデコードされます) を見ているのか、バイナリ データ (16 進数で表示され、テキストではなくバイトとして保持するのが最適です) を見ているのかを簡単に検証できます。ステップバイステップのプロセス (バイトからビット、ビットからインデックス、インデックスから文字) は決定的で高速であり、準拠するすべての実装で同様です。 RFC 4648 は実装を比較できるように Base64 を正式に定義します。
標準では、アルファベット、ビット レイアウト、パディング ルール、および MIME での行の折り返しの処理方法が指定されています。標準を理解すると、デコーダがその標準に厳密に従っているか (正規の Base64)、またはバリアント (パディングの欠落や URL セーフ文字) を受け入れているかを簡単に検証できます。実際のアプリケーションの多くは、Base64 の使用方法が少し異なります。パディングを省略するもの、URL セーフ文字を使用するもの、異なる行の長さで折り返すものがあります。 Base64 エンコーダーとデコーダーはバリエーションを自動的に処理しますが、標準を理解すると、統合の問題のデバッグがはるかに簡単になります。