Outils de développement · Encodeur et décodeur Base64
Comment Base64 transforme trois octets en quatre caractères, étape par étape
· Comment ça marche
base64 codage unicode
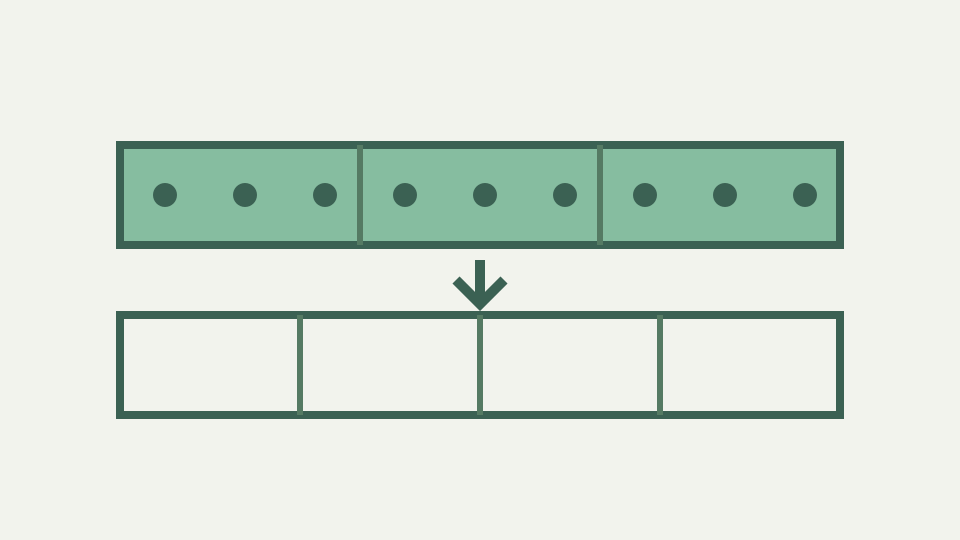
Base64 n'est rien de plus qu'un regroupement de bits : 24 bits entrants, quatre indices 6 bits sortants. Cet article passe en revue la recherche dans la table, le décalage de bits et le voyage inverse afin que le format cesse d'être une boîte noire.
La chaîne « TWFu » et le mot qu'elle cache — en commençant par un véritable bloc de quatre caractères et en demandant d'où vient chaque lettre
La chaîne Base64 de quatre caractères TWFu décode en la séquence de trois octets Man. La façon dont trois octets deviennent quatre caractères révèle que Base64 n'est pas un cryptage ou une compression mais un pur regroupement de bits. Une fois que vous voyez la disposition des bits, la sortie Base64 cesse d'être opaque et devient prévisible. Vous pouvez encoder Man à la main, le vérifier par rapport à TWFu et comprendre pourquoi Base64 génère toujours quatre caractères pour trois octets d'entrée.
La magie de Base64 est que trois octets (24 bits) se regroupent parfaitement en quatre morceaux de six bits. Six bits représentent 0 à 63, c'est pourquoi l'alphabet contient exactement 64 symboles : A à Z (26), a à z (26), 0–9 (10), et + et / (2). Chaque bloc de six bits est indexé dans l'alphabet pour produire un caractère de sortie. L’inverse est tout aussi propre : quatre caractères indexés dans l’alphabet pour récupérer quatre morceaux de six bits, qui se regroupent en trois octets.
Des octets aux indices 6 bits : comment les bits 24 sont divisés en quatre groupes et pourquoi les symboles 64 suffisent exactement
C'est pourquoi Base64 semble naturel partout. Prenez trois octets M, a, n en ASCII : 0x4D, 0x61, 0x6E. Écrivez en binaire : 01001101, 01100001, 01101110. Concaténez tous les 24 bits : 010011010110000101101110. Regroupez-vous en quatre morceaux de six bits : 010011 010110 000101 101110. Interpréter comme des nombres binaires : 19, 22, 5, 46. Indexer dans l'alphabet Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). L'index 19 est T, l'index 22 est W, l'index 5 est F, l'index 46 est u.
Sortie : TWFu. La recherche d’index est mécanique. L'alphabet Base64 est une séquence où la position compte : chaque implémentation utilise le même ordre A–Z, a–z, 0–9, +, /. Un ordre différent produit une sortie différente ; changer l'ordre est exactement la façon dont fonctionne base64url. Dans l'alphabet standard, les lettres majuscules occupent les indices 0–25, les minuscules 26–51, les chiffres 52–61, les caractères spéciaux 62–63. Cet ordre est arbitraire mais fixé par RFC ; chaque décodeur attend le même mappage.
La table alphabétique et la recherche d'index – A–Z, a–z, 0–9, + et / dans l'ordre, et pourquoi l'ordre est important pour la comparaison
Si vous écrivez l'alphabet sur du papier et comptez soigneusement, vous pouvez encoder manuellement sans ordinateur : recherchez 19, comptez A B C...T, écrivez T, répétez. La marche arrière est tout aussi simple. Étant donné TWFu, recherchez chaque caractère de l'alphabet : T est 19, W est 22, F est 5, u est 46. Convertir en binaire (zéros non significatifs pour six bits) : 010011, 010110, 000101, 101110. Concaténer : 010011010110000101101110.
Regrouper en trois octets de huit bits : 01001101, 01100001, 01101110. Interpréter comme décimal ou hexadécimal : 77, 97, 110 ou 0x4D, 0x61, 0x6E. Convertir en ASCII : M, a, n. Vous avez récupéré les trois octets d'origine. C'est pourquoi Base64 est réversible et pourquoi le remplissage ne devient nécessaire que pour les entrées non divisibles par trois. Base64 code les octets exacts et rien de plus. Encoding Man et les octets de codage (77, 97, 110) sont des opérations identiques ; Base64 ne connaît pas et ne se soucie pas des caractères, de la langue ou de l'encodage.
Exemple concret : encodage manuel de « Man » – le binaire de M, a et n, les quatre indices et les quatre caractères de sortie
Il voit les octets. L'encodeur et le décodeur de l'outil ont une préoccupation distincte : la saisie textuelle comme Man passe d'abord par TextEncoder, se transformant en UTF-8 octets. Ces octets sont des entrées Base64. La sortie TWFu est du texte (caractères ASCII), mais représente des octets et non des mots. Différents outils de lecture TWFu récupèrent les octets (77, 97, 110) et doivent décider indépendamment s'ils représentent un mot, une image, un message dans un autre encodage ou autre chose.
Les entrées importantes sont de nombreuses répétitions de ce modèle. Un fichier 300-byte utilise 300/3 = 100 blocs de trois octets, chacun devenant quatre caractères, produisant 400 caractères de sortie. Lorsque le dernier bloc est complété, un décodeur supprime le remplissage à zéro plutôt que de fabriquer un autre octet. Cette limite est visible avec une entrée sur deux octets : trois indices utiles survivent, la quatrième position est un signe égal et seuls seize bits reconstruits appartiennent au résultat.
Inversion du processus : recherche d'index, regroupement de bits et destination des bits de remplissage lors du décodage de quatre caractères en trois octets
Parce que le modèle est régulier, le fonctionnement est rapide : décalage de bits, recherche, écriture. La seule irrégularité est le bloc final lorsque la longueur d'entrée n'est pas un multiple de trois, gérée par le remplissage. Parce que chaque bloc est indépendant (les bits d'un bloc n'affectent pas le suivant), Base64 peut encoder de manière incrémentielle : introduire des octets, extraire des caractères, sans attendre la totalité de l'entrée.
Base64url ne diffère que par la substitution alphabétique. Les indices 62 et 63 deviennent - et _ au lieu de + et /. Le regroupement des bits est identique ; Le mappage octet-caractère est identique ; seule la table de recherche change. Un décodeur manuel peut donc réutiliser chaque décalage et masque du standard Base64, en remplaçant uniquement ces deux symboles terminaux.
Pourquoi le résultat est une séquence d'octets, pas du texte - l'étape distincte qui transforme les octets en UTF-8 caractères
C'est pourquoi la section 5 de la RFC 4648 le décrit comme un alphabet distinct, et non comme un codage différent. La chaîne TWFu dans le standard Base64 est sans ambiguïté : elle ne peut signifier que des indices (19, 22, 5, 46). Dans base64url, la chaîne devrait contenir - ou _ pour différer, et sans ceux-ci, les mêmes indices s'appliquent.
Les erreurs d'implémentation impliquent généralement des erreurs ponctuelles dans les décalages de bits ou un mappage alphabétique incorrect. Un encodeur utilisant un mauvais ordre alphabétique produit une sortie différente si a et A étaient échangés. Un décodeur gérant mal le dernier bloc partiel (lorsque le remplissage est présent) peut récupérer un nombre erroné d'octets. L'encodeur et décodeur Base64 utilise l'alphabet standard et gère le remplissage par RFC 4648, vous pouvez donc coller n'importe quel exemple calculé manuellement et vérifier le travail.
Ce que cela ne couvre pas : base64url, retour à la ligne MIME et performances des grands tampons
Étant donné que les calculs binaires sont déterministes, toute erreur de codage manuel produira une sortie différente une fois décodée, ce qui rendra l'erreur immédiate. Base32 (section RFC 4648 6) étend le principe aux morceaux de cinq bits : les symboles 32 (A à Z et 2–7), de sorte que cinq bits tiennent exactement dans un caractère, et 40 bits (cinq octets) se regroupent en huit caractères. La même logique de regroupement s’applique ; la différence est la taille de l'alphabet et, par conséquent, le rapport entre les octets d'entrée et les caractères de sortie.
Hexadécimal (base16) utilise huit des 256 combinaisons de symboles possibles et mappe un octet sur deux caractères sans regroupement. Comprendre Base64 comme un regroupement de bits rend les variantes conceptuellement simples : choisissez les bits par caractère, regroupez les entrées en conséquence, recherchez chaque groupe dans l'alphabet. Lors du débogage de Base64, Bit Picture est votre outil. Si les octets ont été corrompus, codez-les à nouveau et comparez la sortie caractère par caractère. Si vous n'êtes pas sûr des octets que contient TWFu, décodez-le et examinez la sortie en hexadécimal.
À retenir : Base64 est un regroupement réversible de bits – comment l'encodeur et le décodeur Base64 vous permettent de vérifier instantanément n'importe quel bloc calculé manuellement dans le navigateur.
L'encodeur et le décodeur Base64 affiche à la fois les caractères et la vue hexadécimale, ce qui permet de vérifier facilement si l'on regarde des octets de texte (sera décodé en texte lisible) ou des données binaires (s'affichent en hexadécimal et sont mieux conservées sous forme d'octets, pas de texte). Le processus étape par étape (octets en bits, bits en indices, indices en caractères) est déterministe, rapide et identique dans chaque implémentation conforme. La RFC 4648 définit formellement Base64 afin que les implémentations puissent être comparées. La norme
spécifie l'alphabet, la disposition des bits, les règles de remplissage et la manière dont le retour à la ligne est géré dans MIME. Connaître la norme permet de vérifier facilement si le décodeur la suit strictement (Base64 canonique) ou accepte des variantes (remplissage manquant ou caractères sécurisés pour les URL). De nombreuses applications du monde réel utilisent Base64 de manière légèrement différente : certaines omettent le remplissage, d'autres utilisent des caractères sécurisés pour les URL, d'autres encore s'enroulent avec des longueurs de ligne différentes. L'encodeur et le décodeur Base64 gèrent automatiquement les variations, mais la compréhension de la norme simplifie grandement les problèmes d'intégration de débogage.