Entwicklertools · Base64-Encoder und -Decoder
Wie Base64 Schritt für Schritt drei Bytes in vier Zeichen umwandelt
· Wie es funktioniert
base64 Kodierung Unicode
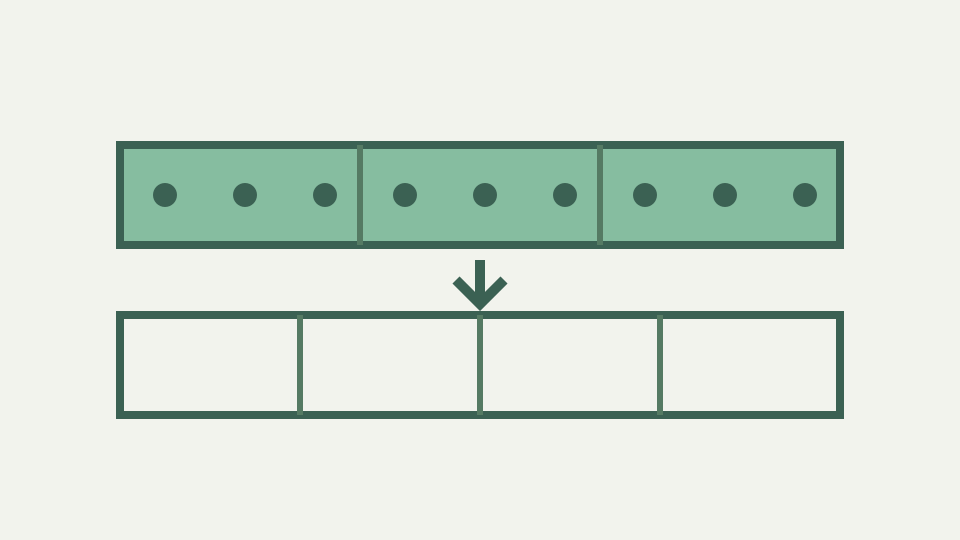
Base64 ist nichts anderes als die Neugruppierung von Bits: 24 Bits rein, vier 6-Bit-Indizes raus. In diesem Beitrag werden die Tabellensuche, die Bitverschiebung und die Rückwärtsfahrt erläutert, damit das Format keine Blackbox mehr ist.
Die Zeichenfolge „TWFu“ und das Wort, das sie verbirgt – beginnend mit einem echten Vier-Zeichen-Block und der Frage, woher jeder Buchstabe stammt
Die aus vier Zeichen bestehende Base64-Zeichenfolge TWFu dekodiert in die Drei-Byte-Sequenz Man. Wie aus drei Bytes vier Zeichen werden, zeigt, dass es sich bei Base64 nicht um Verschlüsselung oder Komprimierung, sondern um reine Bit-Umgruppierung handelt. Sobald Sie das Bit-Layout sehen, ist die Base64-Ausgabe nicht mehr undurchsichtig und wird vorhersehbar. Sie können Man manuell kodieren, es mit TWFu verifizieren und verstehen, warum Base64 immer vier Zeichen pro drei Bytes Eingabe ausgibt.
Die Magie von Base64 besteht darin, dass drei Bytes (24 Bits) perfekt in vier Blöcke zu je sechs Bits gruppiert werden. Sechs Bits stellen 0 bis 63 dar, weshalb das Alphabet genau 64 Symbole enthält: A–Z (26), a–z (26), 0–9 (10) und + und / (2). Jeder Sechs-Bit-Block wird alphabetisch indiziert, um ein Ausgabezeichen zu erzeugen. Die Umkehrung ist ebenso sauber: Vier Zeichen werden alphabetisch indiziert, um vier Sechs-Bit-Blöcke wiederherzustellen, die sich zu drei Bytes neu gruppieren.
Von Bytes zu 6-Bit-Indizes – wie 24-Bits in vier Gruppen aufgeteilt werden und warum 64-Symbole genau ausreichen
Deshalb fühlt sich Base64 überall natürlich an. Nehmen Sie drei Bytes M, a, n in ASCII: 0x4D, 0x61, 0x6E. Schreiben Sie im Binärformat: 01001101, 01100001, 01101110. Verketten Sie alle 24 Bits: 010011010110000101101110. Neugruppierung in vier Blöcke zu je sechs Bits: 010011 010110 000101 101110. Als Binärzahlen interpretieren: 19, 22, 5, 46. Index in Base64-Alphabet (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). Index 19 ist T, Index 22 ist W, Index 5 ist F, Index 46 ist u.
Ausgabe: TWFu. Die Indexsuche erfolgt mechanisch. Das Base64-Alphabet ist eine Reihenfolge, bei der es auf die Position ankommt: Jede Implementierung verwendet dieselbe Reihenfolge A–Z, a–z, 0–9, +, /.. Unterschiedliche Reihenfolge erzeugt unterschiedliche Ausgabe; Das Ändern der Reihenfolge ist genau die Funktionsweise von base64url. Im Standardalphabet belegen Großbuchstaben die Indizes 0–25, Kleinbuchstaben 26–51, Ziffern 52–61, Sonderzeichen 62–63. Diese Reihenfolge ist willkürlich, wird jedoch durch RFC festgelegt. Jeder Decoder erwartet die gleiche Zuordnung.
Die Alphabettabelle und Indexsuche – A–Z, a–z, 0–9, + und / in der Reihenfolge und warum die Reihenfolge für den Vergleich wichtig ist
Wenn Sie das Alphabet auf Papier schreiben und sorgfältig zählen, können Sie es manuell ohne Computer codieren: 19 nachschlagen, A B C...T zählen, T schreiben, wiederholen. Das Rückwärtsfahren ist ebenso einfach. Suchen Sie anhand von TWFu jedes Zeichen im Alphabet: T ist 19, W ist 22, F ist 5, u ist 46. Konvertieren in binär (führende Nullen für sechs Bits): 010011, 010110, 000101, 101110. Verketten: 010011010110000101101110.
Gruppe in drei Bytes zu je acht Bits: 01001101, 01100001, 01101110. Als Dezimalzahl oder Hexadezimalzahl interpretieren: 77, 97, 110 oder 0x4D, 0x61, 0x6E. In ASCII konvertieren: M, a, n. Sie haben die ursprünglichen drei Bytes wiederhergestellt. Aus diesem Grund ist Base64 reversibel und eine Auffüllung ist nur für Eingaben erforderlich, die nicht durch drei teilbar sind. Base64 kodiert exakte Bytes und nichts weiter. Encoding Man und Encoding Bytes (77, 97, 110) sind identische Vorgänge; Base64 kennt oder kümmert sich nicht um Zeichen, Sprache oder Kodierung.
Arbeitsbeispiel: „Man“ manuell kodieren – die Binärdatei von M, a und n, den vier Indizes und den vier Ausgabezeichen
Es sieht Bytes. Der Encoder und Decoder des Tools haben unterschiedliche Anliegen: Texteingaben wie Man durchlaufen zuerst TextEncoder und werden in UTF-8 Bytes umgewandelt. Diese Bytes sind Base64-Eingaben. Das ausgegebene TWFu besteht aus Text (ASCII-Zeichen), steht jedoch für Bytes, nicht für Wörter. Verschiedene Tools zum Lesen von TWFu stellen Bytes wieder her (77, 97, 110) und müssen unabhängig entscheiden, ob sie ein Wort, ein Bild, eine Nachricht in einer anderen Codierung oder etwas anderes darstellen.
Große Eingaben sind viele Wiederholungen dieses Musters. Eine 300-Byte-Datei verwendet 300/3 = 100 Blöcke mit drei Bytes, die jeweils zu vier Zeichen werden und 400 Ausgabezeichen erzeugen. Wenn der letzte Block aufgefüllt wird, verwirft ein Decoder die Nullfüllung, anstatt ein weiteres Byte zu erzeugen. Diese Grenze ist bei einer Zwei-Byte-Eingabe sichtbar: Drei nützliche Indizes bleiben erhalten, die vierte Position ist ein Gleichheitszeichen und nur sechzehn rekonstruierte Bits gehören zum Ergebnis.
Umkehrung des Prozesses – Indexsuche, Bitpacken und wohin die Füllbits gehen, wenn vier Zeichen in drei Bytes dekodiert werden
Da das Muster regelmäßig ist, ist die Operation schnell: Bitverschiebung, Nachschlagen, Schreiben. Die einzige Unregelmäßigkeit ist der letzte Block, wenn die Eingabelänge kein Vielfaches von drei ist und durch Auffüllen behandelt wird. Da jeder Block unabhängig ist – Bits eines Blocks wirken sich nicht auf den nächsten aus – kann Base64 inkrementell kodieren: Bytes einspeisen, Zeichen herausholen, ohne auf die gesamte Eingabe warten zu müssen.
Base64url unterscheidet sich nur in der Alphabetersetzung. Die Indizes 62 und 63 werden zu - und _ anstelle von + und /.. Die Bitumgruppierung ist identisch; Die Byte-zu-Zeichen-Zuordnung ist identisch. nur die Nachschlagetabelle ändert sich. Ein Handdecoder kann daher jede Verschiebung und Maske des Standard-Base64 wiederverwenden und nur diese beiden Terminalsymbole ersetzen.
Warum das Ergebnis eine Folge von Bytes und kein Text ist – der separate Schritt, der Bytes in UTF-8 Zeichen umwandelt
Aus diesem Grund beschreibt RFC 4648 Abschnitt 5 es als eigenständiges Alphabet, nicht als unterschiedliche Codierung. Der String TWFu im Standard-Base64 ist eindeutig: Er kann nur Indizes bedeuten (19, 22, 5, 46). In base64url müsste die Zeichenfolge - oder _ enthalten, um sich zu unterscheiden, und wenn diese nicht vorhanden sind, gelten dieselben Indizes.
Fehler bei der Implementierung sind in der Regel Einzelfehler bei Bitverschiebungen oder eine falsche Alphabetzuordnung. Ein Encoder mit falscher alphabetischer Reihenfolge erzeugt eine andere Ausgabe, wenn a und A vertauscht wurden. Ein Decoder, der den letzten Teilblock falsch behandelt (bei vorhandener Auffüllung), könnte die falsche Anzahl von Bytes wiederherstellen. Der Base64-Encoder und -Decoder verwendet Standardalphabet und übernimmt das Auffüllen durch RFC 4648, sodass Sie jedes handberechnete Beispiel einfügen und die Arbeit überprüfen können.
Was dies nicht abdeckt – base64url, MIME-Zeilenumbruch und die Leistung großer Puffer
Da Bit-Mathematik deterministisch ist, führt jeder Fehler bei der manuellen Codierung zu einer anderen Ausgabe bei der Decodierung, wodurch Fehler sofort auftreten. Base32 (RFC 4648 Abschnitt 6) erweitert das Prinzip auf Fünf-Bit-Blöcke: 32-Symbole (A–Z und 2–7), sodass fünf Bits genau in ein Zeichen passen und 40-Bits (fünf Bytes) in acht Zeichen umgruppiert werden. Es gilt die gleiche Umgruppierungslogik; Der Unterschied besteht in der Alphabetgröße und damit im Verhältnis von Eingabebytes zu Ausgabezeichen.
Hexadezimal (Basis 16) verwendet acht der 256 möglichen Symbolkombinationen und ordnet ein Byte zwei Zeichen ohne Umgruppierung zu. Base64 als Bit-Neugruppierung zu verstehen, macht Varianten konzeptionell einfach: Bits pro Zeichen auswählen, Eingaben entsprechend gruppieren, jede Gruppe alphabetisch nachschlagen. Beim Debuggen von Base64 ist Bitbild Ihr Werkzeug. Wenn Bytes beschädigt waren, kodieren Sie sie erneut und vergleichen Sie die Ausgabe Zeichen für Zeichen. Wenn Sie nicht sicher sind, welche Bytes TWFu enthält, dekodieren Sie es und überprüfen Sie die Ausgabe im Hexadezimalformat.
Takeaway: Base64 ist eine umkehrbare Neugruppierung von Bits – wie Sie mit dem Base64-Encoder und -Decoder jeden handberechneten Block sofort im Browser überprüfen können
Der Base64-Encoder und -Decoder zeigt sowohl die Zeichen- als auch die Hexadezimalansicht an, sodass leicht überprüft werden kann, ob Textbytes (wird in lesbaren Text dekodiert) oder Binärdaten (wird als Hexadezimaldaten angezeigt und am besten als Bytes und nicht als Text aufbewahrt) angezeigt werden. Der schrittweise Prozess – Bytes zu Bits, Bits zu Indizes, Indizes zu Zeichen – ist deterministisch, schnell und in jeder konformen Implementierung gleich. RFC 4648 definiert Base64 formal, sodass Implementierungen verglichen werden können.
Der Standard spezifiziert Alphabet, Bit-Layout, Auffüllregeln und wie der Zeilenumbruch in MIME gehandhabt wird. Wenn Sie den Standard kennen, können Sie leicht überprüfen, ob der Decoder ihn strikt befolgt (kanonisches Base64) oder Varianten akzeptiert (fehlende Auffüllung oder URL-sichere Zeichen). Viele reale Anwendungen verwenden Base64 etwas anders: Einige verzichten auf die Auffüllung, andere verwenden URL-sichere Zeichen, andere brechen mit unterschiedlichen Zeilenlängen um. Der Base64-Encoder und -Decoder verarbeitet Variationen automatisch, aber das Verständnis des Standards macht das Debuggen von Integrationsproblemen viel einfacher.