Strumenti per sviluppatori · Codificatore e decodificatore Base64
Come Base64 trasforma tre byte in quattro caratteri, passo dopo passo
· Come funziona
base64 codifica unicode
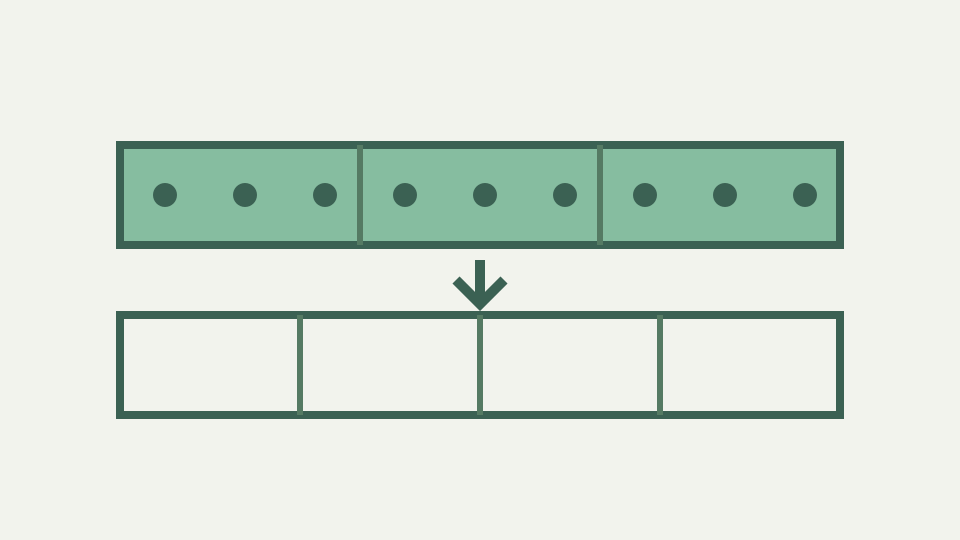
Base64 non è altro che raggruppare i bit: 24 bits in, quattro indici 6-bit in uscita. Questo post illustra la ricerca nella tabella, lo spostamento dei bit e il viaggio inverso in modo che il formato smetta di essere una scatola nera.
La stringa "TWFu" e la parola che nasconde, partendo da un vero blocco di quattro caratteri e chiedendo da dove provenga ciascuna lettera
La stringa Base64 TWFu di quattro caratteri viene decodificata nella sequenza di tre byte Man. Il modo in cui tre byte diventano quattro caratteri rivela che Base64 non è crittografia o compressione ma puro raggruppamento di bit. Una volta visualizzato il layout dei bit, l'output Base64 smette di essere opaco e diventa prevedibile. Puoi codificare Man manualmente, verificarlo rispetto a TWFu e capire perché Base64 restituisce sempre quattro caratteri per tre byte di input.
La magia di Base64 è che tre byte (24 bits) si raggruppano perfettamente in quattro blocchi da sei bit. Sei bit rappresentano da 0 a 63, motivo per cui l'alfabeto contiene esattamente simboli 64: A–Z (26), a–z (26), 0–9 (10) e + e / (2). Ogni blocco da sei bit viene indicizzato in alfabeto per produrre un carattere di output. Il contrario è altrettanto pulito: quattro caratteri vengono indicizzati in alfabeto per recuperare quattro blocchi da sei bit, che si raggruppano in tre byte.
Dai byte agli indici 6 bit: come sono suddivisi 24 bits in quattro gruppi e perché i simboli 64 sono esattamente sufficienti
Questo è il motivo per cui Base64 sembra naturale ovunque. Prendi tre byte M, a, n in ASCII: 0x4D, 0x61, 0x6E. Scrivi in binario: 01001101, 01100001, 01101110. Concatena tutti 24 bits: 010011010110000101101110. Raggruppare in quattro blocchi da sei bit: 010011 010110 000101 101110. Interpretare come numeri binari: 19, 22, 5, 46. Indice in alfabeto Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). L'indice 19 è T, l'indice 22 è W, l'indice 5 è F, l'indice 46 è u.
Uscita: TWFu. La ricerca dell'indice è meccanica. L'alfabeto Base64 è una sequenza in cui la posizione conta: ogni implementazione utilizza lo stesso ordine A–Z, a–z, 0–9, +, /. Ordine diverso produce output diverso; cambiare l'ordine è esattamente il modo in cui funziona base64url. Nell'alfabeto standard, le lettere maiuscole occupano gli indici 0–25, minuscole 26–51, cifre 52–61, caratteri speciali 62–63. Questo ordinamento è arbitrario ma fissato da RFC; ogni decoder si aspetta la stessa mappatura.
La tabella alfabetica e la ricerca nell'indice: A–Z, a–z, 0–9, + e / in ordine e perché l'ordine è importante per il confronto
Se scrivi l'alfabeto su carta e conti attentamente, puoi codificarlo manualmente senza computer: cerca 19, conta A B C...T, scrivi T, ripeti. La retromarcia è altrettanto semplice. Dato TWFu, cerca ogni carattere dell'alfabeto: T è 19, W è 22, F è 5, u è 46. Converti in binario (zeri iniziali per sei bit): 010011, 010110, 000101, 101110. Concatena: 010011010110000101101110.
Raggruppare in tre byte da otto bit: 01001101, 01100001, 01101110. Interpretare come decimale o esadecimale: 77, 97, 110 o 0x4D, 0x61, 0x6E. Converti in ASCII: M, a, n. Hai recuperato i tre byte originali. Questo è il motivo per cui Base64 è reversibile e perché il riempimento diventa necessario solo per input non divisibili per tre. Base64 codifica byte esatti e nient'altro. Encoding Man e encoding bytes (77, 97, 110) sono operazioni identiche; Base64 non conosce né si preoccupa dei caratteri, della lingua o della codifica.
Esempio realizzato: codificare "Man" a mano: il binario di M, a e n, i quattro indici e i quattro caratteri di output
Vede byte. Il codificatore e il decodificatore dello strumento si separano: l'input testuale come Man passa prima attraverso TextEncoder, trasformandosi in UTF-8 byte. Quei byte sono input Base64. L'output TWFu è testo (ASCII caratteri), ma sta per byte, non per parola. Diversi strumenti di lettura TWFu recuperano i byte (77, 97, 110) e devono decidere autonomamente se rappresentano parola, immagine, messaggio in un'altra codifica o qualcos'altro.
Gli input di grandi dimensioni sono molte ripetizioni di questo modello. Un file 300-byte utilizza 300/3 = 100 blocchi di tre byte, ciascuno dei quali diventa quattro caratteri, producendo caratteri di output 400. Quando l'ultimo blocco viene riempito, un decodificatore scarta il riempimento zero anziché produrre un altro byte. Quel confine è visibile con un input a due byte: sopravvivono tre indici utili, la quarta posizione è un segno di uguale e solo sedici bit ricostruiti appartengono al risultato.
Inversione del processo: ricerca dell'indice, impaccamento dei bit e posizione dei bit di riempimento durante la decodifica di quattro caratteri in tre byte
Poiché il modello è regolare, l'operazione è veloce: spostamento di bit, ricerca, scrittura. L'unica irregolarità è il blocco finale quando la lunghezza dell'input non è un multiplo di tre, gestito dal riempimento. Poiché ogni blocco è indipendente (i bit di un blocco non influiscono su quelli successivi) Base64 può codificare in modo incrementale: inserire byte, estrarre caratteri, senza attendere l'intero input.
Base64url differisce solo nella sostituzione dell'alfabeto. Gli indici 62 e 63 diventano - e _ invece di + e /. Il raggruppamento dei bit è identico; la mappatura byte-carattere è identica; cambia solo la tabella di ricerca. Un decodificatore manuale può quindi riutilizzare ogni spostamento e maschera dello standard Base64, sostituendo solo quei due simboli terminali.
Perché il risultato è una sequenza di byte, non testo: il passaggio separato che trasforma i byte in caratteri UTF-8
Questo è il motivo per cui la sezione RFC 4648 la sezione 5 lo descrive come un alfabeto distinto, non una codifica diversa. La stringa TWFu nello standard Base64 non è ambigua: può significare solo indici (19, 22, 5, 46). In base64url, la stringa dovrebbe contenere - o _ per differire e, senza quelli presenti, si applicano gli stessi indici.
Gli errori nell'implementazione di solito comportano errori singoli nello spostamento di bit o nella mappatura alfabetica errata. Un codificatore che utilizza un ordine alfabetico errato produce un output diverso se a e A vengono scambiati. Un decodificatore che gestisce in modo errato l'ultimo blocco parziale (quando è presente il riempimento) potrebbe recuperare un numero errato di byte. Il codificatore e decodificatore Base64 utilizza l'alfabeto standard e gestisce il riempimento tramite RFC 4648, in modo da poter incollare qualsiasi esempio calcolato manualmente e verificare il lavoro.
Cosa non copre: base64url, MIME ritorno a capo della riga e prestazioni di buffer di grandi dimensioni
Poiché la matematica dei bit è deterministica, qualsiasi errore nella codifica manuale produrrà un output diverso una volta decodificato, rendendo l'errore immediato. Base32 (RFC 4648 sezione 6) estende il principio a blocchi di cinque bit: simboli 32 (A–Z e 2–7), quindi cinque bit rientrano esattamente in un carattere e 40 bits (cinque byte) si raggruppano in otto caratteri. Si applica la stessa logica di raggruppamento; la differenza è la dimensione dell'alfabeto e di conseguenza il rapporto tra byte di input e caratteri di output.
L'esadecimale (base16) utilizza otto delle possibili combinazioni di simboli 256 e mappa un byte su due caratteri senza raggruppamento. Comprendere Base64 come raggruppamento di bit rende le varianti concettualmente semplici: scegli i bit per carattere, raggruppa l'input di conseguenza, cerca ciascun gruppo in alfabeto. Durante il debug di Base64, l'immagine bit è il tuo strumento. Se i byte sono danneggiati, codificarli nuovamente e confrontare l'output carattere per carattere. Se non sei sicuro di quali byte contenga TWFu, decodificalo ed esamina l'output in formato esadecimale.
Conclusione: Base64 è un raggruppamento reversibile di bit: in che modo il codificatore e decodificatore Base64 ti consente di controllare istantaneamente qualsiasi blocco calcolato manualmente nel browser
Il codificatore e decodificatore Base64 mostra sia i caratteri che la vista esadecimale, semplificando la verifica se si stanno guardando byte di testo (decodificheranno in testo leggibile) o dati binari (mostrati come esadecimali e meglio conservati come byte, non testo). Il processo passo passo (byte in bit, bit in indici, indici in caratteri) è deterministico, veloce, lo stesso in ogni implementazione conforme. RFC 4648 definisce formalmente Base64 in modo che le implementazioni possano essere confrontate.
Lo standard specifica l'alfabeto, il layout dei bit, le regole di riempimento e il modo in cui viene gestito il ritorno a capo della riga in MIME. Conoscere lo standard rende facile verificare se il decodificatore lo segue rigorosamente (Base64 canonico) o accetta varianti (imbottitura mancante o caratteri URL-safe). Molte applicazioni del mondo reale utilizzano Base64 in modo leggermente diverso: alcune omettono il riempimento, alcune utilizzano caratteri URL-safe, alcune vanno a capo a lunghezze di riga diverse. Il codificatore e decodificatore Base64 gestisce le variazioni automaticamente, ma la comprensione dello standard rende molto più semplice il debug dei problemi di integrazione.