Ferramentas de desenvolvedor · Codificador e decodificador Base64
Como Base64 transforma três bytes em quatro caracteres, passo a passo
· Como funciona
base64 codificação Unicode
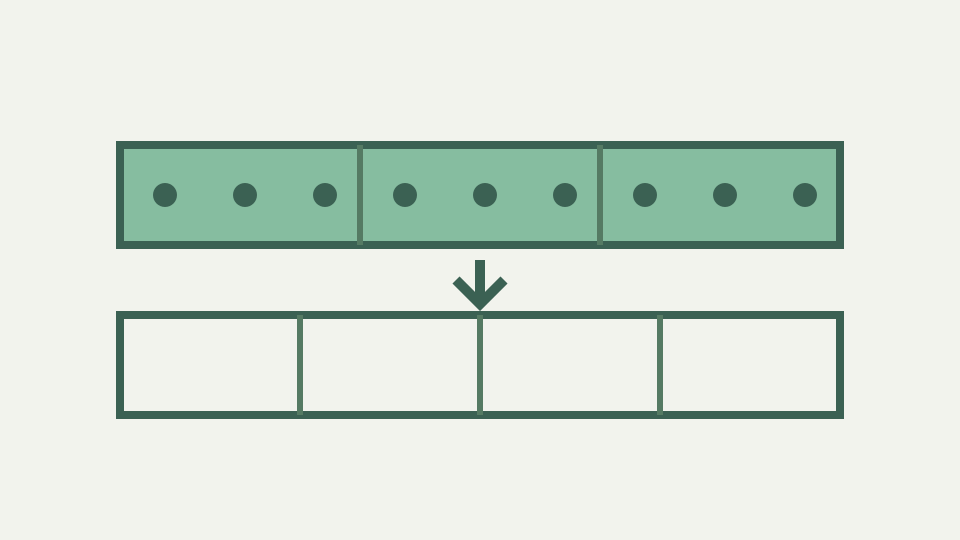
Base64 nada mais é do que reagrupar bits: 24 bits de entrada, quatro índices de 6 bits de saída. Este post percorre a pesquisa da tabela, a mudança de bits e a viagem reversa para que o formato deixe de ser uma caixa preta.
A string 'TWFu' e a palavra que ela esconde - começando com um bloco real de quatro caracteres e perguntando de onde veio cada letra
A string Base64 de quatro caracteres TWFu é decodificada para a sequência de três bytes Man. A maneira como três bytes se transformam em quatro caracteres revela que Base64 não é criptografia ou compactação, mas puro reagrupamento de bits. Depois de ver o layout dos bits, a saída Base64 deixa de ser opaca e se torna previsível. Você pode codificar Man manualmente, verificá-lo em relação ao TWFu e entender por que Base64 sempre gera quatro caracteres por três bytes de entrada.
A mágica do Base64 é que três bytes (24 bits) se reagrupam perfeitamente em quatro pedaços de seis bits. Seis bits representam 0 a 63, e é por isso que o alfabeto contém exatamente símbolos 64: A – Z (26), a – z (26), 0–9 (10) e + e / (2). Cada pedaço de seis bits é indexado no alfabeto para produzir um caractere de saída. O inverso é igualmente limpo: quatro caracteres indexados em alfabeto para recuperar quatro pedaços de seis bits, que se reagrupam em três bytes.
De bytes a índices de 6 bits — como 24 bits são divididos em quatro grupos e por que os símbolos 64 são exatamente suficientes
É por isso que o Base64 parece natural em todos os lugares. Pegue três bytes M, a, n em ASCII: 0x4D, 0x61, 0x6E. Escreva em binário: 01001101, 01100001, 01101110. Concatene todos os 24 bits: 010011010110000101101110. Reagrupe em quatro pedaços de seis bits: 010011 010110 000101 101110. Interprete como números binários: 19, 22, 5, 46. Indexar no alfabeto Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). Índice 19 é T, índice 22 é W, índice 5 é F, índice 46 é u.
Saída: TWFu. A pesquisa do índice é mecânica. O alfabeto Base64 é uma sequência onde a posição é importante: cada implementação usa a mesma ordem A – Z, a – z, 0–9, +, /. Ordem diferente produz saída diferente; alterar a ordem é exatamente como base64url funciona. No alfabeto padrão, letras maiúsculas ocupam índices 0–25, minúsculas 26–51, dígitos 52–61, caracteres especiais 62–63. Esta ordem é arbitrária, mas corrigida por RFC; todo decodificador espera o mesmo mapeamento.
A tabela alfabética e a pesquisa de índice - A – Z, a – z, 0–9, + e / em ordem, e por que a ordem é importante para comparação
Se você escrever o alfabeto no papel e contar com cuidado, poderá codificar manualmente sem computador: procure 19, conte A B C...T, escreva T, repita. A reversão é igualmente simples. Dado o TWFu, procure cada caractere no alfabeto: T é 19, W é 22, F é 5, u é 46. Converter para binário (zeros à esquerda para seis bits): 010011, 010110, 000101, 101110. Concatenar: 010011010110000101101110.
Agrupe em três bytes de oito bits: 01001101, 01100001, 01101110. Interprete como decimal ou hexadecimal: 77, 97, 110 ou 0x4D, 0x61, 0x6E. Converter para ASCII: M, a, n. Você recuperou os três bytes originais. É por isso que Base64 é reversível e o preenchimento se torna necessário apenas para entradas não divisíveis por três. Base64 codifica bytes exatos e nada mais. Codificação Man e codificação de bytes (77, 97, 110) são operações idênticas; Base64 não conhece nem se preocupa com caracteres, linguagem ou codificação.
Exemplo resolvido: codificando 'Man' manualmente - o binário de M, aen, os quatro índices e os quatro caracteres de saída
Ele vê bytes. A preocupação separada do codificador e do decodificador da ferramenta: a entrada textual como Man passa primeiro pelo TextEncoder, transformando-se em UTF-8 bytes. Esses bytes são entrada Base64. A saída TWFu é texto (ASCII caracteres), mas significa bytes, não palavra. Diferente ferramenta de leitura TWFu recupera bytes (77, 97, 110) e deve decidir de forma independente se eles representam palavra, imagem, mensagem em outra codificação ou outra coisa.
Grandes entradas são muitas repetições desse padrão. Um arquivo de 300 bytes usa 300/3 = 100 blocos de três bytes, cada um se tornando quatro caracteres, produzindo 400 caracteres de saída. Quando o último bloco é preenchido, um decodificador descarta o preenchimento zero em vez de fabricar outro byte. Esse limite é visível com uma entrada de dois bytes: três índices úteis sobrevivem, a quarta posição é um sinal de igual e apenas dezesseis bits reconstruídos pertencem ao resultado.
Revertendo o processo - pesquisa de índice, empacotamento de bits e para onde vão os bits de preenchimento ao decodificar quatro caracteres em três bytes
Como o padrão é regular, a operação é rápida: mudança de bit, pesquisa, gravação. A única irregularidade é o bloco final quando o comprimento da entrada não é múltiplo de três, tratado por preenchimento. Como cada bloco é independente – os bits de um bloco não afetam o próximo – o Base64 pode codificar de forma incremental: alimentar bytes, retirar caracteres, sem esperar pela entrada inteira.
Base64url difere apenas na substituição do alfabeto. Os índices 62 e 63 tornam-se - e _ em vez de + e /. O reagrupamento de bits é idêntico; o mapeamento de byte para caractere é idêntico; apenas a tabela de pesquisa muda. Um decodificador manual pode, portanto, reutilizar cada deslocamento e máscara do Base64 padrão, substituindo apenas esses dois símbolos de terminal.
Por que o resultado é uma sequência de bytes, não texto — a etapa separada que transforma bytes em caracteres UTF-8
É por isso que a seção RFC 4648 5 o descreve como um alfabeto distinto, não como uma codificação diferente. A string TWFu no Base64 padrão é inequívoca: só pode significar índices (19, 22, 5, 46). Em base64url, a string precisaria conter - ou _ para diferir e, sem esses presentes, os mesmos índices se aplicam.
Erros na implementação geralmente envolvem erros isolados em mudanças de bits ou mapeamento incorreto do alfabeto. Um codificador usando ordem alfabética errada produz resultados diferentes se a e A forem trocados. Um decodificador que manipula incorretamente o último bloco parcial (quando há preenchimento) pode recuperar um número errado de bytes. O codificador e decodificador Base64 usa alfabeto padrão e lida com preenchimento por RFC 4648, para que você possa colar qualquer exemplo computado manualmente e verificar o trabalho.
O que isso não cobre — base64url, quebra de linha MIME e desempenho de buffers grandes
Como a matemática de bits é determinística, qualquer erro na codificação manual produzirá resultados diferentes quando decodificado, tornando o erro imediato. Base32 (RFC 4648 seção 6) estende o princípio para pedaços de cinco bits: símbolos 32 (A – Z e 2–7), então cinco bits cabem exatamente em um caractere, e 40 bits (cinco bytes) se reagrupam em oito caracteres. A mesma lógica de reagrupamento se aplica; A diferença é o tamanho do alfabeto e, conseqüentemente, a proporção entre bytes de entrada e caracteres de saída.
Hexadecimal (base16) usa oito das 256 combinações de símbolos possíveis e mapeia um byte para dois caracteres sem reagrupamento. Compreender Base64 como reagrupamento de bits torna as variantes conceitualmente simples: escolha bits por caractere, agrupe a entrada de acordo, procure cada grupo em ordem alfabética. Ao depurar Base64, a imagem de bits é a sua ferramenta. Se os bytes foram corrompidos, codifique-os novamente e compare a saída caractere por caractere. Se não tiver certeza de quais bytes o TWFu contém, decodifique-o e examine a saída em hexadecimal.
Conclusão: Base64 é um reagrupamento reversível de bits – como o codificador e decodificador Base64 permite verificar qualquer bloco computado manualmente instantaneamente no navegador
O codificador e decodificador Base64 mostra caracteres e visualização hexadecimal, simplificando a verificação se está olhando para bytes de texto (será decodificado em texto legível) ou dados binários (mostrados como hexadecimal e melhor mantidos como bytes, não como texto). O processo passo a passo – bytes para bits, bits para índices, índices para caracteres – é determinístico, rápido e o mesmo em todas as implementações compatíveis. RFC 4648 define Base64 formalmente para que as implementações possam ser comparadas.
O padrão especifica alfabeto, layout de bits, regras de preenchimento e como a quebra de linha é tratada em MIME. Conhecer o padrão facilita verificar se o decodificador o segue estritamente (Base64 canônico) ou aceita variantes (preenchimento ausente ou caracteres seguros URL). Muitos aplicativos do mundo real usam Base64 de maneira um pouco diferente: alguns omitem o preenchimento, alguns usam caracteres seguros URL, alguns quebram em comprimentos de linha diferentes. O codificador e decodificador Base64 lida com variações automaticamente, mas a compreensão do padrão torna a depuração de problemas de integração muito mais simples.