Ferramentas de desenvolvedor · Codificador e decodificador Base64
Base64 vs base64url: por que um decodificador padrão rejeita - e _
· Como funciona
base64 codificação fluxo de trabalho do desenvolvedor
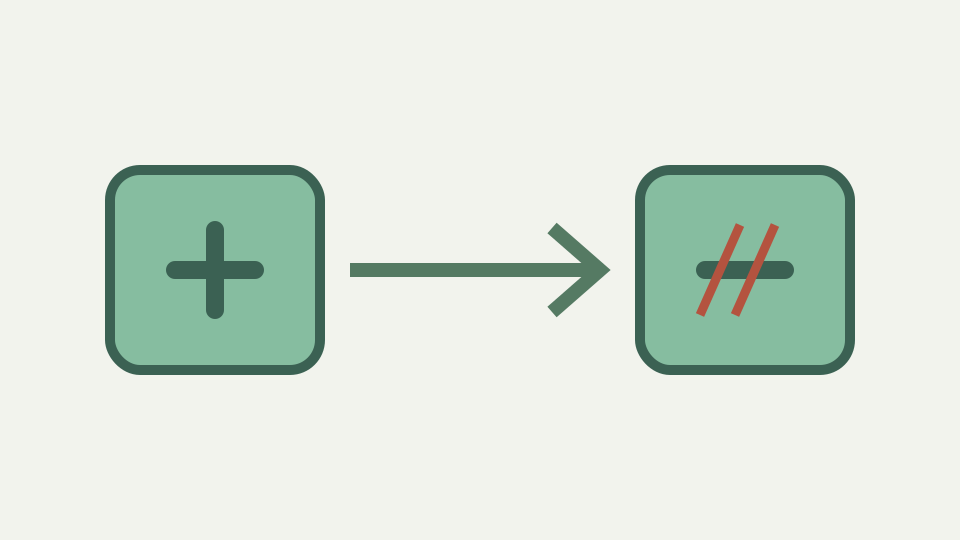
base64url troca + e / por - e _ para que a saída possa viajar em URLs e nomes de arquivos sem escapar. Esta postagem explica os dois alfabetos, como converter entre eles e por que o preenchimento também costuma ser eliminado.
O token que decodifica todos os lugares, exceto o seu código — um erro de caractere inválido causado por um único - ou _
Um segmento JWT falha ao ser decodificado no decodificador Base64 padrão com erro de caractere inválido nomenclatura do traço. Mas visualmente, nenhum traço aparece. Olhe novamente – é verdade. A versão base64url usa - onde o padrão Base64 usa + e _ onde usa /. Muitos decodificadores aceitam apenas um alfabeto, e o token codificado para a segurança URL será rejeitado pelo código que espera o padrão RFC 4648 Base64.
Os dois alfabetos são equivalentes; a conversão entre eles é uma substituição mecânica de caracteres. O problema surge porque + e / têm significados em URLs. Um sinal de mais representa espaço nos dados do formulário application/x-www-form-urlencoded. A barra é o separador de caminho em URL. Se você incorporar Base64 diretamente no parâmetro de consulta URL sem codificação percentual + e o decodificador /, poderá interpretá-los incorretamente.
Por que + e / são um problema em URLs e nomes de arquivos — o significado reservado de / em caminhos e de + como espaço nos dados do formulário
A + pode ser lido como espaço antes de chegar ao decodificador. A / poderia dividir o valor do parâmetro no lugar errado. RFC 4648 seção 5 define o alfabeto base64url para eliminar ambiguidade: use - em vez de + e _ em vez de /, para que a saída seja segura em URLs e nomes de arquivos. Os dois alfabetos são idênticos, exceto dois caracteres.
Base64 padrão usa caracteres nas posições 62 e 63: A–Z (0–25), a–z (26–51), 0–9 (52–61), + (62), / (63). base64url usa A–Z (0–25), a–z (26–51), 0–9 (52–61), - (62), _ (63). Todo o resto – reagrupamento de bits, regras de preenchimento, mapeamento de bits para índices – é o mesmo. A sequência de índices para Base64 padrão produzirá uma sequência de índices para base64url; apenas os caracteres nas posições 62 e 63 serão diferentes.
O alfabeto base64url da seção RFC 4648 5 — os dois caracteres substituídos e por que nada mais muda
Se a entrada não contiver índices 62 ou 63 (não + ou / no padrão, não - ou _ em base64url), ambos os alfabetos produzem saída idêntica. Converter Base64 padrão em base64url é simples, encontre e substitua: swap + for - e / for _. A decodificação da string base64url no Base64 padrão requer reversão: swap - para + e _ para /.
A conversão é simétrica e sempre válida. Se você encontrar um token que falha na decodificação com nomenclatura de erro de caractere inválido - ou _, verifique se o decodificador aceita base64url. Caso contrário, aplique a substituição de caracteres e, se a entrada estiver bem formada, a decodificação deverá ser bem-sucedida. Considere o cabeçalho JWT {"alg":"HS256","typ":"JWT"} codificado como base64url. Os bytes UTF-8 padrão passam por reagrupamento de bits: três bytes tornam-se quatro índices, pesquisados no alfabeto base64url. ToolAcre expõe o preenchimento como uma escolha do codificador em vez de vinculá-lo à alternância do alfabeto. Essa separação é uma evidência útil: a saída segura de URL pode ser preenchida ou não, enquanto o decodificador normaliza qualquer forma antes de chamar o navegador primitivo. Alfabeto e preenchimento são convenções relacionadas, não uma opção.
O preenchimento em base64url é opcional por convenção - por que os JWTs omitem = e como um decodificador pode restaurá-lo a partir do comprimento
Quando o índice é 62, o caractere de saída é -; quando 63, a saída é _. Bytes idênticos através do alfabeto padrão produziriam + no índice 62 e / no índice 63. A conversão do resultado base64url para o padrão é uma operação caractere por caractere: procure por - e substitua por +, procure por _ e substitua por /, e decodifique normalmente.
Os bytes recuperados são idênticos porque os índices eram idênticos; apenas os símbolos diferem. O preenchimento em base64url é opcional por convenção, embora o padrão permita isso. Os JWTs são estruturados como três segmentos base64url unidos por pontos; cada segmento usa preenchimento, se necessário, mas muitas implementações o omitem e dependem do fato de que o aplicativo consumidor conhece o comprimento de bytes esperado.
Exemplo resolvido: conversão de um segmento de cabeçalho JWT para Base64 padrão — substituição de caracteres, adição de preenchimento, decodificação para JSON
Um decodificador pode restaurar o preenchimento ausente dividindo o comprimento da string por quatro, calculando o restante, anexando sinais de igual a 0, 1 ou 2. Se o comprimento da string não for múltiplo de quatro, a falta de preenchimento é evidente. Se o comprimento for múltiplo de quatro, a string foi preenchida e o preenchimento removido ou a entrada já é um múltiplo de quatro bytes (terminando com três bytes no bloco final, sem necessidade de preenchimento).
A concatenação de segmentos base64url requer atenção ao preenchimento. Se três segmentos terminarem com =, a concatenação produz diretamente strings como AAAA=BBBB=CCCC=, onde o preenchimento no meio agora são caracteres perdidos, não marcadores de terminação. É por isso que os JWTs omitem o preenchimento em cada segmento: a estrutura de três segmentos é explícita, portanto, a decodificação ocorre independentemente em cada parte, e o preenchimento no meio da string concatenada é desnecessário e interromperia a análise.
Erros comuns - misturar alfabetos em uma string ou codificação percentual Base64 padrão em vez de usar base64url
Se estiver construindo uma carga útil de vários segmentos, decida a convenção de preenchimento no início: inclua em cada segmento e nunca concatene diretamente ou omita e restaure o comprimento apenas durante a decodificação. O padrão RFC 4648 é autoridade em ambos os alfabetos. A seção 4 especifica Base64 padrão; a seção 5 especifica base64url. Todo decodificador conforme deve indicar claramente qual alfabeto aceita.
O código que aceita base64url, mas não o Base64 padrão (ou vice-versa), está implementando apenas um subconjunto. O alfabeto base64url existe para compatibilidade com URL e restrições de nome de arquivo; não é melhoria ou substituição, apenas variante para contexto específico. Ao criar API ou formato de token, escolha um alfabeto e documente qual. Um erro comum é a codificação percentual Base64 padrão em vez de usar base64url. A implementação também explica o limite do artigo. Ele normaliza o hífen e o sublinhado antes da decodificação, mas não verifica uma assinatura de token nem interpreta declarações. A conversão de um segmento JWT em bytes pode revelar JSON; não é possível estabelecer quem emitiu esse JSON ou se alguém o alterou.
O que isso não cobre – verificação de assinaturas JWT, base32 e outras codificações RFC 4648
%2B é o código percentual para +; %2F é o código percentual para /. A codificação percentual transforma TWFu em TWFu inalterado (sem caracteres especiais), mas TE9S+g== em TE9S%2Bg%3D%3D (muitos caracteres para manipular). A solução correta é usar base64url, que já produz uma saída segura URL. A codificação percentual Base64 é supérflua e um desperdício. Use o alfabeto correto para contexto. O codificador e decodificador Base64 aceita ambos os alfabetos automaticamente.
Se você colar uma string contendo -, ela será tratada como base64url; se colar a string contendo +, ela será tratada como Base64 padrão. A ferramenta também aceita URLs e os trata como entrada segura URL. Uma verificação prática tem, portanto, dois resultados independentes: o percurso de ida e volta dos bytes e a representação escolhida se ajusta ao seu canal. Passar no primeiro indica que a transformação é reversível. Passar o segundo indica que a pontuação e o preenchimento não serão reescritos pelo URL, nome do arquivo, cookie ou protocolo que os transporta.
Conclusão: dois alfabetos, layout de um bit - como o codificador e decodificador Base64 lida com o alfabeto padrão no navegador e onde sua página de ferramentas indica o que aceita
Ao decodificar o segmento JWT ou o token seguro URL, você pode colar diretamente sem conversão, e a ferramenta identifica o alfabeto a partir do contexto. A depuração da decodificação com falha torna-se simples: cole o token, veja se a ferramenta o aceita e, caso contrário, troque manualmente os caracteres e tente novamente.
A substituição em si é uma linha de código, mas uma falha na decodificação também pode vir de comprimento impossível, preenchimento mal colocado, corrupção ou entrada não Base64. A ferramenta normaliza ambos os alfabetos automaticamente, portanto a aceitação confirma apenas que os bytes podem ser recuperados. Uma carga útil JWT decodificada ainda é uma declaração não assinada até que um verificador separado verifique sua assinatura e o algoritmo esperado.