開発者ツール · Base64 エンコーダーおよびデコーダー
Base64 と Base64url: 標準デコーダが拒否する理由 - および _
· 仕組み
base64 エンコード 開発者ワークフロー
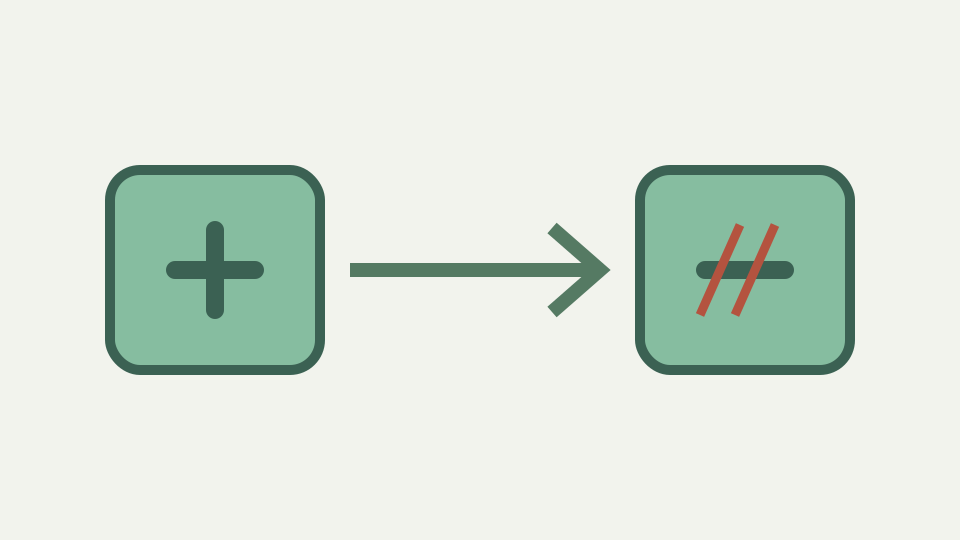
base64url は、+ と / を - と _ に置き換えるので、出力はエスケープせずに URL とファイル名内を移動できます。この記事では、2 つのアルファベット、それらの間の変換方法、および通常パディングも削除される理由について説明します。
コードを除くすべての場所をデコードするトークン (単一の - または _ によって引き起こされる無効文字エラー)
JWT セグメントは、ダッシュ名の無効な文字エラーにより、標準 Base64 デコーダでのデコードに失敗します。ただし、視覚的にはダッシュは表示されません。もう一度見てください、そうです。 Base64url バージョンでは、標準 Base64 では + が使用され、/. では _ が使用されます。多くのデコーダーは 1 つのアルファベットのみを受け入れ、URL 安全性のためにエンコードされたトークンは、RFC 4648 標準 Base64 を期待するコードによって拒否されます。
2 つのアルファベットは同等です。それらの間の変換は、機械的な文字の置換です。この問題は、URL 内で + と / が意味を持つために発生します。プラス記号は、application/x-www-form-urlencoded フォーム データ内のスペースを表します。スラッシュは URL のパス区切り文字です。パーセントエンコーディング + および /, を使用せずに Base64 を URL クエリ パラメーターに直接埋め込むと、デコーダーがそれらを誤って解釈する可能性があります。
URL とファイル名で + と / が問題になる理由 — パス内の / とフォーム データ内のスペースとしての + の予約された意味
A + は、デコーダに到達する前にスペースとして読み取られる可能性があります。 / はパラメータ値を間違った場所で分割する可能性がありました。 RFC 4648 セクション 5 では、あいまいさを排除するために、base64url アルファベットを定義しています。+ の代わりに - を、/, の代わりに _ を使用して、URL とファイル名での出力が安全であるようにします。 2 つのアルファベットは 2 文字を除いて同一です。
標準 Base64 は、62 および 63 の位置にある文字を使用します: A ~ Z (0–25)、a ~ z (26–51)、0–9 (52–61)、+ (62)、/ (63)。 Base64url では、A ~ Z (0–25)、a–z (26–51)、0–9 (52–61)、- を使用します。 (62)、_ (63)。それ以外のすべて (ビットの再グループ化、パディング ルール、ビットのインデックスへのマッピング) は同じです。標準 Base64 のインデックスの文字列は、base64url のインデックスの文字列を生成します。 62 と 63 の位置にある文字のみが異なります。
RFC 4648 セクション 5 の Base64url アルファベット — 置換された 2 つの文字と、他に何も変更がない理由
入力にインデックス 62 または 63 (標準では + または /、base64url では - または _ がない) が含まれていない場合、両方のアルファベットは同一の出力を生成します。標準の Base64 から Base64url への変換は、+ を - に、/ を _ に置き換える、簡単な検索と置換です。標準の Base64 で Base64url 文字列をデコードするには、逆の処理が必要です。/. の場合は、+ と _ を交換します。
変換は対称的で常に有効です。無効な文字エラーの名前付け - または _ でデコードに失敗するトークンが発生した場合は、デコーダーがbase64url を受け入れるかどうかを確認してください。そうでない場合は、文字置換を適用します。入力がその他の形式で整っていれば、デコードは成功するはずです。 Base64url としてエンコードされた JWT ヘッダー {"alg":"HS256","typ":"JWT"} を考えてみましょう。標準の UTF-8 バイトはビットの再グループ化を経て、3 バイトが 4 つのインデックスになり、base64url アルファベットで検索されます。 ToolAcre は、パディングをアルファベットのトグルに結び付けるのではなく、エンコーダーの選択肢として公開します。この分離は有用な証拠です。URL セーフな出力は埋め込みまたは埋め込みなしで行うことができますが、デコーダーはブラウザー プリミティブを呼び出す前にどちらかの形式を正規化します。アルファベットとパディングは関連する規則であり、1 つのスイッチではありません。
Base64url のパディングは慣例によりオプションです — JWT が = を省略する理由と、デコーダーが長さからそれを復元する方法
インデックスが 62 の場合、出力文字は -; 63 の場合、出力は _ です。標準アルファベットによる同一のバイトは、インデックス 62 で + を生成し、インデックス 63 で / を生成します。 Base64url の結果を標準に変換することは文字ごとの操作です。 - をスキャンして + に置き換え、_ をスキャンして /, に置き換えて、通常どおりデコードします。
インデックスが同一であるため、回復するバイトは同一です。記号のみが異なります。 Base64url のパディングは、標準では許可されていますが、慣例によりオプションです。 JWT は、ドットで結合された 3 つの Base64url セグメントとして構造化されています。各セグメントは必要に応じてパディングを使用しますが、多くの実装ではパディングが省略され、使用するアプリケーションが予期されるバイト長を知っているという事実に依存しています。
作業例: JWT ヘッダー セグメントを標準 Base64 に変換 — 文字の置換、パディングの追加、JSON へのデコード
デコーダは、文字列の長さを 4 で割って余りを計算し、0、1、または 2 の等号を追加することで、不足しているパディングを復元できます。文字列の長さが 4 の倍数でない場合、パディングの欠落が明らかです。長さが 4 の倍数の場合、文字列はパディングされてからパディングが削除されたか、すでに 4 バイトの倍数が入力されています (最終ブロックの 3 バイトで終わるため、パディングは必要ありません)。
Base64url セグメントを連結するには、パディングに注意する必要があります。 3 つのセグメントがそれぞれ = で終わる場合、連結すると AAAA=BBBB=CCCC= のような文字列が直接生成されます。ここで、中間のパディングは終了マーカーではなく、浮遊文字になります。これが、JWT が各セグメントのパディングを省略する理由です。3 つのセグメント構造は明示的であるため、デコードは各部分で独立して進行し、連結された文字列の途中でのパディングは不要であり、解析が中断されます。
よくある間違い - 1 つの文字列にアルファベットを混ぜたり、base64url を使用せずに標準 Base64 をパーセントエンコーディングしたりする
マルチセグメントのペイロードを構築する場合は、開始時にパディング規則を決定します。各セグメントに含めて直接連結しないか、省略してデコード時にのみ長さから復元します。 RFC 4648 標準は、両方のアルファベットに関する権威です。セクション 4 は標準の Base64 を指定します。セクション 5 では、base64url を指定します。準拠するすべてのデコーダは、どのアルファベットを受け入れるかを明確に示す必要があります。
コードは、base64url を受け入れますが、標準の Base64 を受け入れません (またはその逆) が、サブセットのみを実装しています。 Base64url アルファベットは、URL およびファイル名の制約との互換性のために存在します。これは改善や置き換えではなく、特定のコンテキストに合わせて変更したものにすぎません。 API またはトークン形式を作成するときは、アルファベットを 1 つ選択し、それを文書化します。よくある間違いは、base64url を使用せずに、標準の Base64 をパーセントエンコーディングすることです。この実装では、記事の境界についても説明します。デコード前にハイフンとアンダースコアを正規化しますが、トークンの署名の検証やクレームの解釈は行いません。 JWT セグメントをバイトに変換すると、JSON が明らかになります。誰が JSON を発行したか、または誰かがそれを変更したかどうかを確認することはできません。
これでカバーされないもの — JWT 署名、base32、およびその他の RFC 4648 エンコーディングの検証
%2B は + のパーセント コードです。 %2F は /. のパーセント コードです。 パーセント エンコードでは、TWFu は変更されず TWFu に変わります (特殊文字なし) が、TE9S+g== は TE9S%2Bg%3D%3D に変わります (文字数が多すぎて処理できません)。正しい解決策は、URL セーフな出力をすでに生成している Base64url を使用することです。 Base64 のパーセント エンコードは不必要で無駄です。文脈に合わせて正しいアルファベットを使用してください。 Base64 エンコーダとデコーダは両方のアルファベットを自動的に受け入れます。
- を含む文字列を貼り付けると、base64url として扱われます。 + を含む文字列を貼り付けると、標準の Base64 として扱われます。このツールは URL も受け入れ、URL セーフな入力として扱います。したがって、実際のチェックでは、往復のバイト数と、選択された表現がそのチャネルに適合するという 2 つの独立した結果が得られます。最初の値を渡すと、変換が可逆的であることがわかります。 2 番目を渡すと、句読点とパディングが URL、ファイル名、Cookie、またはそれを運ぶプロトコルによって書き換えられないことになります。
要点: 2 つのアルファベット、1 ビット レイアウト — Base64 エンコーダーとデコーダーがブラウザーで標準アルファベットをどのように処理するか、およびそのツール ページに何を受け入れるかが記載されている場所
JWT セグメントまたは URL セーフ トークンをデコードする場合、変換せずに直接貼り付けることができ、ツールはコンテキストからアルファベットを識別します。失敗したデコードのデバッグは簡単になります。トークンを貼り付け、ツールがそれを受け入れるかどうかを確認し、受け入れられない場合は手動で文字を交換して再試行します。
置換自体は 1 行のコードですが、デコードの失敗は、不可能な長さ、パディングの位置の誤り、破損、または Base64 以外の入力が原因である可能性もあります。このツールは両方のアルファベットを自動的に正規化するため、受け入れられた場合はバイトが回復できることのみが確認されます。デコードされた JWT ペイロードは、別の検証者がその署名と予期されるアルゴリズムをチェックするまで、署名されていないクレームのままです。