เครื่องมือสำหรับนักพัฒนา · ตัวเข้ารหัสและตัวถอดรหัส Base64
Base64 กับ base64url: เหตุใดตัวถอดรหัสมาตรฐานจึงปฏิเสธ - และ _
· มันทำงานอย่างไร
base64 การเข้ารหัส นักพัฒนาเวิร์กโฟลว์
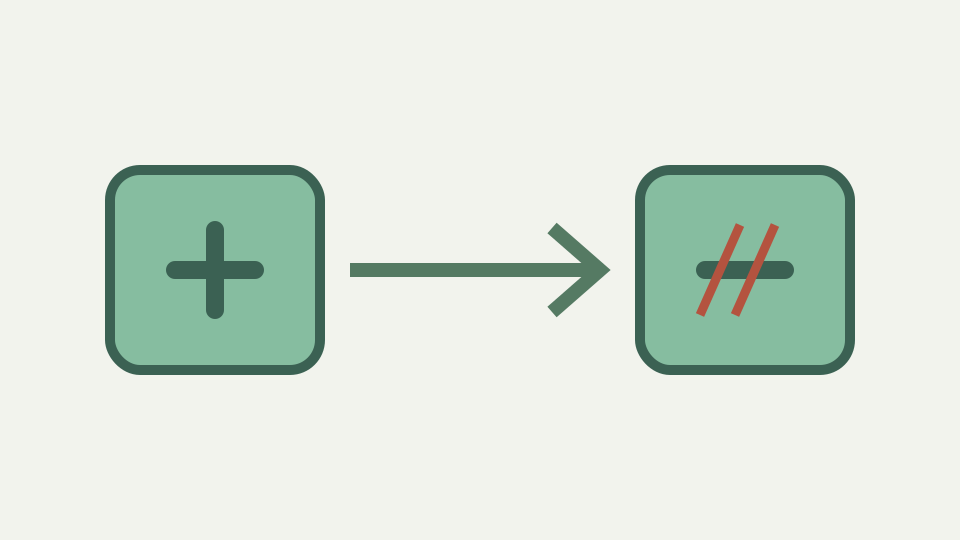
base64url swaps + และ / for - และ _ เพื่อให้เอาต์พุตสามารถเดินทางใน URL และชื่อไฟล์ได้โดยไม่ต้องหลบหนี โพสต์นี้จะอธิบายตัวอักษรสองตัว วิธีแปลงระหว่างตัวอักษรเหล่านั้น และเหตุใดช่องว่างภายในจึงมักจะหลุดออกไปเช่นกัน
โทเค็นที่ถอดรหัสได้ทุกที่ยกเว้นรหัสของคุณ - ข้อผิดพลาดอักขระที่ไม่ถูกต้องเกิดจาก - หรือ _ ตัวเดียว
เซ็กเมนต์ JWT ไม่สามารถถอดรหัสในตัวถอดรหัส Base64 มาตรฐานซึ่งมีข้อผิดพลาดในการตั้งชื่ออักขระที่ไม่ถูกต้อง แต่มองเห็นแล้วไม่มีเส้นประปรากฏขึ้น ดูอีกครั้ง - มันเป็นเช่นนั้น เวอร์ชัน base64url ใช้ - โดยที่ Base64 มาตรฐานใช้ + และ _ โดยที่ใช้ /. ตัวถอดรหัสจำนวนมากยอมรับเพียงตัวอักษรเดียว และโทเค็นที่เข้ารหัสเพื่อความปลอดภัย URL จะถูกปฏิเสธโดยโค้ดที่คาดหวัง RFC 4648 มาตรฐาน Base64
ตัวอักษรทั้งสองมีค่าเท่ากัน การแปลงระหว่างพวกเขาคือการแทนที่อักขระทางกล ปัญหาเกิดขึ้นเนื่องจาก + และ / มีความหมายใน URL เครื่องหมายบวกแสดงถึงช่องว่างในข้อมูลแบบฟอร์ม application/x-www-form-urlencoded เครื่องหมายทับคือตัวคั่นเส้นทางใน URL หากคุณฝัง Base64 โดยตรงลงในพารามิเตอร์การสืบค้น URL โดยไม่มีการเข้ารหัสเปอร์เซ็นต์ + และตัวถอดรหัส /, อาจตีความผิด
เหตุใด + และ / จึงเป็นปัญหาใน URL และชื่อไฟล์ - ความหมายที่สงวนไว้ของ / ในเส้นทางและของ + เป็นช่องว่างในข้อมูลแบบฟอร์ม
A + สามารถอ่านเป็นช่องว่างก่อนถึงตัวถอดรหัส A / สามารถแยกค่าพารามิเตอร์ผิดตำแหน่งได้ RFC 4648 ส่วน 5 กำหนดตัวอักษร base64url เพื่อขจัดความคลุมเครือ: ใช้ - แทน + และ _ แทน /, ดังนั้นเอาต์พุตจึงปลอดภัยใน URL และชื่อไฟล์ ตัวอักษรสองตัวเหมือนกันยกเว้นอักขระสองตัว
Standard Base64 ใช้อักขระที่ตำแหน่ง 62 และ 63: A–Z (0–25), a–z (26–51), 0–9 (52–61), + (62), / (63) base64url ใช้ A–Z (0–25), a–z (26–51), 0–9 (52–61), - (62), _ (63) อย่างอื่นทั้งหมด เช่น การจัดกลุ่มบิตใหม่ กฎการเติม การแมปบิตกับดัชนี จะเหมือนกัน สตริงดัชนีสำหรับ Base64 มาตรฐานจะสร้างสตริงดัชนีสำหรับ base64url เฉพาะอักขระที่ตำแหน่ง 62 และ 63 เท่านั้นที่จะแตกต่างกัน
ตัวอักษร base64url จาก RFC 4648 ส่วน 5 — อักขระสองตัวที่ถูกแทนที่และเหตุใดจึงไม่มีอะไรเปลี่ยนแปลง
หากอินพุตไม่มีดัชนี 62 หรือ 63 (ไม่มี + หรือ / ในรูปแบบมาตรฐาน ไม่ใช่ - หรือ _ ใน base64url) ตัวอักษรทั้งสองจะสร้างเอาต์พุตที่เหมือนกัน การแปลง Base64 มาตรฐานเป็น base64url นั้นทำได้ง่ายในการค้นหาและแทนที่: swap + for - และ / for _ การถอดรหัสสตริง base64url ใน Base64 มาตรฐานต้องย้อนกลับ: swap - สำหรับ + และ _ สำหรับ /.
การแปลงมีความสมมาตรและมีผลเสมอ หากคุณพบโทเค็นที่ไม่สามารถถอดรหัสด้วยการตั้งชื่อข้อผิดพลาดอักขระที่ไม่ถูกต้อง - หรือ _ ให้ตรวจสอบว่าตัวถอดรหัสยอมรับ base64url หรือไม่ ถ้าไม่เช่นนั้น ให้ใช้การทดแทนอักขระ และหากอินพุตมีรูปแบบที่ดี การถอดรหัสก็ควรจะสำเร็จ พิจารณา JWT ส่วนหัว {"alg///"HS256"typ"JWT"} เข้ารหัสเป็น base64url ไบต์มาตรฐาน UTF-8 ผ่านการจัดกลุ่มบิตใหม่: สามไบต์กลายเป็นสี่ดัชนี ค้นหาด้วยตัวอักษร base64url ToolAcre แสดงช่องว่างภายในเป็นตัวเลือกตัวเข้ารหัส แทนที่จะผูกไว้กับการสลับตัวอักษร การแยกดังกล่าวเป็นหลักฐานที่มีประโยชน์: URL-เอาต์พุตที่ปลอดภัยอาจมีการเสริมหรือไม่มีการเสริม ในขณะที่ตัวถอดรหัสจะทำให้รูปแบบใดรูปแบบหนึ่งเป็นมาตรฐานก่อนที่จะเรียกเบราว์เซอร์ดั้งเดิม ตัวอักษรและช่องว่างภายในเป็นแบบแผนที่เกี่ยวข้องกัน ไม่ใช่สวิตช์ตัวเดียว
การเติมใน base64url เป็นทางเลือกตามแบบแผน - เหตุใด JWT จึงละเว้น = และวิธีที่ตัวถอดรหัสสามารถกู้คืนจากความยาวได้
เมื่อดัชนีเป็น 62 อักขระเอาท์พุตคือ -; เมื่อ 63 เอาต์พุตคือ _ ไบต์ที่เหมือนกันผ่านตัวอักษรมาตรฐานจะสร้าง + ที่ดัชนี 62 และ / ที่ดัชนี 63 การแปลงผลลัพธ์ base64url ให้เป็นมาตรฐานคือการดำเนินการทีละอักขระ: สแกนหา - และแทนที่ด้วย + สแกนหา _ และแทนที่ด้วย /, จากนั้นถอดรหัสตามปกติ
ไบต์ที่คุณกู้คืนจะเหมือนกันเนื่องจากดัชนีเหมือนกัน มีเพียงสัญลักษณ์เท่านั้นที่แตกต่างกัน การเสริมใน base64url เป็นทางเลือกตามแบบแผน แม้ว่ามาตรฐานจะอนุญาตก็ตาม JWT มีโครงสร้างเป็นสามส่วน base64url ที่เชื่อมต่อกันด้วยจุด แต่ละเซ็กเมนต์ใช้ช่องว่างภายในหากจำเป็น แต่การใช้งานจำนวนมากละเว้นและอาศัยข้อเท็จจริงที่ว่าแอปพลิเคชันที่ใช้งานรู้ความยาวไบต์ที่คาดหวัง
ตัวอย่างการทำงาน: การแปลงส่วนหัว JWT เป็น Base64 มาตรฐาน — การแทนที่อักขระ, เพิ่มช่องว่างภายใน, ถอดรหัสเป็น JSON
ตัวถอดรหัสสามารถคืนค่าช่องว่างภายในที่หายไปได้โดยการแบ่งความยาวของสตริงด้วยสี่ คำนวณส่วนที่เหลือ ต่อท้าย 0, 1 หรือ 2 เท่ากับเครื่องหมาย หากความยาวของสายอักขระไม่คูณด้วยสี่ แสดงว่าขาดช่องว่างภายใน หากความยาวเป็นทวีคูณในสี่ แสดงว่าสตริงถูกเสริมแล้วจึงถอดช่องว่างออก หรือป้อนข้อมูลหลายไบต์จากสี่ไบต์แล้ว (ลงท้ายด้วยสามไบต์ในบล็อกสุดท้าย โดยไม่จำเป็นต้องเติมช่องว่าง)
การต่อส่วน base64url เข้าด้วยกันต้องอาศัยการเอาใจใส่ในการเติม หากสามส่วนแต่ละส่วนลงท้ายด้วย = การต่อกันจะสร้างสตริงโดยตรง เช่น AAAA=BBBB=CCCC= โดยที่ช่องว่างตรงกลางกลายเป็นอักขระที่หลงทาง โดยไม่ปิดเครื่องหมาย นี่คือสาเหตุที่ JWT ละเว้นช่องว่างภายในในแต่ละส่วน: โครงสร้างสามส่วนมีความชัดเจน ดังนั้นการถอดรหัสจะดำเนินการอย่างอิสระในแต่ละส่วน และการเติมภายในตรงกลางของสตริงที่ต่อกันนั้นไม่จำเป็น และอาจทำให้การแยกวิเคราะห์เสียหาย
ข้อผิดพลาดทั่วไป — การผสมตัวอักษรในสตริงเดียว หรือการเข้ารหัสเปอร์เซ็นต์มาตรฐาน Base64 แทนที่จะใช้ base64url
หากสร้างเพย์โหลดแบบหลายส่วน ให้ตัดสินใจเลือกรูปแบบการเติมตั้งแต่เริ่มต้น: รวมไว้ในแต่ละส่วนและไม่ต้องต่อกันโดยตรง หรือละเว้นและกู้คืนจากความยาวเฉพาะเมื่อถอดรหัสเท่านั้น RFC 4648 มาตรฐานคือสิทธิของทั้งสองตัวอักษร ส่วน 4 ระบุ Base64 มาตรฐาน; ส่วน 5 ระบุ base64url ตัวถอดรหัสทุกตัวที่สอดคล้องควรระบุอย่างชัดเจนว่าตัวถอดรหัสตัวใดที่ยอมรับ
รหัสที่ยอมรับ base64url แต่ไม่ใช่ Base64 มาตรฐาน (หรือกลับกัน) กำลังใช้งานเฉพาะชุดย่อยเท่านั้น มีตัวอักษร base64url เพื่อความเข้ากันได้กับ URL และข้อจำกัดของชื่อไฟล์ ไม่ใช่การปรับปรุงหรือทดแทน แต่เป็นเพียงตัวแปรสำหรับบริบทเฉพาะ เมื่อคุณเขียน API หรือรูปแบบโทเค็น ให้เลือกตัวอักษรหนึ่งตัวและเอกสารที่ต้องการ ข้อผิดพลาดทั่วไปคือการเข้ารหัสเปอร์เซ็นต์ Base64 มาตรฐานแทนที่จะใช้ base64url การใช้งานยังอธิบายขอบเขตของบทความด้วย โดยจะทำให้ยัติภังค์และขีดเส้นใต้เป็นปกติก่อนที่จะถอดรหัส แต่จะไม่ตรวจสอบลายเซ็นโทเค็นหรือตีความการอ้างสิทธิ์ การแปลงเซ็กเมนต์ JWT เป็นไบต์สามารถเปิดเผย JSON; ไม่สามารถระบุได้ว่าใครเป็นผู้ออก JSON หรือไม่ว่าจะมีใครเปลี่ยนแปลงหรือไม่
สิ่งนี้ไม่ครอบคลุมถึง — การตรวจสอบลายเซ็น JWT, base32 และการเข้ารหัส RFC 4648 อื่นๆ
%2B คือรหัสเปอร์เซ็นต์สำหรับ +; %2F คือรหัสเปอร์เซ็นต์สำหรับ /. การเข้ารหัสเปอร์เซ็นต์เปลี่ยน TWFu เป็น TWFu ไม่เปลี่ยนแปลง (ไม่มีอักขระพิเศษ) แต่ TE9S+g== เป็น TE9S%2Bg%3D%3D (มีอักขระมากเกินไปที่จะจัดการ) วิธีแก้ไขที่ถูกต้องคือใช้ base64url ซึ่งสร้างเอาต์พุต URL-safe ไว้แล้ว การเข้ารหัสเปอร์เซ็นต์ Base64 นั้นไม่จำเป็นและสิ้นเปลือง ใช้ตัวอักษรที่ถูกต้องสำหรับบริบท ตัวเข้ารหัสและตัวถอดรหัส Base64 ยอมรับทั้งสองตัวอักษรโดยอัตโนมัติ
หากคุณวางสตริงที่มี - จะถือว่าเป็น base64url หากวางสตริงที่มี + จะถือว่าเป็น Base64 มาตรฐาน เครื่องมือยังยอมรับ URL และถือว่า URL เป็นอินพุต URL-safe การตรวจสอบเชิงปฏิบัติจึงมีผลลัพธ์สองแบบแยกกัน: ไบต์ไปกลับ และการแสดงที่เลือกเหมาะสมกับช่องสัญญาณ การผ่านข้อแรกบอกว่าการเปลี่ยนแปลงสามารถย้อนกลับได้ การส่งผ่านวินาทีจะบอกว่าเครื่องหมายวรรคตอนและช่องว่างภายในจะไม่ถูกเขียนใหม่โดย URL ชื่อไฟล์ คุกกี้ หรือโปรโตคอลที่ถือมัน
ประเด็นสำคัญ: ตัวอักษรสองตัว รูปแบบหนึ่งบิต — ตัวเข้ารหัสและตัวถอดรหัส Base64 จัดการกับตัวอักษรมาตรฐานในเบราว์เซอร์อย่างไร และหน้าเครื่องมือระบุสิ่งที่ยอมรับ
เมื่อถอดรหัสเซ็กเมนต์ JWT หรือ URL-โทเค็นปลอดภัย คุณสามารถวางได้โดยตรงโดยไม่ต้องแปลง และเครื่องมือจะระบุตัวอักษรจากบริบท การดีบักการถอดรหัสที่ล้มเหลวกลายเป็นเรื่องง่าย: วางโทเค็น ดูว่าเครื่องมือยอมรับหรือไม่ และหากไม่ยอมรับ ให้สลับอักขระด้วยตนเองแล้วลองอีกครั้ง
การแทนที่นั้นเป็นโค้ดบรรทัดเดียว แต่การถอดรหัสที่ล้มเหลวอาจมาจากความยาวที่เป็นไปไม่ได้ การแพดดิ้งที่วางผิดที่ การเสียหาย หรืออินพุตที่ไม่ใช่ Base64 เครื่องมือทำให้ตัวอักษรทั้งสองเป็นมาตรฐานโดยอัตโนมัติ ดังนั้นการยอมรับจะยืนยันว่าสามารถกู้คืนไบต์ได้เท่านั้น เพย์โหลด JWT ที่ถอดรหัสแล้วยังคงเป็นการอ้างสิทธิ์ที่ไม่ได้ลงนามจนกว่าผู้ตรวจสอบที่แยกต่างหากจะตรวจสอบลายเซ็นและอัลกอริทึมที่คาดไว้