เครื่องมือสำหรับนักพัฒนา · ตัวเข้ารหัสและตัวถอดรหัส Base64
Base64 เปลี่ยนสามไบต์เป็นอักขระสี่ตัวทีละขั้นตอนได้อย่างไร
· มันทำงานอย่างไร
base64 การเข้ารหัส ยูนิโค้ด
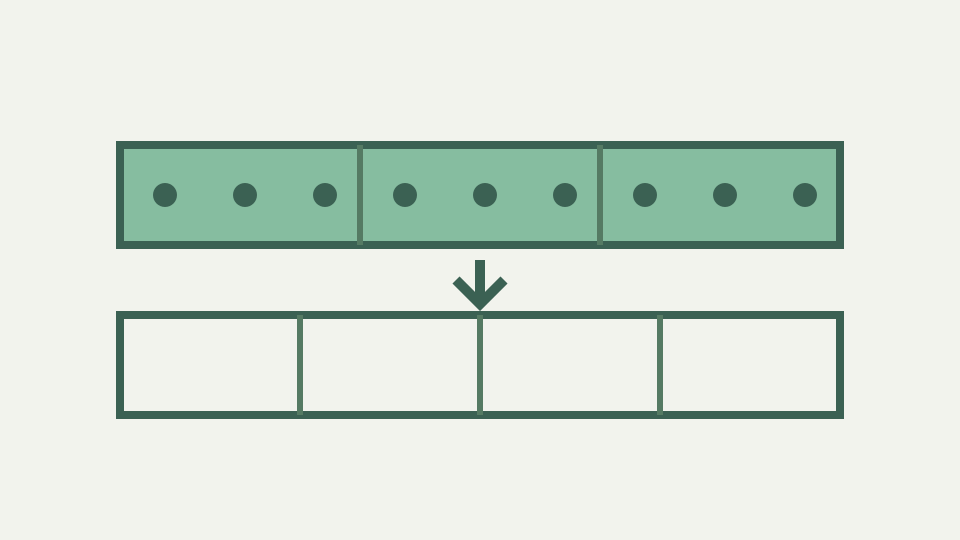
Base64 ไม่มีอะไรมากไปกว่าการจัดกลุ่มบิตใหม่: 24 bits ใน, สี่ 6-บิตดัชนีออก โพสต์นี้จะอธิบายเกี่ยวกับการค้นหาตาราง การเลื่อนบิต และการย้อนกลับ เพื่อให้รูปแบบหยุดเป็นกล่องดำ
สตริง 'TWFu' และคำที่ซ่อน — เริ่มต้นจากบล็อกสี่ตัวอักษรจริงและถามว่าแต่ละตัวอักษรมาจากไหน
สตริง Base64 สี่อักขระ TWFu ถอดรหัสเป็นลำดับสามไบต์ Man การที่ไบต์สามกลายเป็นอักขระสี่ตัวเผยให้เห็นว่า Base64 ไม่ใช่การเข้ารหัสหรือการบีบอัด แต่เป็นการจัดกลุ่มบิตใหม่อย่างแท้จริง เมื่อคุณเห็นเค้าโครงบิตแล้ว เอาต์พุต Base64 จะหยุดทึบและสามารถคาดเดาได้ คุณสามารถเข้ารหัส Man ด้วยมือ ตรวจสอบกับ TWFu และทำความเข้าใจว่าทำไม Base64 จึงส่งออกอักขระสี่ตัวต่ออินพุตสามไบต์เสมอ
ความมหัศจรรย์ของ Base64 คือสามไบต์ (24 bits) จัดกลุ่มใหม่อย่างสมบูรณ์เป็นสี่ชิ้นหกบิต หกบิตแทน 0 ถึง 63 ซึ่งเป็นเหตุผลว่าทำไมตัวอักษรจึงมีสัญลักษณ์ 64 ทุกประการ: A–Z (26), a–z (26), 0–9 (10) และ + และ / (2) แต่ละอันหกบิตจัดทำดัชนีเป็นตัวอักษรเพื่อสร้างอักขระเอาต์พุตหนึ่งตัว การย้อนกลับมีความสะอาดเท่าเทียมกัน: ดัชนีอักขระสี่ตัวเป็นตัวอักษรเพื่อกู้คืนส่วนหกบิตสี่ชิ้นซึ่งจัดกลุ่มใหม่เป็นสามไบต์
จากไบต์ไปจนถึงดัชนี 6 บิต — 24 bits ถูกแบ่งออกเป็นสี่กลุ่มอย่างไร และเหตุใดสัญลักษณ์ 64 จึงเพียงพอแล้ว
นี่คือเหตุผลที่ Base64 รู้สึกเป็นธรรมชาติทุกที่ รับสามไบต์ M, a, n ใน ASCII: 0x4D, 0x61, 0x6E เขียนในรูปแบบไบนารี่: 01001101, 01100001, 01101110 เชื่อมต่อ 24 bits ทั้งหมด: 010011010110000101101110 จัดกลุ่มใหม่เป็นสี่ชิ้นหกบิต: 010011 010110 000101 101110 ตีความว่าเป็นเลขฐานสอง: 19, 22, 5, 46 จัดทำดัชนีเป็นตัวอักษร Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). ดัชนี 19 คือ T, ดัชนี 22 คือ W, ดัชนี 5 คือ F, ดัชนี 46 คือ u
เอาท์พุต: TWFu การค้นหาดัชนีเป็นแบบกลไก ตัวอักษร Base64 เป็นลำดับโดยที่ตำแหน่งมีความสำคัญ: การใช้งานทุกครั้งใช้ลำดับ A–Z, a–z, 0–9, +, /. ลำดับที่ต่างกันจะให้ผลลัพธ์ที่แตกต่างกัน การเปลี่ยนลำดับเป็นวิธีการทำงานของ base64url อย่างแน่นอน ในตัวอักษรมาตรฐาน ตัวอักษรตัวพิมพ์ใหญ่จะใช้ดัชนี 0–25 ตัวพิมพ์เล็ก 26–51 ตัวเลข 52–61 อักขระพิเศษ 62–63 การสั่งซื้อนี้เป็นไปตามอำเภอใจ แต่แก้ไขโดย RFC; ตัวถอดรหัสทุกตัวคาดหวังการแมปที่เหมือนกัน
ตารางตัวอักษรและการค้นหาดัชนี — A–Z, a–z, 0–9, + และ / ตามลำดับ และเหตุใดลำดับจึงมีความสำคัญสำหรับการเปรียบเทียบ
หากคุณเขียนตัวอักษรบนกระดาษและนับอย่างระมัดระวัง คุณสามารถเข้ารหัสด้วยตนเองโดยไม่ต้องใช้คอมพิวเตอร์: ค้นหา 19 นับ A B C...T เขียน T ทำซ้ำ การถอยหลังก็ตรงไปตรงมาไม่แพ้กัน เมื่อระบุ TWFu ให้ค้นหาอักขระแต่ละตัวเป็นตัวอักษร: T คือ 19, W คือ 22, F คือ 5, u คือ 46 แปลงเป็นไบนารี (ศูนย์นำหน้าสำหรับหกบิต): 010011, 010110, 000101, 101110 เชื่อมต่อ: 010011010110000101101110
จัดกลุ่มออกเป็นสามไบต์แปดบิต: 01001101, 01100001, 01101110 ตีความว่าเป็นทศนิยมหรือฐานสิบหก: 77, 97, 110 หรือ 0x4D, 0x61, 0x6E แปลงเป็น ASCII: M, a, n คุณกู้คืนสามไบต์ดั้งเดิมแล้ว นี่คือสาเหตุที่ Base64 สามารถย้อนกลับได้ และเหตุใดการเสริมจึงจำเป็นสำหรับอินพุตที่ไม่หารด้วยสามเท่านั้น Base64 เข้ารหัสไบต์ที่แน่นอนและไม่มีอะไรเพิ่มเติม การเข้ารหัส Man และการเข้ารหัสไบต์ (77, 97, 110) เป็นการดำเนินการที่เหมือนกัน Base64 ไม่ทราบหรือสนใจเกี่ยวกับอักขระ ภาษา หรือการเข้ารหัส
ตัวอย่างการทำงาน: การเข้ารหัส 'Man' ด้วยมือ - ไบนารี่ของ M, a และ n, ดัชนีสี่ตัวและอักขระเอาท์พุตสี่ตัว
มันเห็นไบต์ ตัวเข้ารหัสและตัวถอดรหัสของเครื่องมือแยกข้อกังวล: การป้อนข้อความเช่น Man จะต้องผ่าน TextEncoder ก่อน กลายเป็น UTF-8 ไบต์ ไบต์เหล่านั้นเป็นอินพุต Base64 เอาต์พุต TWFu คือข้อความ (อักขระ ASCII) แต่ย่อมาจากไบต์ ไม่ใช่คำ เครื่องมือต่างๆ ที่อ่าน TWFu จะกู้คืนไบต์ (77, 97, 110) และต้องตัดสินใจอย่างอิสระว่าเครื่องมือเหล่านั้นแทนคำ รูปภาพ ข้อความในการเข้ารหัสอื่นหรืออย่างอื่น
อินพุตขนาดใหญ่เป็นรูปแบบนี้ซ้ำหลายครั้ง ไฟล์ 300 ไบต์ใช้ 300/3 = 100 บล็อกขนาด 3 ไบต์ แต่ละบล็อกกลายเป็นอักขระ 4 ตัว ซึ่งสร้างอักขระเอาท์พุต 400 เมื่อบล็อกสุดท้ายถูกบุไว้ ตัวถอดรหัสจะละทิ้งการเติมศูนย์แทนที่จะสร้างไบต์อื่น ขอบเขตนั้นสามารถมองเห็นได้ด้วยการป้อนข้อมูลแบบสองไบต์: ดัชนีที่มีประโยชน์สามรายการยังคงอยู่ ตำแหน่งที่สี่เป็นเครื่องหมายเท่ากับ และมีบิตที่สร้างขึ้นใหม่เพียงสิบหกบิตเท่านั้นที่เป็นของผลลัพธ์
การย้อนกลับกระบวนการ — การค้นหาดัชนี การบรรจุบิต และตำแหน่งที่บิตการเติมไปเมื่อถอดรหัสอักขระสี่ตัวเป็นสามไบต์
เนื่องจากรูปแบบเป็นแบบปกติ การทำงานจึงรวดเร็ว: การเลื่อนบิต ค้นหา และเขียน ความผิดปกติเพียงอย่างเดียวคือบล็อกสุดท้าย เมื่อความยาวอินพุตไม่เป็นจำนวนเท่าของสาม ซึ่งจัดการโดยการเติม เนื่องจากทุกบล็อกมีความเป็นอิสระ บิตของหนึ่งบล็อกจะไม่ส่งผลกระทบต่อบล็อกถัดไป Base64 จึงสามารถเข้ารหัสแบบเพิ่มหน่วยได้: ป้อนไบต์เข้า นำอักขระออก โดยไม่ต้องรออินพุตทั้งหมด
Base64url แตกต่างเฉพาะในการทดแทนตัวอักษรเท่านั้น ดัชนี 62 และ 63 กลายเป็น - และ _ แทนที่จะเป็น + และ /. การจัดกลุ่มบิตใหม่เหมือนกัน การแมปแบบไบต์ต่ออักขระจะเหมือนกัน เฉพาะตารางการค้นหาเท่านั้นที่เปลี่ยนแปลง เครื่องถอดรหัสด้วยมือจึงสามารถนำทุกกะและมาสก์จาก Base64 มาตรฐานมาใช้ซ้ำได้ โดยแทนที่เฉพาะสัญลักษณ์เทอร์มินัลทั้งสองเท่านั้น
เหตุใดผลลัพธ์จึงเป็นลำดับของไบต์ ไม่ใช่ข้อความ — ขั้นตอนแยกที่เปลี่ยนไบต์เป็นอักขระ UTF-8
นี่คือสาเหตุที่ RFC 4648 ส่วน 5 อธิบายว่าเป็นตัวอักษรที่แตกต่างกัน ไม่ใช่การเข้ารหัสที่แตกต่างกัน สตริง TWFu ใน Base64 มาตรฐานไม่คลุมเครือ: สามารถหมายถึงดัชนีเท่านั้น (19, 22, 5, 46) ใน base64url สตริงจะต้องมี - หรือ _ จึงจะแตกต่าง หากไม่มีสตริงเหล่านั้น จะใช้ดัชนีเดียวกัน
ข้อผิดพลาดในการใช้งานมักเกี่ยวข้องกับข้อผิดพลาดแบบทีละรายการในการเปลี่ยนบิตหรือการแมปตัวอักษรที่ไม่ถูกต้อง ตัวเข้ารหัสที่ใช้ลำดับตัวอักษรไม่ถูกต้องจะสร้างเอาต์พุตที่แตกต่างกันหากสลับ a และ A ตัวถอดรหัสจัดการบล็อกบางส่วนสุดท้ายไม่ถูกต้อง (เมื่อมีช่องว่างภายใน) อาจกู้คืนจำนวนไบต์ที่ไม่ถูกต้อง ตัวเข้ารหัสและตัวถอดรหัส Base64 ใช้ตัวอักษรมาตรฐานและจัดการการเสริมด้วย RFC 4648 ดังนั้นคุณจึงสามารถวางตัวอย่างที่คำนวณด้วยมือและตรวจสอบงานได้
สิ่งนี้ไม่ครอบคลุม — base64url, MIME การตัดบรรทัด และประสิทธิภาพของบัฟเฟอร์ขนาดใหญ่
เนื่องจากคณิตศาสตร์บิตเป็นสิ่งที่กำหนดได้ ข้อผิดพลาดใดๆ ในการเข้ารหัสด้วยตนเองจะทำให้เกิดผลลัพธ์ที่แตกต่างกันเมื่อถอดรหัส ทำให้เกิดข้อผิดพลาดได้ทันที Base32 (RFC 4648 ส่วน 6) ขยายหลักการไปยังชิ้นส่วนห้าบิต: สัญลักษณ์ 32 (A–Z และ 2–7) ดังนั้นห้าบิตจึงพอดีกับอักขระตัวเดียว และ 40 bits (ห้าไบต์) จัดกลุ่มใหม่เป็นอักขระแปดตัว ใช้ตรรกะการจัดกลุ่มใหม่เดียวกัน ความแตกต่างคือขนาดตัวอักษรและอัตราส่วนของไบต์อินพุตต่ออักขระเอาต์พุต
เลขฐานสิบหก (ฐาน 16) ใช้การผสมสัญลักษณ์ที่เป็นไปได้ 8 รายการจาก 256 และแมปหนึ่งไบต์กับอักขระสองตัวโดยไม่มีการจัดกลุ่มใหม่ การทำความเข้าใจ Base64 ในการจัดกลุ่มบิตใหม่ทำให้ตัวแปรต่างๆ เป็นเรื่องง่ายในแนวคิด: เลือกบิตต่ออักขระ จัดกลุ่มอินพุตตามนั้น ค้นหาแต่ละกลุ่มด้วยตัวอักษร เมื่อทำการดีบัก Base64 รูปภาพบิตคือเครื่องมือของคุณ หากไบต์เสียหาย ให้เข้ารหัสอีกครั้งและเปรียบเทียบอักขระเอาต์พุตทีละอักขระ หากไม่แน่ใจว่า TWFu มีไบต์ใด ให้ถอดรหัสและตรวจสอบเอาต์พุตเป็นเลขฐานสิบหก
ประเด็นสำคัญ: Base64 คือการจัดกลุ่มบิตแบบย้อนกลับได้ — ตัวเข้ารหัสและตัวถอดรหัส Base64 ช่วยให้คุณตรวจสอบบล็อกที่คำนวณด้วยมือได้ทันทีในเบราว์เซอร์ได้อย่างไร
ตัวเข้ารหัสและตัวถอดรหัส Base64 แสดงทั้งอักขระและมุมมองฐานสิบหก ทำให้ง่ายต่อการตรวจสอบว่าดูไบต์ของข้อความ (จะถอดรหัสเป็นข้อความที่อ่านง่าย) หรือข้อมูลไบนารี (แสดงเป็นฐานสิบหกและเก็บไว้ดีที่สุดเป็นไบต์ ไม่ใช่ข้อความ) กระบวนการทีละขั้นตอน—ไบต์เป็นบิต, บิตเป็นดัชนี, ดัชนีเป็นอักขระ—ถูกกำหนดไว้ รวดเร็ว และเหมือนกันในทุกการใช้งานที่เป็นไปตามข้อกำหนด RFC 4648 กำหนด Base64 อย่างเป็นทางการเพื่อให้สามารถเปรียบเทียบการใช้งานได้
มาตรฐานระบุตัวอักษร รูปแบบบิต กฎการเติม และวิธีจัดการการตัดบรรทัดใน MIME การรู้มาตรฐานช่วยให้ตรวจสอบได้ง่ายว่าตัวถอดรหัสปฏิบัติตามอย่างเคร่งครัด (Canonical Base64) หรือยอมรับรูปแบบต่างๆ (ไม่มีช่องว่างภายในหรืออักขระ URL-safe) แอปพลิเคชันในโลกแห่งความเป็นจริงจำนวนมากใช้ Base64 แตกต่างกันเล็กน้อย: บางตัวละเว้นช่องว่างภายใน, บางตัวใช้อักขระ URL-safe, บางตัวล้อมด้วยความยาวบรรทัดที่แตกต่างกัน ตัวเข้ารหัสและตัวถอดรหัส Base64 จัดการรูปแบบต่างๆ โดยอัตโนมัติ แต่การทำความเข้าใจมาตรฐานจะทำให้ปัญหาการรวมการแก้ไขข้อบกพร่องง่ายขึ้นมาก