开发者工具 · Base64 编码器和解码器
Base64 如何逐步将三个字节转换为四个字符
· 工作原理
base64 编码 统一码
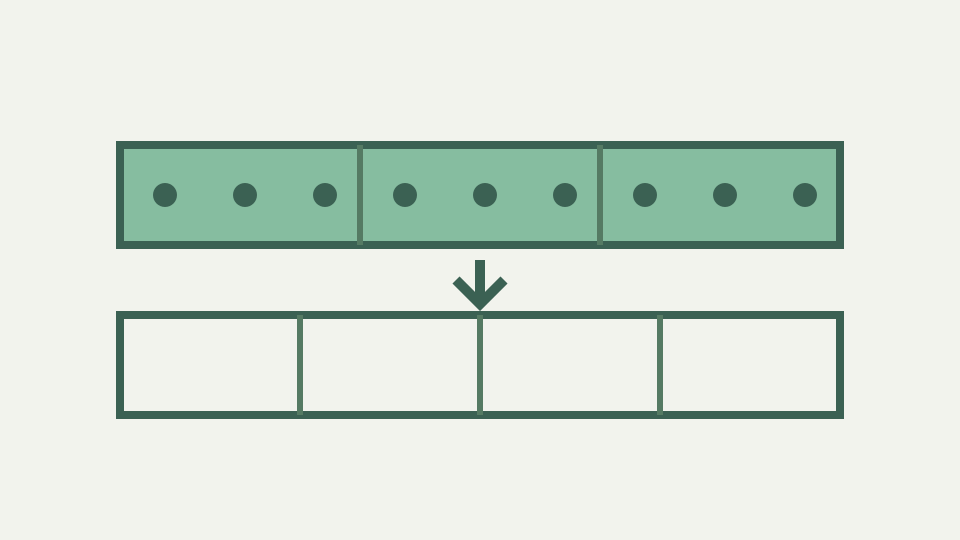
Base64 只不过是重新组合位:24 位输入,四个 6 位索引输出。这篇文章介绍了表查找、位移位和反向行程,因此格式不再是黑匣子。
字符串“TWFu”及其隐藏的单词 - 从真正的四字符块开始并询问每个字母来自哪里
四字符 Base64 字符串 TWFu 解码为三字节序列 Man。三个字节变成四个字符的过程揭示了 Base64 不是加密或压缩,而是纯粹的位重组。一旦您看到位布局,Base64 输出就不再是不透明的,而是变得可预测。您可以手动对 Man 进行编码,根据 TWFu 进行验证,并理解为什么 Base64 总是每三个输入字节输出四个字符。
Base64 的魔力在于三个字节(24 位)完美地重新组合成四个六位块。六位代表 0 到 63,这就是为什么字母表恰好包含 64 符号:A–Z (26)、a–z (26)、0–9 (10) 以及 + 和 / (2)。每个六位块索引到字母表中以产生一个输出字符。反之亦然:四个字符索引到字母表中以恢复四个六位块,这些块重新组合成三个字节。
从字节到 6 位索引 — 24 位如何分为四组以及为什么 64 符号就足够了
这就是为什么 Base64 在任何地方都感觉很自然。取ASCII中的三个字节M、a、n:0x4D、0x61、0x6E。以二进制形式写入:01001101、01100001、01101110。连接所有 24 位:010011010110000101101110。重新组合成四个六位块:010011 010110 000101 101110。解释为二进制数:19、22、5、46。 Base64 字母表索引(A=0、B=1、...Z=25、a=26、...z=51、0=52、 ...9=61, +=62, /=63). 索引 19 为 T,索引 22 为 W,索引 5 为 F,索引 46 为 u。
输出:TWFu。索引查找是机械的。 Base64 字母表是位置重要的序列:每个实现都使用相同的顺序 A–Z、a–z、0–9、+、/. 不同的顺序产生不同的输出;更改顺序正是 base64url 的工作原理。在标准字母表中,大写字母占据索引 0–25,小写字母占据 26–51,数字 52–61,特殊字符 62–63。此顺序是任意的,但由 RFC 固定;每个解码器都期望相同的映射。
字母表和索引查找 — A–Z、a–z、0–9、+ 和 / 按顺序排列,以及为什么顺序对于比较很重要
如果您在纸上写下字母并仔细数数,则无需计算机即可手动编码:查找 19,数 A B C...T,写 T,重复。倒车同样简单。给定 TWFu,查找字母表中的每个字符:T 是 19,W 是 22,F 是 5,u 是 46。转换为二进制(六位前导零):010011、010110、000101、101110。连接:010011010110000101101110。
分为三个字节,每组八位:01001101、01100001、01101110。解释为十进制或十六进制:77、97、110 或 0x4D、0x61、0x6E。转换为 ASCII:M、a、n。您恢复了原始的三个字节。这就是为什么 Base64 是可逆的,以及为什么只有对于不能被三整除的输入才需要填充。 Base64 编码精确的字节,仅此而已。编码 Man 和编码字节 (77, 97, 110) 是相同的操作; Base64 不知道也不关心字符、语言或编码。
工作示例:手动编码“Man”——M、a 和 n 的二进制、四个索引和四个输出字符
它看到字节。该工具的编码器和解码器分别关注:像 Man 这样的文本输入首先经过 TextEncoder,变成 UTF-8 字节。这些字节是 Base64 输入。输出 TWFu 是文本(ASCII 字符),但代表字节,而不代表字。读取 TWFu 的不同工具会恢复字节(77、97、110),并且必须独立决定它们是否表示另一种编码中的单词、图像、消息或其他内容。
大输入是此模式的多次重复。 300 字节文件使用 300/3 = 100 三个字节块,每个块变成四个字符,产生 400 输出字符。当最后一个块被填充时,解码器丢弃零填充而不是制造另一个字节。该边界对于两字节输入是可见的:三个有用的索引保留下来,第四个位置是等号,并且只有十六个重构位属于结果。
反转过程 — 索引查找、位打包以及将四个字符解码为三个字节时填充位的位置
因为模式是规则的,所以操作速度很快:移位、查找、写入。唯一的不规则之处是当输入长度不是三的倍数时的最终块,通过填充处理。因为每个块都是独立的(一个块的位不会影响下一个块),所以 Base64 可以增量编码:输入字节,取出字符,无需等待整个输入。
Base64url 仅在字母替换方面有所不同。索引 62 和 63 变为 - 和 _ 而不是 + 和 /. 位重组相同;字节到字符的映射是相同的;仅查找表发生变化。因此,手动解码器可以重用标准 Base64 中的每个移位和掩码,仅替换这两个终端符号。
为什么结果是字节序列,而不是文本 - 将字节转换为 UTF-8 字符的单独步骤
这就是为什么 RFC 4648 部分 5 将其描述为不同的字母表,而不是不同的编码。标准 Base64 中的字符串 TWFu 是明确的:它只能表示索引 (19、22、5、46)。在 base64url 中,字符串需要包含 - 或 _ 来区分,如果没有这些,则应用相同的索引。
实现中的错误通常涉及位移位中的差一错误或不正确的字母表映射。如果交换 a 和 A,使用错误字母顺序的编码器会产生不同的输出。解码器错误处理最后一个部分块(当存在填充时)可能会恢复错误的字节数。 Base64 编码器和解码器使用标准字母表并通过 RFC 4648 处理填充,因此您可以粘贴任何手工计算的示例并检查工作。
这不包括什么——base64url、MIME 换行和大缓冲区的性能
由于位数学是确定性的,因此手动编码中的任何错误都会在解码时产生不同的输出,从而立即出错。 Base32(RFC 4648 部分 6)将原理扩展到五位块:32 符号(A–Z 和 2–7),因此五个位正好适合一个字符,而 40 位(五个字节)重新组合成八个字符。适用相同的重组逻辑;区别在于字母大小以及输入字节与输出字符的比率。
十六进制 (base16) 使用八种 256 可能的符号组合,并将一个字节映射到两个字符,无需重新分组。将 Base64 理解为位重组使得变体在概念上变得简单:为每个字符选择位,相应地对输入进行分组,在字母表中查找每个组。调试 Base64 时,位图是您的工具。如果字节已损坏,请再次对其进行编码并逐个字符地比较输出。如果不确定 TWFu 包含哪些字节,请将其解码并检查十六进制输出。
要点:Base64 是可逆的位重组 — Base64 编码器和解码器如何让您在浏览器中立即检查任何手工计算的块
Base64 编码器和解码器显示字符和十六进制视图,可以轻松验证是否查看文本字节(将解码为清晰的文本)或二进制数据(显示为十六进制,最好保留为字节,而不是文本)。分步过程(字节到位、位到索引、索引到字符)是确定性的、快速的,并且在每个合规实施中都是相同的。 RFC 4648 正式定义了 Base64,以便可以比较实现。
标准指定字母表、位布局、填充规则以及 MIME 中如何处理换行。了解标准可以轻松验证解码器是否严格遵循它(规范的 Base64)或接受变体(缺少填充或 URL 安全字符)。许多实际应用程序使用 Base64 略有不同:有些省略填充,有些使用 URL 安全字符,有些以不同的行长度换行。 Base64 编码器和解码器会自动处理变化,但了解标准可以使调试集成问题变得更加简单。