Công cụ dành cho nhà phát triển · Bộ mã hóa và giải mã Base64
Cách Base64 biến ba byte thành bốn ký tự, từng bước một
· Cách thức hoạt động
base64 mã hóa unicode
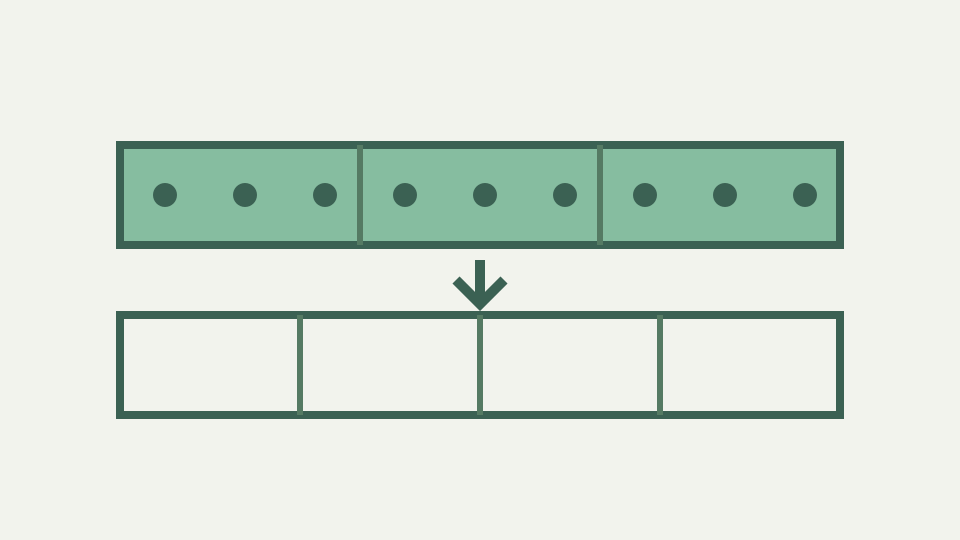
Base64 không gì khác hơn là tập hợp lại các bit: 24 bits vào, bốn chỉ số 6-bit ra. Bài đăng này hướng dẫn cách tra cứu bảng, dịch chuyển bit và hành trình ngược lại để định dạng không còn là hộp đen.
Chuỗi 'TWFU' và từ nó ẩn — bắt đầu từ một khối bốn ký tự thực và hỏi từng chữ cái đến từ đâu
Chuỗi Base64 gồm bốn ký tự TWFu giải mã thành chuỗi ba byte Man. Cách ba byte trở thành bốn ký tự cho thấy Base64 không phải là mã hóa hoặc nén mà là tập hợp lại bit thuần túy. Khi bạn thấy bố cục bit, đầu ra Base64 sẽ không còn mờ đục và có thể dự đoán được. Bạn có thể mã hóa Man bằng tay, xác minh nó dựa trên TWFu và hiểu lý do tại sao Base64 luôn xuất ra bốn ký tự trên ba byte đầu vào.
Điều kỳ diệu của Base64 là ba byte (24 bits) tập hợp lại một cách hoàn hảo thành bốn khối sáu bit. Sáu bit biểu thị 0 đến 63, đó là lý do tại sao bảng chữ cái chứa chính xác 64 ký hiệu: A–Z (26), a–z (26), 0–9 (10), + và / (2). Mỗi đoạn sáu bit lập chỉ mục vào bảng chữ cái để tạo ra một ký tự đầu ra. Điều ngược lại cũng rõ ràng không kém: bốn ký tự lập chỉ mục thành bảng chữ cái để khôi phục bốn khối sáu bit, được nhóm lại thành ba byte.
Từ byte đến chỉ số 6-bit — cách 24 bits được chia thành bốn nhóm và tại sao ký hiệu 64 lại đủ chính xác
Đây là lý do tại sao Base64 mang lại cảm giác tự nhiên ở mọi nơi. Lấy ba byte M, a, n trong ASCII: 0x4D, 0x61, 0x6E. Viết ở dạng nhị phân: 01001101, 01100001, 01101110. Ghép nối tất cả 24 bits: 010011010110000101101110. Nhóm lại thành bốn khối sáu bit: 010011 010110 000101 101110. Diễn giải dưới dạng số nhị phân: 19, 22, 5, 46. Lập chỉ mục vào bảng chữ cái Base64 (A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). Chỉ mục 19 là T, chỉ mục 22 là W, chỉ mục 5 là F, chỉ mục 46 là u.
Đầu ra: TWFu. Việc tra cứu chỉ mục là cơ học. Bảng chữ cái Base64 là trình tự mà vị trí đóng vai trò quan trọng: mọi cách triển khai đều sử dụng cùng một thứ tự A–Z, a–z, 0–9, +, /. Thứ tự khác nhau tạo ra đầu ra khác nhau; thay đổi thứ tự chính xác là cách base64url hoạt động. Trong bảng chữ cái chuẩn, chữ in hoa chiếm các chỉ số 0–25, chữ thường 26–51, chữ số 52–61, ký tự đặc biệt 62–63. Thứ tự này là tùy ý nhưng được cố định bởi RFC; mọi bộ giải mã đều mong đợi ánh xạ giống nhau.
Bảng chữ cái và tra cứu chỉ mục — A–Z, a–z, 0–9, + và / theo thứ tự và tại sao thứ tự lại quan trọng khi so sánh
Nếu bạn viết bảng chữ cái trên giấy và đếm cẩn thận, bạn có thể mã hóa thủ công mà không cần máy tính: tra cứu 19, đếm A B C...T, viết T, lặp lại. Việc đảo ngược cũng đơn giản không kém. Cho TWFu, tra từng ký tự trong bảng chữ cái: T là 19, W là 22, F là 5, u là 46. Chuyển đổi sang nhị phân (các số 0 đứng đầu cho sáu bit): 010011, 010110, 000101, 101110. Ghép nối: 010011010110000101101110.
Nhóm thành ba byte tám bit: 01001101, 01100001, 01101110. Giải thích dưới dạng thập phân hoặc thập lục phân: 77, 97, 110 hoặc 0x4D, 0x61, 0x6E. Chuyển đổi sang ASCII: M, a, n. Bạn đã khôi phục được ba byte gốc. Đây là lý do tại sao Base64 có thể đảo ngược và tại sao việc đệm chỉ trở nên cần thiết đối với các đầu vào không chia hết cho ba. Base64 mã hóa byte chính xác và không có gì hơn thế. Encoding Man và byte mã hóa (77, 97, 110) là các hoạt động giống hệt nhau; Base64 không biết hoặc không quan tâm đến ký tự, ngôn ngữ hoặc mã hóa.
Ví dụ hoạt động: mã hóa 'Man' bằng tay — nhị phân của M, a và n, bốn chỉ số và bốn ký tự đầu ra
Nó nhìn thấy byte. Mối quan tâm riêng biệt giữa bộ mã hóa và bộ giải mã của công cụ: kiểu nhập văn bản như Man đi qua TextEncode trước tiên, chuyển thành UTF-8 byte. Những byte đó là đầu vào Base64. TWFu đầu ra là văn bản (ASCII ký tự), nhưng là viết tắt của byte, không phải từ. Công cụ đọc TWFu khác nhau sẽ khôi phục byte (77, 97, 110) và phải quyết định độc lập xem chúng đại diện cho từ, hình ảnh, thông báo trong một bảng mã khác hay thứ gì khác.
Đầu vào lớn là sự lặp lại nhiều lần của mẫu này. Tệp 300 byte sử dụng 300/3 = 100 khối ba byte, mỗi khối trở thành bốn ký tự, tạo ra 400 ký tự đầu ra. Khi khối cuối cùng được đệm, bộ giải mã sẽ loại bỏ phần điền số 0 thay vì tạo ra một byte khác. Ranh giới đó hiển thị với đầu vào hai byte: ba chỉ số hữu ích tồn tại, vị trí thứ tư là dấu bằng và chỉ có mười sáu bit được xây dựng lại thuộc về kết quả.
Đảo ngược quá trình - tra cứu chỉ mục, đóng gói bit và vị trí của các bit đệm khi giải mã bốn ký tự thành ba byte
Vì mẫu là đều đặn nên thao tác nhanh: dịch bit, tra cứu, ghi. Điểm bất thường duy nhất là khối cuối cùng khi độ dài đầu vào không phải là bội số của ba, được xử lý bằng phần đệm. Bởi vì mỗi khối đều độc lập—các bit của một khối không ảnh hưởng đến khối tiếp theo—Base64 có thể mã hóa tăng dần: nạp byte vào, lấy ký tự ra mà không cần đợi toàn bộ đầu vào.
Base64url chỉ khác nhau ở chỗ thay thế bảng chữ cái. Các chỉ số 62 và 63 trở thành - và _ thay vì + và /. Việc nhóm lại bit giống hệt nhau; ánh xạ byte sang ký tự giống hệt nhau; chỉ có bảng tra cứu thay đổi. Do đó, bộ giải mã tay có thể sử dụng lại mọi ca và mặt nạ từ Base64 tiêu chuẩn, chỉ thay thế hai ký hiệu đầu cuối đó.
Tại sao kết quả là một chuỗi byte chứ không phải văn bản — bước riêng biệt biến byte thành UTF-8 ký tự
Đây là lý do tại sao phần RFC 4648 5 mô tả nó là bảng chữ cái riêng biệt chứ không phải bảng mã khác. Chuỗi TWFu trong Base64 tiêu chuẩn không rõ ràng: nó chỉ có thể có nghĩa là các chỉ số (19, 22, 5, 46). Trong base64url, chuỗi sẽ cần chứa - hoặc _ để khác nhau và nếu không có những chuỗi đó, các chỉ số tương tự sẽ được áp dụng.
Các lỗi trong quá trình triển khai thường liên quan đến từng lỗi dịch chuyển bit hoặc ánh xạ bảng chữ cái không chính xác. Bộ mã hóa sử dụng sai thứ tự bảng chữ cái sẽ tạo ra đầu ra khác nếu a và A bị hoán đổi. Bộ giải mã xử lý sai khối phần cuối cùng (khi có phần đệm) có thể khôi phục số byte sai. Bộ mã hóa và giải mã Base64 sử dụng bảng chữ cái tiêu chuẩn và xử lý phần đệm bằng RFC 4648, do đó bạn có thể dán bất kỳ ví dụ được tính toán thủ công nào và kiểm tra công việc.
Điều này không bao gồm những gì - base64url, ngắt dòng MIME và hiệu suất của bộ đệm lớn
Bởi vì phép toán bit mang tính xác định nên bất kỳ lỗi nào trong quá trình mã hóa thủ công sẽ tạo ra kết quả khác nhau khi được giải mã, khiến lỗi xảy ra ngay lập tức. Base32 (RFC 4648 phần 6) mở rộng nguyên tắc thành các khối 5 bit: 32 ký hiệu (A–Z và 2–7), do đó, 5 bit khớp chính xác với một ký tự và 40 bits (năm byte) tập hợp lại thành 8 ký tự. Áp dụng logic tập hợp lại tương tự; sự khác biệt là kích thước bảng chữ cái và do đó tỷ lệ byte đầu vào so với ký tự đầu ra.
Hệ thập lục phân (cơ sở16) sử dụng tám trong số 256 kết hợp ký hiệu có thể có và ánh xạ một byte thành hai ký tự mà không cần nhóm lại. Hiểu Base64 như việc tập hợp lại bit làm cho các biến thể trở nên đơn giản về mặt khái niệm: chọn bit cho mỗi ký tự, nhập nhóm cho phù hợp, tra cứu từng nhóm trong bảng chữ cái. Khi gỡ lỗi Base64, hình ảnh bit là công cụ của bạn. Nếu byte bị hỏng, hãy mã hóa lại chúng và so sánh từng ký tự đầu ra. Nếu không chắc TWFu chứa byte nào, hãy giải mã nó và kiểm tra đầu ra ở dạng hex.
Bài học rút ra: Base64 là sự tập hợp lại các bit có thể đảo ngược - cách bộ mã hóa và giải mã Base64 cho phép bạn kiểm tra bất kỳ khối được tính toán bằng tay nào ngay lập tức trong trình duyệt
Bộ mã hóa và giải mã Base64 hiển thị cả ký tự và chế độ xem hex, giúp đơn giản hóa việc xác minh xem xem byte văn bản (sẽ giải mã thành văn bản dễ đọc) hay dữ liệu nhị phân (hiển thị dưới dạng hex và tốt nhất được lưu giữ dưới dạng byte chứ không phải văn bản). Quy trình từng bước—byte thành bit, bit thành chỉ mục, chỉ mục thành ký tự—có tính xác định, nhanh chóng và giống nhau trong mọi hoạt động triển khai tuân thủ. RFC 4648 xác định Base64 một cách chính thức để có thể so sánh việc triển khai.
Tiêu chuẩn chỉ định bảng chữ cái, bố cục bit, quy tắc đệm và cách xử lý ngắt dòng trong MIME. Việc biết tiêu chuẩn giúp dễ dàng xác minh xem bộ giải mã có tuân thủ nghiêm ngặt (Base64 chuẩn) hay chấp nhận các biến thể (thiếu phần đệm hoặc URL ký tự an toàn). Nhiều ứng dụng trong thế giới thực sử dụng Base64 hơi khác một chút: một số bỏ qua phần đệm, một số sử dụng các ký tự an toàn URL, một số ngắt dòng ở các độ dài dòng khác nhau. Bộ mã hóa và giải mã Base64 tự động xử lý các biến thể nhưng việc hiểu rõ tiêu chuẩn giúp việc gỡ lỗi tích hợp trở nên đơn giản hơn nhiều.