개발자 도구 · Base64 인코더 및 디코더
Base64가 3바이트를 4문자로 단계별로 변환하는 방법
· 작동 방식
베이스64 인코딩 유니코드
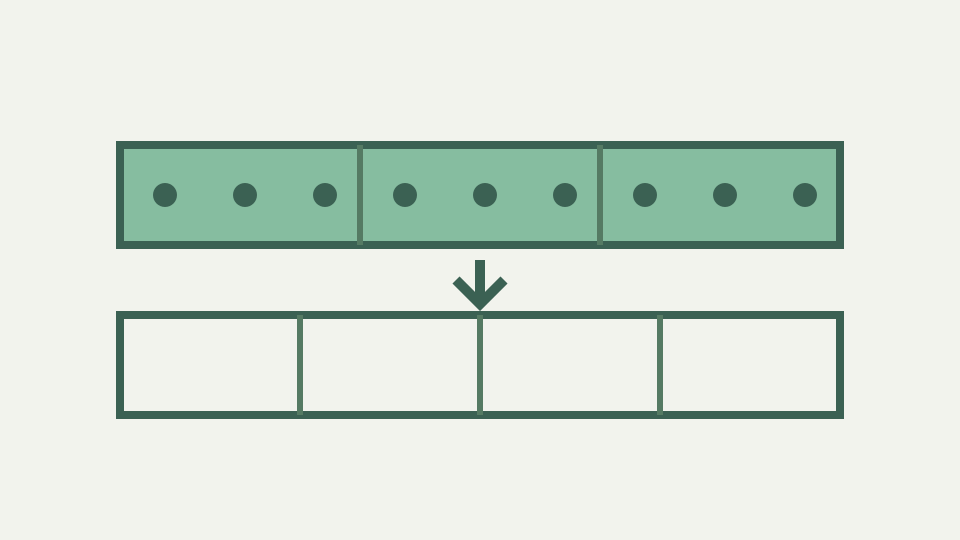
Base64는 비트를 재그룹화하는 것에 지나지 않습니다. 즉, 24 비트는 입력되고 4개의 6 비트 인덱스는 출력됩니다. 이 게시물에서는 테이블 조회, 비트 이동 및 역방향 트립을 살펴보므로 형식이 블랙박스가 되지 않습니다.
문자열 'TWFu'와 여기에 숨겨진 단어 — 실제 4자 블록에서 시작하여 각 문자의 출처를 묻습니다.
4자로 구성된 Base64 문자열 TWFu는 3바이트 시퀀스 Man으로 디코딩됩니다. 3바이트가 4자로 바뀌는 방식은 Base64가 암호화나 압축이 아니라 순수한 비트 재그룹화임을 나타냅니다. 비트 레이아웃이 보이면 Base64 출력이 더 이상 불투명해지지 않고 예측 가능해집니다. Man을 직접 인코딩하고 TWFu에 대해 검증하면 Base64가 입력 3바이트당 항상 4자를 출력하는 이유를 이해할 수 있습니다.
Base64의 놀라운 점은 3바이트(24 비트)가 6비트씩 4개의 청크로 완벽하게 재편성된다는 것입니다. 6비트는 0부터 63까지를 나타내므로 알파벳에는 정확히 64 기호(A–Z(26), a–z(26), 0–9(10), + 및 /)가 포함됩니다. (2). 각 6비트 청크는 알파벳으로 색인화되어 하나의 출력 문자를 생성합니다. 그 반대도 똑같이 깔끔합니다. 4개의 문자가 알파벳으로 색인되어 4개의 6비트 청크를 복구하고 3바이트로 재그룹됩니다.
바이트에서 6비트 인덱스까지 — 24 비트가 4개의 그룹으로 분할되는 방법과 64 기호가 정확히 충분한 이유
이것이 Base64가 어디에서나 자연스럽게 느껴지는 이유입니다. ASCII: 0x4D, 0x61, 0x6E에서 3바이트 M, a, n을 사용합니다. 바이너리로 작성: 01001101, 01100001, 01101110. 모든 24 비트를 연결합니다: 010011010110000101101110. 6비트의 4개 청크로 재그룹화: 010011 010110 000101 101110. 이진수로 해석: 19, 22, 5, 46. Base64 알파벳 인덱스(A=0, B=1, ...Z=25, a=26, ...z=51, 0=52, ...9=61, +=62, /=63). 인덱스 19는 T, 인덱스 22은 W, 인덱스 5은 F, 인덱스 46은 u입니다.
출력: TWFu. 인덱스 조회는 기계적입니다. Base64 알파벳은 위치가 중요한 순서입니다. 모든 구현은 동일한 순서 A–Z, a–z, 0–9, +, /. 다른 순서는 다른 출력을 생성합니다. 순서 변경은 정확히 base64url이 작동하는 방식입니다. 표준 알파벳에서 대문자는 인덱스 0–25, 소문자 26–51, 숫자 52–61, 특수 문자 62–63를 차지합니다. 이 순서는 임의적이지만 RFC에 의해 고정됩니다. 모든 디코더는 동일한 매핑을 기대합니다.
알파벳 테이블 및 인덱스 조회 — A–Z, a–z, 0–9, + 및 / 순서 및 순서가 비교에 중요한 이유
종이에 알파벳을 쓰고 주의 깊게 세는 경우 컴퓨터 없이 수동으로 인코딩할 수 있습니다. 19을 찾아 A B C...T를 세고 T를 쓰고 반복합니다. 반전도 마찬가지로 간단합니다. TWFu가 주어지면 알파벳의 각 문자를 찾습니다. T는 19, W는 22, F는 5, u는 46입니다. 이진수(6비트 앞에 0이 있음)로 변환: 010011, 010110, 000101, 101110. 연결: 010011010110000101101110.
8비트의 3바이트로 그룹화합니다: 01001101, 01100001, 01101110. 10진수 또는 16진수로 해석: 77, 97, 110 또는 0x4D, 0x61, 0x6E. ASCII로 변환: M, a, n. 원본 3바이트를 복구했습니다. 이것이 Base64가 가역적이며 3으로 나눌 수 없는 입력에만 패딩이 필요한 이유입니다. Base64는 정확한 바이트만 인코딩합니다. Man 인코딩과 인코딩 바이트(77, 97, 110)는 동일한 작업입니다. Base64는 문자, 언어 또는 인코딩을 모르거나 신경 쓰지 않습니다.
작업된 예: 'Man'을 손으로 인코딩 — M, a 및 n의 이진수, 4개의 인덱스 및 4개의 출력 문자
바이트를 봅니다. 도구의 인코더와 디코더는 별도의 관심사입니다. Man과 같은 텍스트 입력은 먼저 TextEncoder를 거쳐 UTF-8 바이트로 변환됩니다. 해당 바이트는 Base64 입력입니다. 출력 TWFu는 텍스트(ASCII 문자)이지만 단어가 아닌 바이트를 나타냅니다. TWFu를 읽는 다른 도구는 바이트(77, 97, 110)를 복구하고 다른 인코딩의 단어, 이미지, 메시지 또는 기타 항목을 나타내는지 여부를 독립적으로 결정해야 합니다.
큰 입력은 이 패턴이 많이 반복되는 것입니다. 300바이트 파일은 3바이트로 구성된 300/3 = 100 블록을 사용하며, 각 블록은 4자가 되어 400 출력 문자를 생성합니다. 마지막 블록이 채워지면 디코더는 다른 바이트를 생성하는 대신 0 채우기를 버립니다. 해당 경계는 2바이트 입력으로 표시됩니다. 세 개의 유용한 인덱스가 남아 있고 네 번째 위치는 등호이며 재구성된 16비트만 결과에 속합니다.
프로세스 반전 — 인덱스 조회, 비트 패킹 및 4자를 3바이트로 디코딩할 때 패딩 비트가 이동하는 위치
패턴이 규칙적이므로 작업이 빠릅니다: 비트 이동, 조회, 쓰기. 유일한 불규칙성은 입력 길이가 3의 배수가 아닌 경우 패딩으로 처리되는 최종 블록입니다. 모든 블록은 독립적이므로(한 블록의 비트는 다음 블록에 영향을 주지 않음) Base64는 증분 방식으로 인코딩할 수 있습니다. 전체 입력을 기다리지 않고 바이트를 입력하고 문자를 가져옵니다.
Base64url은 알파벳 대체에서만 다릅니다. 인덱스 62 및 63은 + 및 /. 대신 - 및 _가 됩니다. 비트 재그룹화는 동일합니다. 바이트-문자 매핑은 동일합니다. 조회 테이블만 변경됩니다. 따라서 핸드 디코더는 표준 Base64의 모든 시프트와 마스크를 재사용하여 해당 두 개의 터미널 기호만 교체할 수 있습니다.
결과가 텍스트가 아닌 바이트 시퀀스인 이유 — 바이트를 UTF-8 문자로 변환하는 별도의 단계
이것이 RFC 4648 섹션 5이 이를 다른 인코딩이 아닌 고유한 알파벳으로 설명하는 이유입니다. 표준 Base64의 문자열 TWFu는 명확합니다. 이는 인덱스(19, 22, 5, 46)만 의미할 수 있습니다. base64url에서 문자열은 - 또는 _를 포함해야 하며, 존재하지 않으면 동일한 인덱스가 적용됩니다.
구현 오류는 일반적으로 비트 이동이나 잘못된 알파벳 매핑의 잘못된 실수와 관련됩니다. 잘못된 알파벳 순서를 사용하는 인코더는 a와 A가 바뀌면 다른 출력을 생성합니다. 디코더가 마지막 부분 블록(패딩이 있는 경우)을 잘못 처리하면 잘못된 바이트 수를 복구할 수 있습니다. Base64 인코더 및 디코더는 표준 알파벳을 사용하고 RFC 4648에 따라 패딩을 처리하므로 직접 계산한 예제를 붙여넣고 작업을 확인할 수 있습니다.
여기서 다루지 않는 내용 — base64url, MIME 줄 바꿈 및 대형 버퍼의 성능
비트 수학은 결정적이기 때문에 수동 인코딩의 모든 오류는 디코딩 시 다른 출력을 생성하므로 즉시 실수가 발생합니다. Base32(RFC 4648 섹션 6)는 원칙을 5비트 청크로 확장합니다. 즉, 32 기호(A–Z 및 2–7)이므로 5비트는 정확히 한 문자에 들어가고 40비트(5바이트)는 8문자로 다시 그룹화됩니다. 동일한 재그룹화 논리가 적용됩니다. 차이점은 알파벳 크기이며 결과적으로 입력 바이트와 출력 문자의 비율입니다.
16진수(base16)는 256 가능한 기호 조합 중 8개를 사용하고 재그룹화 없이 1바이트를 2문자로 매핑합니다. Base64를 비트 재그룹화로 이해하면 변형이 개념적으로 단순해집니다. 문자당 비트를 선택하고 그에 따라 입력을 그룹화하고 각 그룹을 알파벳으로 검색합니다. Base64를 디버깅할 때 비트 그림이 도구입니다. 바이트가 손상된 경우 다시 인코딩하고 출력 문자를 문자별로 비교하십시오. TWFu에 어떤 바이트가 포함되어 있는지 확실하지 않으면 이를 디코딩하고 16진수로 출력을 검사하세요.
요점: Base64는 가역적인 비트 재그룹화입니다. Base64 인코더 및 디코더를 사용하면 브라우저에서 직접 계산한 블록을 즉시 확인할 수 있습니다.
Base64 인코더 및 디코더는 문자와 16진수 보기를 모두 표시하므로 텍스트 바이트(읽을 수 있는 텍스트로 디코딩됨) 또는 이진 데이터(16진수로 표시되며 텍스트가 아닌 바이트로 유지되는 것이 가장 좋음)를 보는지 간단하게 확인할 수 있습니다. 바이트에서 비트로, 비트에서 인덱스로, 인덱스에서 문자로의 단계별 프로세스는 결정적이고 빠르며 모든 호환 구현에서 동일합니다. RFC 4648는 구현을 비교할 수 있도록 Base64를 공식적으로 정의합니다.
표준은 알파벳, 비트 레이아웃, 패딩 규칙 및 MIME에서 줄 바꿈이 처리되는 방법을 지정합니다. 표준을 알면 디코더가 표준을 엄격하게 따르는지(표준 Base64) 변형을 허용하는지(패딩 누락 또는 URL 안전 문자) 쉽게 확인할 수 있습니다. 많은 실제 애플리케이션은 Base64를 약간 다르게 사용합니다. 일부는 패딩을 생략하고, 일부는 URL 안전 문자를 사용하고, 일부는 다른 줄 길이로 줄바꿈합니다. Base64 인코더 및 디코더는 변형을 자동으로 처리하지만 표준을 이해하면 통합 문제 디버깅이 훨씬 간단해집니다.