Outils de développement · Encodeur et décodeur Base64
Dans quelle mesure Base64 agrandit-il vos données ? Les frais généraux 4/3 ont été calculés
· Comment ça marche
base64 codage Navigateur
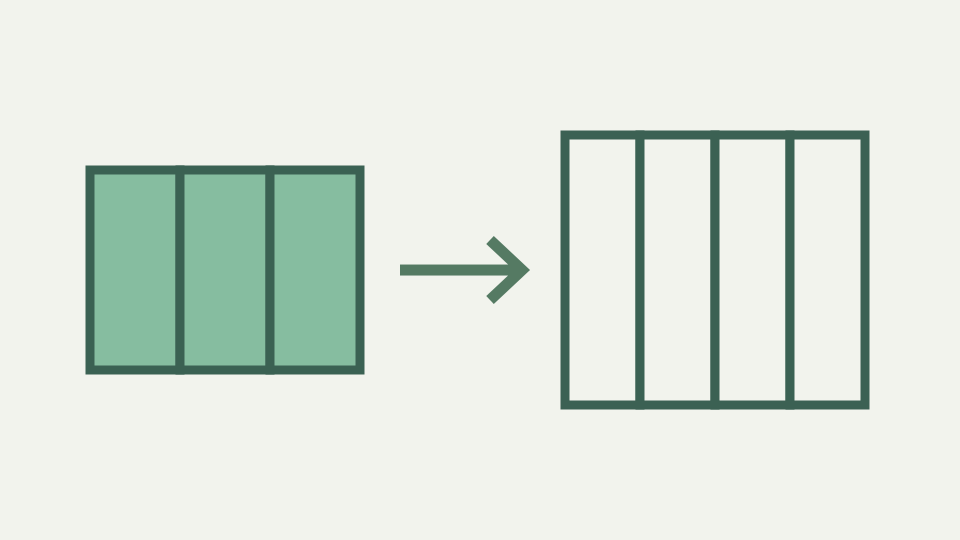
La sortie Base64 est environ un tiers plus grande que son entrée, plus le remplissage et éventuellement les sauts de ligne. Cet article dérive la formule exacte et l'applique à des tailles réalistes afin que vous puissiez juger du coût.
L'icône 30 KB devenue 40 KB dans le bundle - un saut de taille concret qui a surpris une révision de build
Une icône 30 KB insérée en Base64 dans le fichier CSS devient 40 KB, et une question de révision de build se pose : d'où vient le 10 KB supplémentaire ? Le facteur d'expansion pour Base64 est toujours 4/3: tous les trois octets d'entrée produisent quatre octets de sortie (quatre caractères). Pour l'entrée 30 KB (30,000 octets), divisez par trois pour obtenir 10,000 groupes, multipliez par quatre pour obtenir la sortie 40,000 octets.
Les mathématiques sont déterministes et incontournables : Base64 n'est pas un format de compression. Si l'intégration d'un actif coûte 33 % de bande passante en plus et que les pages se chargent plus rapidement grâce à une requête HTTP en moins, c'est un compromis qui mérite d'être mesuré. Si cela coûte 33 % de plus et se charge plus lentement, l'inline n'en valait pas la peine. Le rapport 4/3 provient de la disposition des bits. Trois octets correspondent à 24 bits ; quatre caractères Base64 portent 24 bits (chacun porte six bits).
Pourquoi 4/3 est le plancher - six bits par caractère contre huit par octet, et d'où vient la surcharge restante
Jusqu'à présent, le ratio est de 1 :1. Mais les caractères Base64 sont du texte (ASCII 0–127) et le caractère ASCII moyen en codage UTF-8 ou Latin-1 est d'un octet. Ainsi, quatre caractères Base64 représentent quatre octets en sortie pour trois octets en entrée, rapport de 4/3. Ce n'est pas universel : si Base64 était sorti au format binaire (un octet par caractère, regroupé en six bits), le rapport serait 3/4 (compression).
Étant donné que Base64 est conçu pour le transport de texte, il utilise des caractères de texte et le coût est d'une augmentation de taille de 33 %. Le rembourrage ajoute une petite marge à la fin. Si la longueur d’entrée est multiple de trois, aucun remplissage n’est nécessaire. Si la longueur d'entrée 1 mod 3 (un octet de moins que le multiple), deux caractères de remplissage = ajoutés, augmentant la sortie de 2. Si 2 mod 3, un caractère de remplissage = ajouté, augmentant de 1.
La formule exacte avec remplissage - ceil (n/3) × 4 caractères, et l'effet pour les entrées de 1, 2 et 3 octets
Pour les entrées volumineuses, la marge est négligeable : une entrée de 300 octets nécessite 400 caractères plus au plus deux caractères de remplissage, soit une différence inférieure à 0.5 %. Pour les petites entrées (1–3 octets), le remplissage domine : un octet produit YQ== (quatre caractères), expansion 4x. Mais la moyenne des fichiers est dominée par les fichiers volumineux. La formule exacte est ceil(n / 3) × 4 caractères, où n est le nombre d'octets d'entrée.
Pour n = 1, plafond(1/3) × 4 = 1 × 4 = 4. Pour n = 2, ceil(2/3) × 4 = 1 × 4 = 4. Pour n = 3, ceil(3/3) × 4 = 1 × 4 = 4. Pour n = 4, plafond(4/3) × 4 = 2 × 4 = 8. Pour n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Les cas à faible entrée expliquent pourquoi « environ un tiers » n'est pas exact pour chaque valeur. Un octet occupe toujours un bloc de quatre caractères, tout comme deux octets, le rapport approche les quatre tiers seulement, car de nombreux groupes complets de trois octets dominent le bloc complété final.
Exemple concret : mesure d'une chaîne 20 caractère UTF-8 - en comptant les octets plutôt que les caractères, puis la longueur Base64
La fonction de plafond tient compte du fait que le groupe final n'est pas un multiple complet de trois. À mesure que n grandit, ceil(n/3) se rapproche de n/3, donc la sortie se rapproche de (n/3) × 4 = 4n/3, le rapport 4/3.
Mesurer une chaîne concrète : 20 caractères mélangés ASCII, accents et emoji. Le nombre de caractères est 15 en JavaScript (l'emoji en compte un). Le nombre d'octets UTF-8 diffère : lettres ASCII 1 octets chacune, lettre accentuée 2 octets (0xC3 0xA9 pour é), emoji 4 octets (0xF0 0x9F 0x98 0x80). L'outil signale séparément les caractères UTF-16, les points de code Unicode et UTF-8. Cette distinction empêche qu'une phrase de vingt caractères contenant des symboles multi-octets soit facturée comme vingt octets. La longueur codée suit le nombre d'octets, et non ce qu'un humain compte à l'écran.
Sauts de ligne et retour à la ligne MIME : comment le formatage des colonnes 76 ajoute quelques pour cent supplémentaires
Total environ 18 octets. Base64 les code : ceil(18/3) × 4 = 6 × 4 = 24 caractères. Puisque 18 multiple de trois, aucun remplissage n'est nécessaire. La sortie Base64 est de 24 caractères. L'encodage ajoute 24 - 18 = 6 octets, ou 33%, confirmant la formule 4/3 introduit une surcharge supplémentaire MIME classique à 76 caractères par ligne et ajoute une nouvelle ligne.
Une sortie Base64 de 400 caractères devient environ 405 octets avec des nouvelles lignes insérées. Pour chaque 76 caractères de sortie Base64, un octet de nouvelle ligne inséré. Pour les fichiers volumineux, ajoute moins de 2 %. Pour les pièces jointes aux e-mails, la convention de nouvelle ligne est standard et attendue par les analyseurs ; l'outil accepte le Base64 enveloppé et décode correctement. Les interactions de compression compliquent l’analyse de la taille. Les données binaires brutes (image, vidéo) se compressent différemment du texte Base64. ToolAcre insère une nouvelle ligne après chaque tranche de caractères 76 configurée et exclut ces nouvelles lignes de sa mesure de caractères codés affichée. Un budget au format filaire doit rajouter les séparateurs ; une comparaison de la mesure visible seule décrit les symboles Base64, et non chaque octet de fin de ligne transmis.
Interactions de compression : pourquoi le texte Base64 a tendance à se compresser moins bien que les octets bruts qu'il représente La chaîne
La chaîne Base64 peut être compressée à 60% de sa taille avec gzip, et l'image peut être compressée à 25%. Étant donné que gzip recherche des modèles d'octets répétés, la représentation textuelle (lettres A à Z plus + / ou - _) a moins de répétitions que les données binaires. L'intégration d'une image avec compression coûte souvent plus cher en code que l'intégration séparée. Pour les polices, particulièrement complexes avec de nombreux glyphes, l’inline Base64 peut s’avérer inefficace.
L'analyse des compromis dépend du contexte spécifique. L'intégration d'URI de petites données (10–50 octets) peut valoir la peine pour éviter les requêtes HTTP. L'intégration d'un actif volumineux (100 KB) pourrait ne pas l'être. La compression dépend des modèles à la fois dans la source et dans sa représentation Base64, donc un pourcentage universel de surcharge compressée serait malhonnête. Mesurez l'actif réel avant et après la compression de la réponse environnante. Le coût certain est le nombre de caractères non compressés donné par la formule de bloc.
Ce que cela ne couvre pas : mesurer les performances de rendu ou de décodage et les optimisations spécifiques au format telles que WebP
Si l'actif sur CDN est proche de l'utilisateur, éviter la demande n'en profite pas. Si l'actif sur le même serveur et le chargement nécessitent un aller-retour supplémentaire, l'inline peut être justifiée. La mesure est essentielle : utilisez une formule pour calculer la taille en ligne, ajoutez le nombre de caractères au fichier CSS ou HTML, mesurez la taille totale du bundle et le temps de chargement.
La surcharge de 33 % est certaine ; l’avantage en termes de performance ne l’est pas. URL-safe Base64 (base64url) a le même rapport 4/3, juste des caractères différents. La suppression du remplissage enregistre deux caractères dans le pire des cas. Pour les gros fichiers, négligeable. Pour les jetons JWT (trois segments base64url joints par des points), la suppression du remplissage est conventionnelle mais permet d'économiser très peu d'espace ; la taille réelle est le contenu du jeton, pas la surcharge d'encodage. La vitesse de rendu, le décodage des images et les formats alternatifs tels que WebP nécessitent des mesures différentes. Une chaîne Base64 plus courte n'implique pas une peinture plus rapide, et cet outil texte uniquement n'accepte pas de fichier image. Sa contribution fiable est l'arithmétique du texte UTF-8 saisi dans le panneau.
À retenir : prévoyez un tiers de plus – comment l'encodeur et le décodeur Base64 vous donnent la longueur réelle encodée de n'importe quel texte afin que vous puissiez mesurer plutôt que deviner
La compression encode également le texte de la même manière ; que les deux derniers caractères soient == ou une chaîne plus courte ne fait presque aucune différence dans la sortie gzip. L'encodeur et le décodeur Base64 signalent immédiatement le nombre d'octets d'entrée et le nombre de caractères de sortie. Pour tout encodage de texte, vous pouvez voir l'augmentation exacte de la taille. Pour les chaînes UTF-8 avec des caractères multi-octets, l'outil montre que le nombre de caractères (ce que voir) diffère du nombre d'octets (ce qui encode en Base64).
Une chaîne de caractères 10 peut faire 15 octets si elle contient des accents et des emoji, produisant 20 caractères de sortie Base64 au lieu de 4/3 ratio basé sur le nombre de caractères. Comprendre la distinction explique pourquoi l'intégration d'icônes contenant beaucoup d'emojis est plus coûteuse que l'art ASCII : les emojis ne coûtent pas plus cher, UTF-8 octets qu'ils représentent. Pour une valeur en ligne candidate, enregistrez côte à côte le nombre de UTF-8 octets et le nombre de caractères codés de l'outil. Incluez ensuite le préfixe URI, la syntaxe CSS et tout emballage requis par la destination. Cette mesure complète est plus utile que de répéter un pourcentage arrondi sans les coûts de cadrage.