Entwicklertools · Base64-Encoder und -Decoder
Wie viel größer macht Base64 Ihre Daten? Der 4/3-Overhead hat geklappt
· Wie es funktioniert
base64 Kodierung Leistung
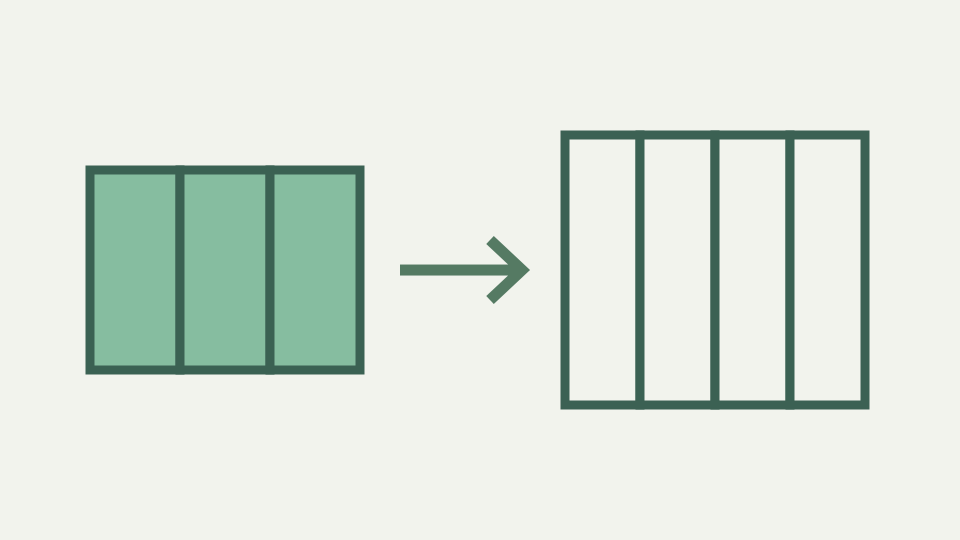
Die Base64-Ausgabe ist etwa ein Drittel größer als die Eingabe, plus Auffüllung und möglicherweise Zeilenumbrüche. In diesem Beitrag wird die genaue Formel abgeleitet und auf realistische Größen angewendet, damit Sie die Kosten beurteilen können.
Das 30 KB-Symbol, das im Bundle zu 40 KB wurde – ein konkreter Größensprung, der eine Build-Überprüfung überraschte
Ein als Base64 in der CSS-Datei eingebundenes 30 KB-Symbol wird zu 40 KB, und es stellt sich die Frage der Build-Überprüfung: Woher kamen die zusätzlichen 10 KB? Der Erweiterungsfaktor für Base64 ist immer 4/3:. Alle drei Eingabebytes erzeugen vier Ausgabebytes (vier Zeichen). Teilen Sie für 30 KB-Eingaben (30,000 Bytes) durch drei, um 10,000-Gruppen zu erhalten, und multiplizieren Sie mit vier, um 40,000 Bytes-Ausgaben zu erhalten.
Mathematik ist deterministisch und unvermeidlich: Base64 ist kein Komprimierungsformat. Wenn das Inlining von Assets 33 % mehr Bandbreite kostet und die Seite schneller geladen wird, weil eine HTTP-Anfrage weniger erforderlich ist, ist dieser Kompromiss eine Überlegung wert. Wenn es 33 % mehr kostet und langsamer lädt, lohnt sich Inlining nicht. Das Verhältnis 4/3 ergibt sich aus dem Bit-Layout. Drei Bytes sind 24 Bits; Vier Base64-Zeichen tragen 24 Bits (jedes trägt sechs Bits).
Warum 4/3 der Mindestwert ist – sechs Bits pro Zeichen gegenüber acht pro Byte und woher der verbleibende Overhead kommt
Bisher beträgt das Verhältnis 1:1. Base64-Zeichen sind jedoch Text (ASCII 0–127), und das durchschnittliche ASCII-Zeichen in der Codierung UTF-8 oder Latin-1 beträgt ein Byte. Vier Base64-Zeichen sind also vier ausgegebene Bytes für drei eingegebene Bytes, Verhältnis 4/3.. Dies ist nicht universell: Wenn Base64 als Binärformat ausgegeben würde (ein Byte pro Zeichen, gepackt in sechs Bits), wäre das Verhältnis 3/4 (Komprimierung).
Da Base64 für den Texttransport konzipiert ist, verwendet es Textzeichen und die Kosten betragen 33 % Größenerhöhung. Durch die Polsterung wird am Ende ein kleiner Rand hinzugefügt. Wenn die Eingabelänge ein Vielfaches von drei ist, ist kein Auffüllen erforderlich. Wenn die Eingabelänge 1 mod 3 (ein Byte weniger als mehrere) beträgt, werden zwei Füllzeichen = hinzugefügt, wodurch die Ausgabe um 2 erhöht wird. Wenn 2 mod 3, wird ein Füllzeichen = hinzugefügt, erhöht um 1.
Die genaue Formel mit Auffüllung – ceil(n/3) × 4 Zeichen und die Auswirkung für Eingaben von 1, 2 und 3 Bytes
Bei großen Eingaben ist der Spielraum vernachlässigbar: 300-Byte-Eingaben benötigen 400 Zeichen plus höchstens zwei Füllzeichen, Differenz von weniger als 0.5 %. Bei winzigen Eingaben (1–3 Bytes) dominiert das Auffüllen: Ein Byte erzeugt YQ== (vier Zeichen), 4-fache Erweiterung. Der Durchschnitt aller Dateien wird jedoch von großen Dateien dominiert. Die genaue Formel lautet ceil(n / 3) × 4 Zeichen, wobei n die Anzahl der Eingabebytes ist.
Für n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Für n = 2, ceil(2/3) × 4 = 1 × 4 = 4. Für n = 3, ceil(3/3) × 4 = 1 × 4 = 4. Für n = 4, ceil(4/3) × 4 = 2 × 4 = 8 Für n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Die Fälle mit kleiner Eingabe erklären, warum „ungefähr ein Drittel“ immer noch einen Vier-Zeichen-Block einnimmt, während das Verhältnis nur vier Drittel beträgt, da viele vollständige Drei-Byte-Gruppen den letzten aufgefüllten Block dominieren.
Arbeitsbeispiel: Messen einer Zeichenfolge mit 20-Zeichen und UTF-8 – Zählen von Bytes statt Zeichen und dann der Base64-Länge
Die Deckenfunktion berücksichtigt, dass die letzte Gruppe kein vollständiges Vielfaches von drei ist. Wenn n größer wird, nähert sich ceil(n/3) n/3,, sodass sich die Ausgabe (n/3) × 4 = 4n/3, dem Verhältnis 4/3 nähert.
Konkrete Zeichenfolge messen: 20 Zeichen gemischt ASCII, Akzente und Emoji. Die Zeichenanzahl beträgt in JavaScript 15 (Emoji zählt eins). Die Anzahl der UTF-8 Bytes ist unterschiedlich: ASCII-Buchstaben 1 Bytes, Akzentbuchstaben 2 Bytes (0xC3 0xA9 für é), Emoji 4 Bytes (0xF0 0x9F 0x98 0x80). Das Tool meldet UTF-16-Zeichen, Unicode-Codepunkte und UTF-8 Bytes separat. Diese Unterscheidung verhindert, dass ein Satz mit zwanzig Zeichen, der Multibyte-Symbole enthält, als zwanzig Bytes bewertet wird. Die codierte Länge richtet sich nach der Byteanzahl, nicht danach, was ein Mensch auf dem Bildschirm zählt.
Zeilenumbrüche und MIME-Umbruch – wie die 76-Spaltenformatierung noch ein paar Prozent hinzufügt
Insgesamt etwa 18 Bytes. Base64 kodiert diese: ceil(18/3) × 4 = 6 × 4 = 24 Zeichen. Da 18 ein Vielfaches von drei ist, ist keine Polsterung erforderlich. Die Base64-Ausgabe umfasst 24 Zeichen. Durch die Codierung werden 24 - 18 = 6 Bytes oder 33 % hinzugefügt, was die 4/3-Formel bestätigt. MIME Base64-Wrapping führt zu zusätzlichem Overhead. Classic MIME bricht bei 76 Zeichen pro Zeile um und fügt eine neue Zeile hinzu.
Eine Base64-Ausgabe mit 400-Zeichen wird mit eingefügten Zeilenumbrüchen zu etwa 405 Bytes. Für alle 76 Zeichen der Base64-Ausgabe wird ein Newline-Byte eingefügt. Bei großen Dateien werden weniger als 2 % hinzugefügt. Für E-Mail-Anhänge ist die Newline-Konvention Standard und wird von Parsern erwartet; Das Tool akzeptiert verpacktes Base64 und dekodiert korrekt. Komprimierungsinteraktionen erschweren die Größenanalyse. Rohe Binärdaten (Bild, Video) werden anders komprimiert als Base64-Text. ToolAcre fügt nach jedem konfigurierten 76-Zeichen-Slice eine neue Zeile ein und schließt diese neuen Zeilen aus der angezeigten Messung der codierten Zeichen aus. Bei einem Drahtformat-Budget müssen die Trennzeichen wieder hinzugefügt werden; Ein Vergleich der sichtbaren Messung allein beschreibt die Base64-Symbole, nicht jedes übertragene Zeilenende-Byte.
Komprimierungsinteraktionen – warum Base64-Text tendenziell schlechter komprimiert wird als die Rohbytes, die er darstellt
Die Base64-Zeichenfolge wird mit gzip möglicherweise auf 60 % ihrer Größe komprimiert, und das Bild wird möglicherweise auf 25 % komprimiert. Da gzip nach sich wiederholenden Bytemustern sucht, weist die Textdarstellung (Buchstaben A–Z plus + / oder - _) weniger Wiederholungen auf als die Darstellung von Binärdaten. Das Einbetten von Bildern mit Komprimierung kostet oft mehr im Code als das separate Einbetten. Bei besonders komplexen Schriftarten mit vielen Glyphen kann Base64-Inlining ineffizient sein.
Die Kompromissanalyse hängt vom spezifischen Kontext ab. Das Inlining kleiner Daten-URIs (10–50 Bytes) kann sich als Overhead lohnen, um HTTP-Anfragen zu vermeiden. Das Inlining eines großen Assets (100 KB) ist möglicherweise nicht möglich. Die Komprimierung hängt von Mustern sowohl in der Quelle als auch in ihrer Base64-Darstellung ab, daher wäre ein allgemeiner Prozentsatz für den komprimierten Overhead unehrlich. Messen Sie den tatsächlichen Vermögenswert vor und nach der umgebenden Antwortkomprimierung. Die bestimmten Kosten sind die durch die Blockformel angegebene unkomprimierte Zeichenanzahl.
Was dies nicht abdeckt – Messung der Rendering- oder Dekodierungsleistung und formatspezifische Optimierungen wie WebP
Wenn sich das Asset im CDN in der Nähe des Benutzers befindet, ist die Vermeidung von Anfragen nicht von Vorteil. Wenn sich das Asset auf demselben Server befindet und das Laden einen zusätzlichen Hin- und Rückweg erfordert, ist Inlining möglicherweise gerechtfertigt. Das Messen ist unerlässlich: Verwenden Sie eine Formel, um die Inline-Größe zu berechnen, fügen Sie der CSS- oder HTML-Datei die Zeichenanzahl hinzu, messen Sie die Gesamtpaketgröße und die Ladezeit.
33% Overhead ist sicher; Leistungsvorteil ist es nicht. URL-safe Base64 (base64url) hat das gleiche 4/3-Verhältnis, nur unterschiedliche Zeichen. Durch das Entfernen der Auffüllung werden im schlimmsten Fall zwei Zeichen eingespart. Bei großen Dateien vernachlässigbar. Bei JWT-Tokens (drei durch Punkte verbundene Base64-URL-Segmente) ist das Entfernen der Auffüllung üblich, spart aber sehr wenig Platz; Die tatsächliche Größe ist der Token-Inhalt, nicht der Codierungsaufwand. Rendering-Geschwindigkeit, Bilddekodierung und alternative Formate wie WebP erfordern unterschiedliche Messungen. Eine kürzere Base64-Zeichenfolge bedeutet nicht, dass das Malen schneller ist, und dieses Nur-Text-Tool akzeptiert keine Bilddatei. Sein zuverlässiger Beitrag ist die Arithmetik für UTF-8 Text, der in das Panel eingegeben wird.
Fazit: Budgetieren Sie ein Drittel mehr – wie der Base64-Encoder und -Decoder Ihnen die tatsächlich codierte Länge jedes Textes liefert, sodass Sie ihn messen und nicht raten können
Durch die Komprimierung wird auch Text auf ähnliche Weise codiert. Ob die letzten beiden Zeichen == sind oder die Zeichenfolge kürzer ist, macht in der gzip-Ausgabe fast keinen Unterschied. Der Base64-Encoder und -Decoder meldet sofort sowohl die Anzahl der Eingabebytes als auch die Anzahl der Ausgabezeichen. Für jede Textkodierung kann die genaue Größenzunahme angezeigt werden. Für UTF-8-Zeichenfolgen mit Multibyte-Zeichen zeigt das Tool an, dass sich die Zeichenanzahl (was siehe) von der Byteanzahl (was Base64 kodiert) unterscheidet.
Eine 10-Zeichenfolge kann 15 Bytes umfassen, wenn sie Akzente und Emojis enthält, wodurch 20 Zeichen der Base64-Ausgabe anstelle eines 4/3-Verhältnisses basierend auf der Zeichenanzahl erzeugt werden. Das Verständnis der Unterscheidung verdeutlicht, warum das Inlining von Emoji-lastigen Symbolen teurer ist als ASCII-Grafik: Nicht Emoji kostet mehr, UTF-8 Bytes, die sie darstellen. Notieren Sie für einen Inline-Kandidatenwert die UTF-8-Byte-Anzahl des Tools und die Anzahl der codierten Zeichen nebeneinander. Fügen Sie dann das URI-Präfix, die CSS-Syntax und alle für das Ziel erforderlichen Umbrüche hinzu. Diese vollständige Messung ist nützlicher als die Wiederholung eines gerundeten Prozentsatzes ohne die damit verbundenen Kosten.