डेवलपर टूल · Base64 एनकोडर और डिकोडर
Base64 आपके डेटा को कितना बड़ा बनाता है? 4/3 ओवरहेड ने काम किया
· यह काम किस प्रकार करता है
Base64 एन्कोडिंग प्रदर्शन
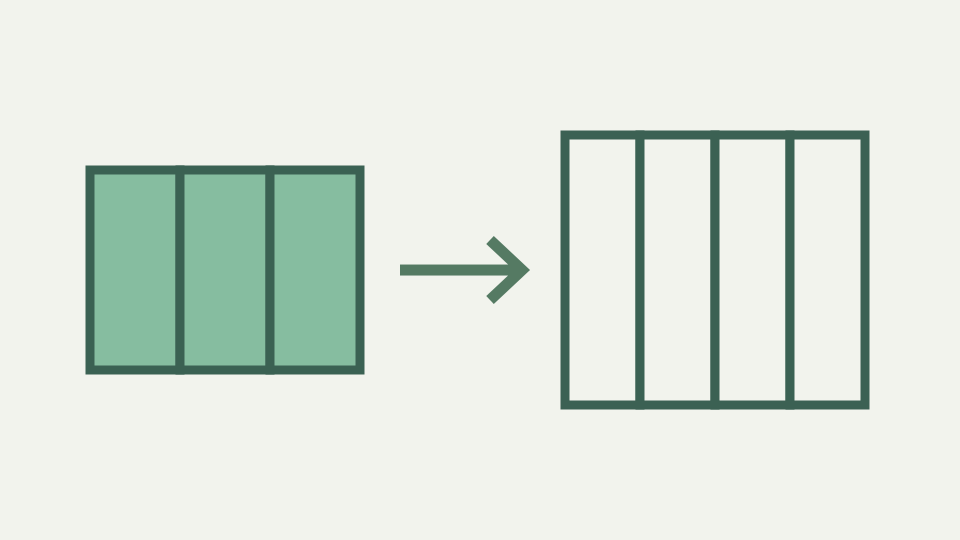
Base64 आउटपुट इसके इनपुट से लगभग एक तिहाई बड़ा है, साथ ही पैडिंग और संभवतः लाइन ब्रेक भी है। यह पोस्ट सटीक सूत्र प्राप्त करती है और इसे यथार्थवादी आकारों पर लागू करती है ताकि आप लागत का आकलन कर सकें।
30 KB आइकन जो बंडल में 40 KB बन गया - एक ठोस आकार की छलांग जिसने निर्माण समीक्षा को आश्चर्यचकित कर दिया
CSS फ़ाइल में Base64 के रूप में रेखांकित 30 KB आइकन 40 KB बन जाता है, और बिल्ड समीक्षा प्रश्न उठता है: अतिरिक्त 10 KB कहां से आया? Base64 के लिए विस्तार कारक हमेशा 4/3: होता है, प्रत्येक तीन बाइट्स इनपुट चार बाइट्स आउटपुट (चार अक्षर) उत्पन्न करता है। 30 KB इनपुट (30,000 bytes) के लिए, 10,000 समूह प्राप्त करने के लिए तीन से विभाजित करें, 40,000 bytes आउटपुट प्राप्त करने के लिए चार से गुणा करें।
गणित नियतिवादी और अपरिहार्य है: Base64 संपीड़न प्रारूप नहीं है। यदि इनलाइनिंग एसेट की लागत 33% अधिक बैंडविड्थ है और पेज तेजी से लोड होता है क्योंकि एक HTTP अनुरोध कम होता है, तो यह मापने लायक व्यापार-बंद है। यदि लागत 33% अधिक है और धीमी गति से लोड होता है, तो इनलाइनिंग उचित नहीं थी। 4/3 अनुपात बिट लेआउट से आता है। तीन बाइट्स 24 bits हैं; चार Base64 वर्णों में 24 bits होते हैं (प्रत्येक में छह बिट होते हैं)।
4/3 फ़्लोर क्यों है - आठ प्रति बाइट के मुकाबले प्रति कैरेक्टर छह बिट, और शेष ओवरहेड कहां से आता है
अब तक, अनुपात 1:1 है। लेकिन Base64 वर्ण टेक्स्ट हैं (ASCII 0–127), और UTF-8 या लैटिन-1 एन्कोडिंग में औसत ASCII वर्ण एक बाइट है। तो चार Base64 वर्ण तीन बाइट्स इनपुट के लिए चार बाइट्स आउटपुट हैं, 4/3. का अनुपात यह सार्वभौमिक नहीं है: यदि Base64 को बाइनरी प्रारूप (प्रति वर्ण एक बाइट, छह बिट्स में पैक) के रूप में आउटपुट किया गया था, तो अनुपात 3/4 (संपीड़न) होगा।
क्योंकि Base64 को टेक्स्ट ट्रांसपोर्ट के लिए डिज़ाइन किया गया है, यह टेक्स्ट वर्णों का उपयोग करता है, और लागत 33% आकार में वृद्धि है। पैडिंग अंत में छोटा मार्जिन जोड़ता है। यदि इनपुट लंबाई तीन से अधिक है, तो पैडिंग की आवश्यकता नहीं है। यदि इनपुट लंबाई 1 मॉड 3 (मल्टीपल में से एक बाइट कम) है, तो दो पैडिंग कैरेक्टर = जोड़े जाते हैं, जिससे आउटपुट 2 बढ़ जाता है। यदि 2 mod 3, तो एक पैडिंग वर्ण = जोड़ा जाता है, 1 द्वारा बढ़ाया जाता है।
पैडिंग के साथ सटीक सूत्र - ceil(n/3) × 4 वर्ण, और 1, 2 और 3 bytes के इनपुट के लिए प्रभाव
बड़े इनपुट के लिए, मार्जिन नगण्य है: 300-बाइट इनपुट के लिए 400 वर्ण और अधिकतम दो पैडिंग वर्ण की आवश्यकता होती है, अंतर 0.5% से कम होता है। छोटे इनपुट (1–3 bytes) के लिए, पैडिंग हावी है: एक बाइट YQ== (चार अक्षर), 4x विस्तार उत्पन्न करता है। लेकिन बड़ी फाइलों पर औसत का प्रभुत्व है। सटीक सूत्र ceil(n / 3) × 4 वर्ण है, जहां n इनपुट बाइट गिनती है।
n = 1 के लिए, ceil(1/3) × 4 = 1 × 4 = 4। n = 2 के लिए, छत(2/3) × 4 = 1 × 4 = 4। n = 3 के लिए, ceil(3/3) × 4 = 1 × 4 = 4। n = 4 के लिए, ceil(4/3) × 4 = 2 × 4 = 8। n = 30000 के लिए, ceil(30000/3) × 4 = 10000 × 4 = 40000। छोटे-इनपुट मामले बताते हैं कि क्यों "लगभग एक तिहाई" हर मान के लिए सटीक नहीं है। एक बाइट अभी भी चार-वर्ण ब्लॉक पर कब्जा करता है, जैसा कि दो बाइट्स करते हैं। अनुपात केवल चार तिहाई तक पहुंचता है क्योंकि कई पूर्ण तीन-बाइट समूह अंतिम गद्देदार ब्लॉक पर हावी होते हैं।
व्यावहारिक उदाहरण: 20-वर्ण UTF-8 स्ट्रिंग को मापना - वर्णों के बजाय बाइट्स की गिनती करना, फिर Base64 लंबाई
अंतिम समूह के लिए सीलिंग फ़ंक्शन तीन का पूर्ण गुणज नहीं है। जैसे-जैसे n बड़ा होता है, ceil(n/3) n/3, के करीब पहुंचता है, इसलिए आउटपुट (n/3) × 4 = 4n/3, 4/3 अनुपात तक पहुंचता है।
कंक्रीट स्ट्रिंग को मापें: 20 वर्ण मिश्रित ASCII, उच्चारण और इमोजी। JavaScript में वर्णों की संख्या 15 है (इमोजी की गिनती एक है)। UTF-8 बाइट गिनती भिन्न होती है: ASCII अक्षर 1 byte प्रत्येक, उच्चारण अक्षर 2 bytes (é के लिए 0xC3 0xA9), इमोजी 4 bytes (0xF0 0x9F 0x98 0x80)। टूल UTF-16 अक्षर, यूनिकोड कोड पॉइंट और UTF-8 बाइट्स अलग से रिपोर्ट करता है। यह अंतर मल्टीबाइट प्रतीकों वाले बीस-अक्षर वाले वाक्य की कीमत बीस बाइट्स होने से रोकता है। एन्कोडेड लंबाई बाइट गिनती का अनुसरण करती है, न कि वह जो मानव स्क्रीन पर गिनता है।
लाइन ब्रेक और MIME रैपिंग - कैसे 76-कॉलम फ़ॉर्मेटिंग कुछ और प्रतिशत जोड़ती है
कुल मिलाकर आसपास 18 bytes. Base64 इन्हें एन्कोड करता है: ceil(18/3) × 4 = 6 × 4 = 24 अक्षर. तब से 18 तीन का गुणज, पैडिंग की आवश्यकता नहीं। Base64 आउटपुट है 24 अक्षर. एन्कोडिंग जोड़ता है 24 - 18 = 6 bytes, या 33%, पुष्टि कर रहा हूँ 4/3 सूत्र. MIME Base64 रैपिंग अतिरिक्त ओवरहेड का परिचय देती है। क्लासिक MIME पर लपेटता है 76 प्रति पंक्ति वर्ण और नई पंक्ति जोड़ता है।
400-वर्ण Base64 आउटपुट नई लाइनें डालने के साथ लगभग 405 bytes हो जाता है। Base64 आउटपुट के प्रत्येक 76 वर्ण के लिए, एक न्यूलाइन बाइट डाला गया। बड़ी फ़ाइलों के लिए, 2% से कम जोड़ता है। ईमेल अनुलग्नकों के लिए, न्यूलाइन कन्वेंशन मानक है और पार्सर्स द्वारा अपेक्षित है; टूल रैप्ड Base64 को स्वीकार करता है और सही ढंग से डीकोड करता है। संपीड़न इंटरैक्शन आकार विश्लेषण को जटिल बनाते हैं। कच्चा बाइनरी डेटा (छवि, वीडियो) Base64 टेक्स्ट की तुलना में अलग तरह से संपीड़ित होता है। ToolAcre प्रत्येक कॉन्फ़िगर किए गए 76-वर्ण स्लाइस के बाद एक नई पंक्ति सम्मिलित करता है और उन नई पंक्तियों को इसके प्रदर्शित एन्कोडेड-वर्ण माप से बाहर कर देता है। एक तार-प्रारूप बजट में विभाजकों को वापस जोड़ना होगा; केवल दृश्यमान माप की तुलना Base64 प्रतीकों का वर्णन करती है, न कि प्रत्येक प्रेषित लाइन-एंडिंग बाइट का।
संपीड़न इंटरैक्शन - क्यों Base64 टेक्स्ट उसके द्वारा दर्शाए गए कच्चे बाइट्स की तुलना में बदतर रूप से संपीड़ित होता है
Base64 स्ट्रिंग gzip के साथ 60% its आकार में संपीड़ित हो सकती है, और छवि 25% तक संपीड़ित हो सकती है। क्योंकि gzip दोहराए गए बाइट पैटर्न की तलाश करता है, पाठ प्रतिनिधित्व (अक्षर A-Z प्लस + / या - _) में बाइनरी डेटा प्रतिनिधित्व की तुलना में कम पुनरावृत्ति होती है। संपीड़न के साथ छवि को इनलाइन करने में अक्सर अलग से एम्बेड करने की तुलना में कोड में अधिक लागत आती है। फ़ॉन्ट के लिए, विशेष रूप से कई ग्लिफ़ के साथ जटिल, Base64 इनलाइनिंग अक्षम हो सकती है।
ट्रेड-ऑफ़ विश्लेषण विशिष्ट संदर्भ पर निर्भर करता है। URI (10–50 bytes) को इनलाइन करना HTTP अनुरोध से बचने के लिए ओवरहेड के लायक हो सकता है। बड़ी संपत्ति (100 KB) को इनलाइन करना संभव नहीं है। संपीड़न स्रोत और उसके Base64 प्रतिनिधित्व दोनों में पैटर्न पर निर्भर करता है, इसलिए एक सार्वभौमिक संपीड़ित-ओवरहेड प्रतिशत बेईमानी होगा। आसपास की प्रतिक्रिया संपीड़न से पहले और बाद में वास्तविक संपत्ति को मापें। निश्चित लागत ब्लॉक सूत्र द्वारा दी गई असम्पीडित वर्ण गणना है।
इसमें क्या शामिल नहीं है - रेंडरिंग या डिकोड प्रदर्शन को मापना, और प्रारूप-विशिष्ट अनुकूलन जैसे WebP
यदि CDN पर संपत्ति उपयोगकर्ता के करीब है, तो अनुरोध से बचने से कोई लाभ नहीं होगा। यदि एक ही सर्वर पर संपत्ति और लोडिंग के लिए अतिरिक्त राउंड ट्रिप की आवश्यकता होती है, तो इनलाइनिंग उचित हो सकती है। मापना आवश्यक है: इनलाइन आकार की गणना करने के लिए सूत्र का उपयोग करें, CSS या HTML फ़ाइल में वर्ण गणना जोड़ें, कुल बंडल आकार और लोड समय मापें।
33% oवरहेड निश्चित है; प्रदर्शन लाभ नहीं है. URL-सुरक्षित Base64 (base64url) में समान 4/3 अनुपात है, बस अलग-अलग वर्ण हैं। पैडिंग हटाने से सबसे खराब स्थिति में दो अक्षर बच जाते हैं। बड़ी फ़ाइलों के लिए, नगण्य. JWT टोकन (तीन Base64url सेगमेंट डॉट्स से जुड़े हुए) के लिए, पैडिंग हटाना पारंपरिक है लेकिन बहुत कम जगह बचाता है; वास्तविक आकार टोकन सामग्री है, ओवरहेड एन्कोडिंग नहीं। रेंडरिंग गति, छवि डिकोडिंग और WebP जैसे वैकल्पिक प्रारूपों के लिए अलग-अलग माप की आवश्यकता होती है। एक छोटी Base64 स्ट्रिंग तेज़ पेंटिंग का संकेत नहीं देती है, और यह केवल-पाठ टूल किसी छवि फ़ाइल को स्वीकार नहीं करता है। इसका विश्वसनीय योगदान पैनल में दर्ज UTF-8 पाठ का अंकगणित है।
टेकअवे: बजट एक तिहाई अतिरिक्त - कैसे Base64 एनकोडर और डिकोडर आपको किसी भी पाठ की वास्तविक एन्कोडेड लंबाई देता है ताकि आप अनुमान लगाने के बजाय माप सकें
संपीड़न भी पाठ को इसी प्रकार एन्कोड करता है; चाहे अंतिम दो अक्षर == हों या स्ट्रिंग छोटी हों, इससे gzip आउटपुट में लगभग कोई अंतर नहीं पड़ता है। Base64 एनकोडर और डिकोडर इनपुट बाइट गिनती और आउटपुट कैरेक्टर गिनती दोनों की तुरंत रिपोर्ट करते हैं। किसी भी टेक्स्ट एन्कोड के लिए, सटीक आकार में वृद्धि देख सकते हैं। मल्टी-बाइट वर्णों के साथ UTF-8 स्ट्रिंग्स के लिए, टूल दिखाता है कि वर्ण गणना (क्या देखें) बाइट गिनती (Base64 एन्कोड क्या है) से भिन्न है।
एक 10-वर्ण स्ट्रिंग 15 bytes हो सकती है यदि इसमें उच्चारण और इमोजी शामिल हैं, जो वर्ण गणना के आधार पर 4/3 अनुपात के बजाय Base64 आउटपुट के 20 वर्ण उत्पन्न करता है। भेद को समझने से स्पष्ट होता है कि इमोजी-भारी आइकन को इनलाइन करना ASCII कला से महंगा क्यों है: इमोजी की कीमत अधिक नहीं है, UTF-8 बाइट्स का वे प्रतिनिधित्व करते हैं। उम्मीदवार इनलाइन मान के लिए, टूल की UTF-8-बाइट गिनती और एन्कोडेड-कैरेक्टर गिनती को एक साथ रिकॉर्ड करें। फिर URI उपसर्ग, CSS सिंटैक्स और गंतव्य के लिए आवश्यक कोई भी रैपिंग शामिल करें। वह संपूर्ण माप फ़्रेमिंग लागत के बिना पूर्णांकित प्रतिशत को दोहराने से अधिक उपयोगी है।