Strumenti per sviluppatori · Codificatore e decodificatore Base64
Quanto più grandi Base64 rende i tuoi dati? Il sovraccarico di 4/3 ha funzionato
· Come funziona
base64 codifica prestazione
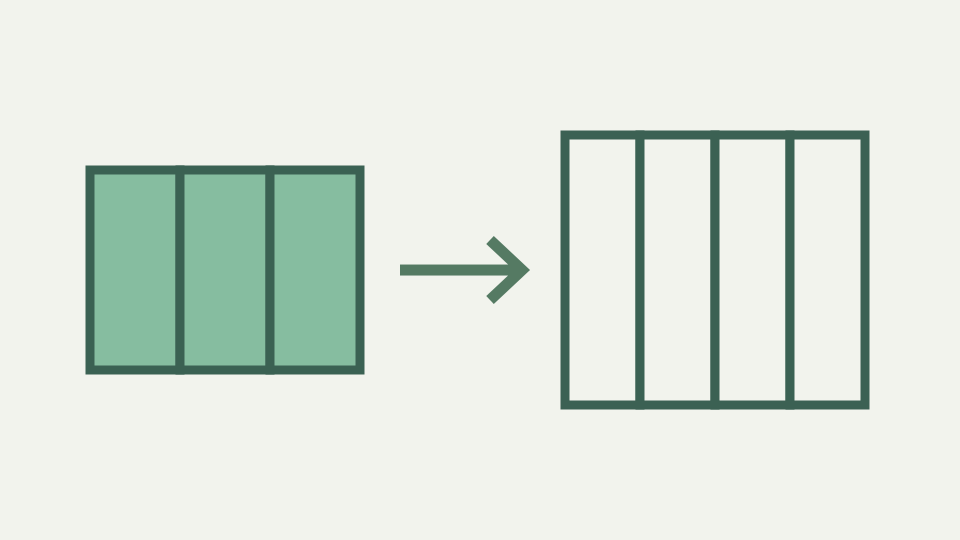
L'output Base64 è circa un terzo più grande del suo input, più il riempimento e possibilmente le interruzioni di riga. Questo post ricava la formula esatta e la applica a dimensioni realistiche in modo da poter giudicare il costo.
L'icona 30 KB che è diventata 40 KB nel pacchetto: un salto di dimensioni concreto che ha sorpreso una revisione della build
Un'icona 30 KB incorporata come Base64 nel file CSS diventa 40 KB e sorge la domanda sulla revisione della build: da dove provengono 10 KB extra? Il fattore di espansione per Base64 è sempre 4/3: ogni tre byte di input producono quattro byte di output (quattro caratteri). Per l'input 30 KB (30,000 bytes), dividere per tre per ottenere i gruppi 10,000, moltiplicare per quattro per ottenere l'output 40,000 bytes.
La matematica è deterministica e inevitabile: Base64 non è un formato di compressione. Se l'incorporamento della risorsa costa il 33% in più di larghezza di banda e la pagina si carica più velocemente a causa di una richiesta di HTTP in meno, si tratta di un compromesso che vale la pena misurare. Se costa il 33% in più e si carica più lentamente, l'inlining non valeva la pena. Il rapporto 4/3 deriva dal layout dei bit. Tre byte sono 24 bits; quattro caratteri Base64 trasportano 24 bits (ciascuno trasporta sei bit).
Perché 4/3 è il punto di partenza: sei bit per carattere contro otto per byte e da dove proviene il restante sovraccarico
Finora, il rapporto è 1:1. Ma i caratteri Base64 sono testo (ASCII 0–127) e il carattere medio ASCII in UTF-8 o la codifica latina-1 è un byte. Quindi quattro caratteri Base64 sono quattro byte di output per tre byte di input, rapporto di 4/3. Questo non è universale: se Base64 fosse emesso in formato binario (un byte per carattere, compresso in sei bit), il rapporto sarebbe 3/4 (compressione).
Poiché Base64 è progettato per il trasporto di testo, utilizza caratteri di testo e il costo è di un aumento delle dimensioni del 33%. L'imbottitura aggiunge un piccolo margine alla fine. Se la lunghezza dell'input è multipla di tre, non è necessario il riempimento. Se la lunghezza dell'input 1 mod 3 (un byte in meno rispetto al multiplo), due caratteri di riempimento = aggiunti, aumentando l'output di 2. Se 2 mod 3, un carattere di riempimento = aggiunto, aumentando di 1.
La formula esatta con riempimento: ceil(n/3) × 4 caratteri e l'effetto per gli input di 1, 2 e 3 bytes
Per input di grandi dimensioni, il margine è trascurabile: l'input 300-byte richiede caratteri 400 più al massimo due caratteri di riempimento, differenza inferiore a 0.5%. Per input di piccole dimensioni (1–3 bytes), prevale il riempimento: un byte produce YQ== (quattro caratteri), espansione 4x. Ma la media tra i file è dominata da quelli di grandi dimensioni. La formula esatta è ceil(n / 3) × 4 caratteri, dove n è il conteggio dei byte di input.
Per n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Per n = 2, ceil(2/3) × 4 = 1 × 4 = 4. For n = 3, ceil(3/3) × 4 = 1 × 4 = 4 Per n = 4, ceil(4/3) × 4 = 2 × 4 = 8. Per n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. I casi con input piccoli spiegano perché "circa un terzo" non è esatto per ogni valore. Un byte occupa ancora un blocco di quattro caratteri, così come due byte. Il rapporto si avvicina ai quattro terzi solo se molti gruppi completi di tre byte dominano il blocco riempito finale.
Esempio realizzato: misurazione di una stringa 20 di caratteri UTF-8: conteggio dei byte anziché dei caratteri, quindi la lunghezza Base64
La funzione del soffitto spiega che il gruppo finale non è un multiplo completo di tre. Man mano che n aumenta, ceil(n/3) si avvicina a n/3, quindi l'output si avvicina a (n/3) × 4 = 4n/3, al rapporto 4/3.
Misura la stringa di cemento: 20 caratteri misti ASCII, accenti ed emoji. Il conteggio dei caratteri è 15 in JavaScript (le emoji contano uno). Il conteggio dei byte di UTF-8 è diverso: ASCII lettere 1 byte ciascuna, lettera accentata 2 bytes (0xC3 0xA9 per é), emoji 4 bytes (0xF0 0x9F 0x98 0x80). Lo strumento riporta separatamente i caratteri UTF-16, i punti di codice Unicode e i UTF-8 byte. Questa distinzione impedisce che una frase di venti caratteri contenente simboli multibyte venga prezzata come venti byte. La lunghezza codificata segue il conteggio dei byte, non ciò che un essere umano conta sullo schermo.
Interruzioni di riga e ritorno a capo MIME: come la formattazione delle colonne 76 aggiunge un'ulteriore percentuale
Totale intorno 18 bytes. Base64 codifica questi: ceil(18/3) × 4 = 6 × 4 = 24 caratteri. Da 18 multiplo di tre, non è necessaria alcuna imbottitura. L'output Base64 è 24 caratteri. La codifica aggiunge 24 - 18 = 6 bytes, O 33%, confermando 4/3 formula. MIME Il rivestimento Base64 introduce un sovraccarico aggiuntivo. Classico MIME avvolge a 76 caratteri per riga e aggiunge una nuova riga.
Un output Base64 di 400 caratteri diventa circa 405 bytes con i ritorni a capo inseriti. Per ogni 76 caratteri dell'output Base64, viene inserito un byte di nuova riga. Per file di grandi dimensioni, aggiunge meno di 2%. Per gli allegati di posta elettronica, la convenzione di fine riga è standard e prevista dai parser; lo strumento accetta Base64 avvolto e decodifica correttamente. Le interazioni di compressione complicano l'analisi delle dimensioni. I dati binari grezzi (immagini, video) vengono compressi in modo diverso rispetto al testo Base64. ToolAcre inserisce un ritorno a capo dopo ogni porzione di carattere 76 configurata ed esclude tali ritorni dalla misurazione dei caratteri codificati visualizzati. Un budget in formato wire deve aggiungere nuovamente i separatori; un confronto della sola misurazione visibile descrive i simboli Base64, non tutti i byte di fine linea trasmessi.
Interazioni di compressione: perché il testo Base64 tende a comprimersi peggio dei byte grezzi che rappresenta
La stringa Base64 potrebbe comprimersi al 60% delle sue dimensioni con gzip e l'immagine potrebbe comprimersi al 25%. Poiché gzip cerca modelli di byte ripetuti, la rappresentazione del testo (lettere A–Z più + / o - _) ha meno ripetizioni rispetto a quelle rappresentate dai dati binari. L'incorporamento dell'immagine con compressione spesso costa di più nel codice rispetto all'incorporamento separato. Per i caratteri particolarmente complessi con molti glifi, l'incorporamento Base64 può essere inefficiente.
L’analisi del trade-off dipende dal contesto specifico. L'incorporamento di piccoli dati URI (10–50 bytes) potrebbe valere un sovraccarico per evitare la richiesta HTTP. L'integrazione di risorse di grandi dimensioni (100 KB) potrebbe non essere possibile. La compressione dipende dai modelli sia nell'origine che nella sua rappresentazione Base64, quindi una percentuale universale di sovraccarico compresso sarebbe disonesta. Misura la risorsa reale prima e dopo la compressione della risposta circostante. Il costo certo è il conteggio dei caratteri non compressi fornito dalla formula del blocco.
Cosa non copre: misurazione delle prestazioni di rendering o decodifica e ottimizzazioni specifiche del formato come WebP
Se la risorsa su CDN è vicina all'utente, evitando la richiesta non si ottiene alcun vantaggio. Se la risorsa sullo stesso server e il caricamento richiedono un viaggio di andata e ritorno aggiuntivo, l'incorporamento potrebbe essere giustificato. La misurazione è essenziale: utilizza la formula per calcolare la dimensione in linea, aggiungi il conteggio dei caratteri al file CSS o HTML, misura la dimensione totale del pacchetto e il tempo di caricamento.
Il 33% di sovraccarico è certo; il vantaggio in termini di prestazioni non lo è. URL-safe Base64 (base64url) ha lo stesso rapporto 4/3, solo caratteri diversi. La rimozione del riempimento salva due caratteri nel peggiore dei casi. Per file di grandi dimensioni, trascurabile. Per i token JWT (tre segmenti base64url uniti da punti), la rimozione del riempimento è convenzionale ma consente di risparmiare pochissimo spazio; la dimensione reale è il contenuto del token, non il sovraccarico di codifica. La velocità di rendering, la decodifica delle immagini e formati alternativi come WebP richiedono misurazioni diverse. Una stringa Base64 più corta non implica una pittura più veloce e questo strumento di solo testo non accetta un file immagine. Il suo contributo affidabile è l'aritmetica del testo UTF-8 inserito nel pannello.
Conclusione: budget un terzo in più: come il codificatore e decodificatore Base64 ti fornisce la reale lunghezza codificata di qualsiasi testo in modo da poter misurare anziché indovinare
Anche la compressione codifica il testo in modo simile; se gli ultimi due caratteri sono == o una stringa più corta non fa quasi alcuna differenza nell'output di gzip. Il codificatore e decodificatore Base64 riporta immediatamente sia il conteggio dei byte di input che il conteggio dei caratteri di output. Per qualsiasi codifica di testo, puoi vedere l'aumento della dimensione esatta. Per le stringhe UTF-8 con caratteri multibyte, lo strumento mostra che il conteggio dei caratteri (cosa vedere) differisce dal conteggio dei byte (cosa codifica Base64).
Una stringa di caratteri 10 potrebbe essere 15 bytes se contiene accenti ed emoji, producendo 20 caratteri di output Base64 invece del rapporto 4/3 in base al conteggio dei caratteri. Comprendere la distinzione chiarisce perché incorporare un'icona ricca di emoji è più costoso dell'arte ASCII: non le emoji costano di più, i UTF-8 byte che rappresentano. Per un valore in linea candidato, registra il conteggio dei UTF-8 byte dello strumento e il conteggio dei caratteri codificati uno accanto all'altro. Quindi includi il prefisso URI, la sintassi CSS e qualsiasi avvolgimento richiesto dalla destinazione. Questa misurazione completa è più utile che ripetere una percentuale arrotondata senza i relativi costi di inquadramento.