开发者工具 · Base64 编码器和解码器
Base64 使您的数据增大了多少? 4/3 开销已解决
· 工作原理
base64 编码 性能
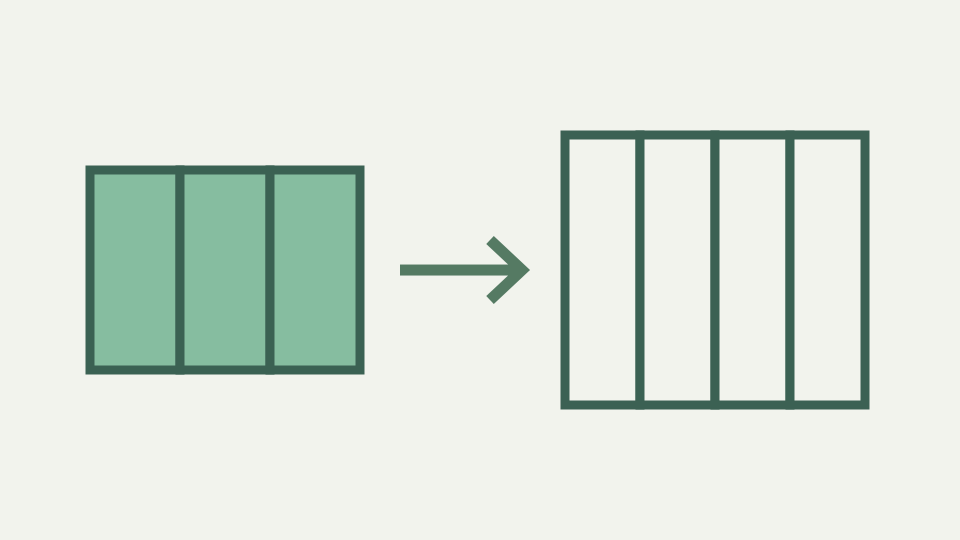
Base64 输出大约比其输入大三分之一,加上填充和可能的换行符。这篇文章得出了精确的公式并将其应用于实际尺寸,以便您可以判断成本。
30 KB 图标在捆绑包中变成了 40 KB — 具体的尺寸跳跃令构建审核感到惊讶
CSS 文件中作为 Base64 内联的 30 KB 图标变为 40 KB,并且出现构建审核问题:额外的 10 KB 从哪里来? Base64 的扩展因子始终为 4/3: 每三个字节输入产生四个字节输出(四个字符)。对于 30 KB 输入(30,000 字节),除以三以获得 10,000 组,乘以四以获得 40,000 字节输出。
数学是确定性且不可避免的:Base64 不是压缩格式。如果内联资产由于减少了一个 HTTP 请求而花费了 33% 的带宽并且页面加载速度更快,那么这是值得衡量的权衡。如果成本增加 33% 并且加载速度较慢,则内联就不值得。 4/3 比率来自位布局。三个字节是 24 位;四个 Base64 字符携带 24 位(每个字符携带六位)。
为什么 4/3 是下限 — 每个字符六位而不是每个字节八位,以及剩余开销来自哪里
到目前为止,比率为 1:1。但 Base64 字符是文本(ASCII 0–127),而 UTF-8 或 Latin-1 编码中的平均 ASCII 字符是一个字节。因此,四个 Base64 字符对于三个字节输入来说是四个字节输出,比率为 4/3. 这不是通用的:如果 Base64 以二进制格式输出(每个字符一个字节,打包为六位),则比率将为 3/4 (压缩)。
由于 Base64 是为文本传输而设计的,因此它使用文本字符,并且成本是 33% 大小增加。填充在末尾添加了小边距。如果输入长度是三的倍数,则不需要填充。如果输入长度 1 mod 3 (一个字节少于多个),则添加两个填充字符,将输出增加 2。如果 2 mod 3,则添加一个填充字符,并增加 1。
带填充的精确公式 — ceil(n/3) × 4 个字符,以及 1、2 和 3 字节输入的效果
对于大输入,边距可以忽略不计:300 字节输入需要 400 字符加上最多两个填充字符,差异小于 0.5%。对于微小输入(1–3 字节),填充占主导地位:一个字节产生 YQ==(四个字符),4 倍扩展。但跨文件的平均值主要是大文件。确切的公式为 ceil(n / 3) × 4 个字符,其中 n 是输入字节数。
对于 n = 1,ceil(1/3) × 4 = 1 × 4 = 4。对于 n = 2, ceil(2/3) × 4 = 1 × 4 = 4。对于 n = 3,ceil(3/3) × 4 = 1 × 4 = 4。对于 n = 4,ceil(4/3) × 4 = 2 × 4 = 8。对于 n = 30000,ceil(30000/3) × 4 = 10000 × 4 = 40000。小输入情况解释为什么“大约三分之一”对于每个值来说并不准确。一个字节仍然占据一个四字符块,就像两个字节一样,该比例仅接近三分之四,因为许多完整的三字节组占据了最终的填充块。
工作示例:测量 20 字符 UTF-8 字符串 — 计算字节而不是字符,然后计算 Base64 长度
上限函数说明最终组不是三的完整倍数。随着 n 变大,ceil(n/3) 接近 n/3,,因此输出接近 (n/3) × 4 = 4n/3, 4/3 比率。
测量具体字符串:20 字符混合 ASCII、重音符号和表情符号。 JavaScript 中的字符数为 15(表情符号计为 1)。 UTF-8 字节数不同:ASCII 字母 1 字节,重音字母 2 字节(0xC3 0xA9 表示 é),表情符号 4 字节(0xF0 0x9F 0x98 0x80)。该工具分别报告 UTF-16 字符、Unicode 代码点和 UTF-8 字节。这种区别防止包含多字节符号的二十字符句子被定价为二十字节。编码长度遵循字节数,而不是人类在屏幕上计算的长度。
换行符和 MIME 换行 — 76 列格式如何进一步增加百分之几
总计约 18 字节。 Base64 编码这些: ceil(18/3) × 4 = 6 × 4 = 24 个字符。由于 18 是三的倍数,因此不需要填充。Base64 输出是 24 个字符。编码添加24 - 18 = 6 字节,或 33%,确认 4/3 公式。MIME Base64 换行会带来额外的开销,每行 76 个字符。
400 字符 Base64 输出在插入换行符后变为大约 405 字节。对于 Base64 输出的每 76 字符,插入一个换行符字节。对于大文件,添加少于 2%。对于电子邮件附件,换行约定是标准的,也是解析器所期望的;工具接受包装的 Base64 并正确解码。压缩相互作用使尺寸分析变得复杂。原始二进制数据(图像、视频)的压缩方式与 Base64 文本不同。 ToolAcre 在每个配置的 76 字符切片后插入换行符,并从其显示的编码字符测量中排除这些换行符。有线格式预算必须添加分隔符;可见测量的比较仅描述了 Base64 符号,而不是每个传输的行结束字节。
压缩交互 - 为什么 Base64 文本的压缩效果往往比它所表示的原始字节差
使用 gzip,Base64 字符串可能会压缩到其大小的 60%,图像可能会压缩到 25%。由于 gzip 寻找重复的字节模式,因此文本表示(字母 A–Z 加 + / 或 - _)的重复次数比二进制数据表示的重复次数要少。通过压缩内联图像通常比单独嵌入要花费更多的代码成本。对于字体,特别是具有许多字形的复杂字体,Base64 内联可能效率低下。
权衡分析取决于具体情况。内联小数据 URI(10–50 字节)可能值得开销以避免 HTTP 请求。内联大型资源 (100 KB) 可能不会。压缩取决于源及其 Base64 表示形式中的模式,因此通用的压缩开销百分比是不诚实的。测量周围响应压缩之前和之后的实际资产。一定的成本是块公式给出的未压缩字符数。
这不包括测量渲染或解码性能,以及特定于格式的优化,例如 WebP
如果 CDN 上的资产靠近用户,避免请求不会带来好处。如果同一服务器上的资产和加载需要额外的往返,则内联可能是合理的。测量至关重要:使用公式计算内联大小、向 CSS 或 HTML 文件添加字符数、测量总包大小和加载时间。
33% 开销是确定的;性能优势则不然。 URL-安全 Base64 (base64url) 具有相同的 4/3 比率,只是字符不同。在最坏的情况下,删除填充可以节省两个字符。对于大文件,可以忽略不计。对于 JWT 令牌(三个 base64url 段连接点),删除填充是常规做法,但节省的空间很少;实际大小是令牌内容,而不是编码开销。渲染速度、图像解码和替代格式(例如 WebP)需要不同的测量。较短的 Base64 字符串并不意味着绘制速度更快,并且此纯文本工具不接受图像文件。它的可靠贡献是对面板中输入的 UTF-8 文本进行算术。
要点:额外预算三分之一 — Base64 编码器和解码器如何为您提供任何文本的真实编码长度,以便您可以测量而不是猜测
压缩也类似地对文本进行编码;无论最后两个字符是 == 还是字符串较短,在 gzip 输出中几乎没有区别。 Base64 编码器和解码器立即报告输入字节数和输出字符数。对于任何文本编码,都可以看到确切的大小增加。对于具有多字节字符的 UTF-8 字符串,工具显示字符计数(看到的内容)与字节计数(Base64 编码的内容)不同。
如果包含重音符号和表情符号,则 10 字符串可能是 15 字节,从而生成 Base64 输出的 20 字符,而不是基于字符计数的 4/3 比率。理解区别可以阐明为什么内联表情符号重的图标比 ASCII 艺术更昂贵:不是表情符号花费更多,而是它们代表 UTF-8 字节。对于候选内联值,并排记录工具的 UTF-8 字节计数和编码字符计数。然后包括 URI 前缀、CSS 语法和目标所需的任何包装。这种完整的测量比重复没有框架成本的四舍五入百分比更有用。