Ferramentas de desenvolvedor · Codificador e decodificador Base64
Quanto maior o Base64 torna seus dados? A sobrecarga 4/3 funcionou
· Como funciona
base64 codificação desempenho
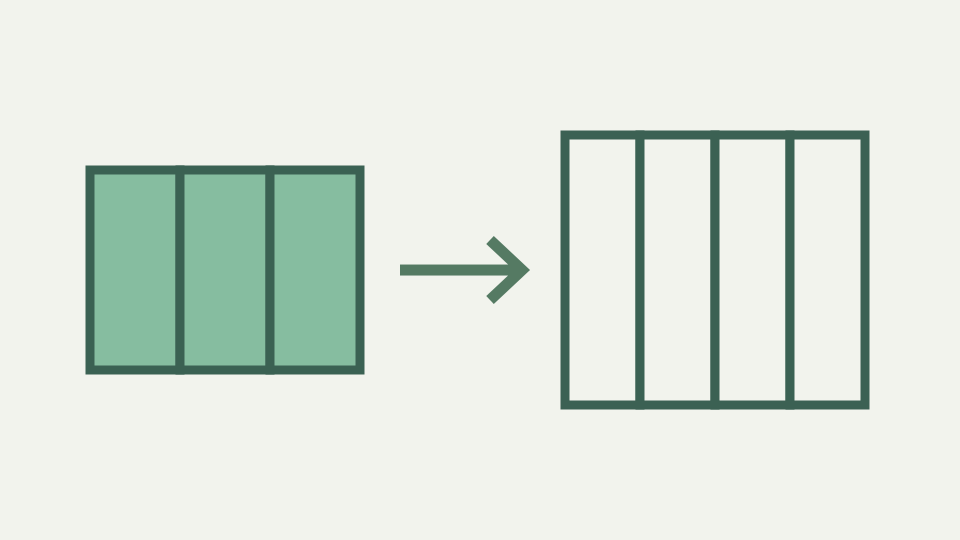
A saída Base64 é cerca de um terço maior que sua entrada, além de preenchimento e possivelmente quebras de linha. Esta postagem deriva a fórmula exata e a aplica a tamanhos realistas para que você possa avaliar o custo.
O ícone 30 KB que se tornou 40 KB no pacote — um salto de tamanho concreto que surpreendeu uma revisão de construção
Um ícone 30 KB embutido como Base64 no arquivo CSS se torna 40 KB, e surge a pergunta de revisão de construção: de onde veio o 10 KB extra? O fator de expansão para Base64 é sempre 4/3: cada três bytes de entrada produz quatro bytes de saída (quatro caracteres). Para entrada 30 KB (30,000 bytes), divida por três para obter grupos 10,000, multiplique por quatro para obter a saída 40,000 bytes.
A matemática é determinística e inevitável: Base64 não é um formato de compactação. Se o recurso embutido custa 33% mais largura de banda e a página carrega mais rápido porque há uma solicitação HTTP a menos, essa é uma compensação que vale a pena medir. Se custasse 33% mais e carregasse mais lentamente, o inlining não valeria a pena. A proporção 4/3 vem do layout de bits. Três bytes são 24 bits; quatro caracteres Base64 carregam 24 bits (cada um carrega seis bits).
Por que 4/3 é o mínimo - seis bits por caractere contra oito por byte e de onde vem a sobrecarga restante
Até agora, a proporção é 1:1. Mas os caracteres Base64 são texto (ASCII 0–127) e o caractere ASCII médio na codificação UTF-8 ou Latin-1 é de um byte. Portanto, quatro caracteres Base64 são saída de quatro bytes para entrada de três bytes, proporção de 4/3. Isso não é universal: se Base64 fosse gerado em formato binário (um byte por caractere, compactado em seis bits), a proporção seria 3/4 (compressão).
Como o Base64 foi projetado para transporte de texto, ele usa caracteres de texto e o custo é de 33% de aumento de tamanho. O preenchimento adiciona uma pequena margem no final. Se o comprimento da entrada for múltiplo de três, não será necessário preenchimento. Se o comprimento da entrada 1 mod 3 (um byte a menos do múltiplo), dois caracteres de preenchimento = adicionados, aumentando a saída em 2. Se 2 mod 3, um caractere de preenchimento = adicionado, aumentando em 1.
A fórmula exata com preenchimento — ceil(n/3) × 4 caracteres e o efeito para entradas de 1, 2 e 3 bytes
Para entradas grandes, a margem é insignificante: a entrada de 300 bytes precisa de 400 caracteres mais no máximo dois caracteres de preenchimento, diferença inferior a 0.5%. Para entradas minúsculas (1–3 bytes), o preenchimento domina: um byte produz YQ== (quatro caracteres), expansão de 4x. Mas a média dos arquivos é dominada pelos grandes. A fórmula exata é ceil(n / 3) × 4 caracteres, onde n é a contagem de bytes de entrada.
Para n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Para n = 2, ceil(2/3) × 4 = 1 × 4 = 4 Para n = 3, ceil(3/3) × 4 = 1 ×. 4 = 4 Para n = 4, ceil(4/3) × 4 = 2 × 4 = 8. Para n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Os casos de entrada pequena explicam por que “cerca de um terço” não é exato para cada valor. Um byte ainda ocupa um bloco de quatro caracteres, como faça dois bytes A proporção se aproxima de quatro terços apenas quando muitos grupos completos de três bytes dominam o bloco preenchido final.
Exemplo resolvido: medindo uma string de 20 caracteres UTF-8 - contando bytes em vez de caracteres e, em seguida, o comprimento Base64
A função teto leva em conta que o grupo final não é um múltiplo completo de três. À medida que n cresce, ceil(n/3) se aproxima de n/3,, então a saída se aproxima (n/3) × 4 = 4n/3, da proporção 4/3.
Meça a string concreta: 20 caracteres misturados ASCII, acentos e emoji. A contagem de caracteres é 15 em JavaScript (o emoji conta um). A contagem de bytes de UTF-8 difere: ASCII letras 1 byte cada, letra acentuada 2 bytes (0xC3 0xA9 para é), emoji 4 bytes (0xF0 0x9F 0x98 0x80). A ferramenta relata UTF-16 caracteres, pontos de código Unicode e UTF-8 bytes separadamente. Essa distinção evita que uma frase de vinte caracteres contendo símbolos multibyte seja avaliada como vinte bytes. O comprimento codificado segue a contagem de bytes, não o que um ser humano conta na tela.
Quebras de linha e quebra automática de MIME — como a formatação da coluna 76 adiciona mais alguns por cento
Total em torno de 18 bytes. Base64 codifica estes: ceil(18/3) × 4 = 6 × 4 = 24 caracteres. Como 18 é múltiplo de três, não é necessário preenchimento. A saída Base64 tem 24 caracteres. A codificação adiciona 24 - 18 = 6 bytes, ou 33%, confirmando a fórmula 4/3 em MIME O empacotamento Base64 introduz sobrecarga adicional em MIME. 76 caracteres por linha e adiciona nova linha.
Uma saída Base64 de 400 caracteres torna-se aproximadamente 405 bytes com novas linhas inseridas. Para cada 76 caracteres de saída Base64, um byte de nova linha inserido. Para arquivos grandes, adiciona menos de 2%. Para anexos de email, a convenção de nova linha é padrão e esperada pelos analisadores; A ferramenta aceita Base64 empacotado e decodifica corretamente. As interações de compressão complicam a análise de tamanho. Os dados binários brutos (imagem, vídeo) são compactados de maneira diferente do texto Base64. ToolAcre insere uma nova linha após cada fatia de 76 caracteres configurada e exclui essas novas linhas de sua medição de caracteres codificados exibida. Um orçamento em formato de fio deve adicionar os separadores de volta; uma comparação apenas da medição visível descreve os símbolos Base64, não todos os bytes de final de linha transmitidos.
Interações de compactação – por que o texto Base64 tende a ser compactado pior do que os bytes brutos que representa
A string Base64 pode compactar para 60% seu tamanho com gzip, e a imagem pode compactar para 25%. Como o gzip procura padrões de bytes repetidos, a representação de texto (letras A – Z mais +/ou - _) tem menos repetição do que os dados binários representam. Incorporar imagem com compactação geralmente custa mais em código do que incorporar separadamente. Para fontes particularmente complexas com muitos glifos, o inlining Base64 pode ser ineficiente.
A análise de trade-off depende do contexto específico. A inserção de pequenos dados URI (10–50 bytes) pode valer a pena para evitar a solicitação HTTP. A incorporação de grandes ativos (100 KB) talvez não. A compactação depende de padrões tanto na fonte quanto em sua representação Base64, portanto, uma porcentagem universal de sobrecarga compactada seria desonesta. Meça o ativo real antes e depois da compressão da resposta circundante. O custo certo é a contagem de caracteres não compactados fornecida pela fórmula do bloco.
O que isso não cobre: medição do desempenho de renderização ou decodificação e otimizações específicas de formato, como WebP
Se o ativo em CDN estiver próximo do usuário, evitar solicitação não será beneficiado. Se o ativo no mesmo servidor e carregamento exigir ida e volta extra, o inlining pode ser justificado. A medição é essencial: use a fórmula para calcular o tamanho in-line, adicione a contagem de caracteres ao arquivo CSS ou HTML, meça o tamanho total do pacote e o tempo de carregamento.
33% de sobrecarga é certa; o benefício de desempenho não é. URL-safe Base64 (base64url) tem a mesma proporção 4/3, apenas caracteres diferentes. A remoção do preenchimento salva dois caracteres na pior das hipóteses. Para arquivos grandes, insignificante. Para tokens JWT (três segmentos base64url unidos por pontos), a remoção do preenchimento é convencional, mas economiza muito pouco espaço; o tamanho real é o conteúdo do token, não a sobrecarga de codificação. Velocidade de renderização, decodificação de imagens e formatos alternativos como WebP exigem medidas diferentes. Uma string Base64 mais curta não implica pintura mais rápida e esta ferramenta somente texto não aceita um arquivo de imagem. Sua contribuição confiável é a aritmética do texto UTF-8 inserido no painel.
Conclusão: reserve um terço a mais - como o codificador e decodificador Base64 fornece o comprimento codificado real de qualquer texto para que você possa medir em vez de adivinhar
A compactação também codifica texto de forma semelhante; se os dois últimos caracteres são == ou uma string mais curta, quase não faz diferença na saída do gzip. O codificador e decodificador Base64 relata a contagem de bytes de entrada e a contagem de caracteres de saída imediatamente. Para qualquer codificação de texto, é possível ver o aumento exato do tamanho. Para strings UTF-8 com caracteres multibyte, a ferramenta mostra que a contagem de caracteres (o que vemos) difere da contagem de bytes (o que o Base64 codifica).
Uma string de 10 caracteres pode ser 15 bytes se contiver acentos e emojis, produzindo 20 caracteres de saída Base64 em vez da proporção 4/3 com base na contagem de caracteres. Compreender a distinção esclarece por que incorporar ícones com muitos emojis é mais caro do que arte ASCII: não emoji custa mais, UTF-8 bytes eles representam. Para um valor in-line candidato, registre a contagem de UTF-8 bytes e a contagem de caracteres codificados da ferramenta lado a lado. Em seguida, inclua o prefixo URI, a sintaxe CSS e qualquer empacotamento exigido pelo destino. Essa medição completa é mais útil do que repetir uma percentagem arredondada sem os seus custos de enquadramento.