Инструменты разработчика · Кодер и декодер Base64
Насколько больше Base64 делает ваши данные? Накладные расходы 4/3 решены
· Как это работает
base64 кодирование производительность
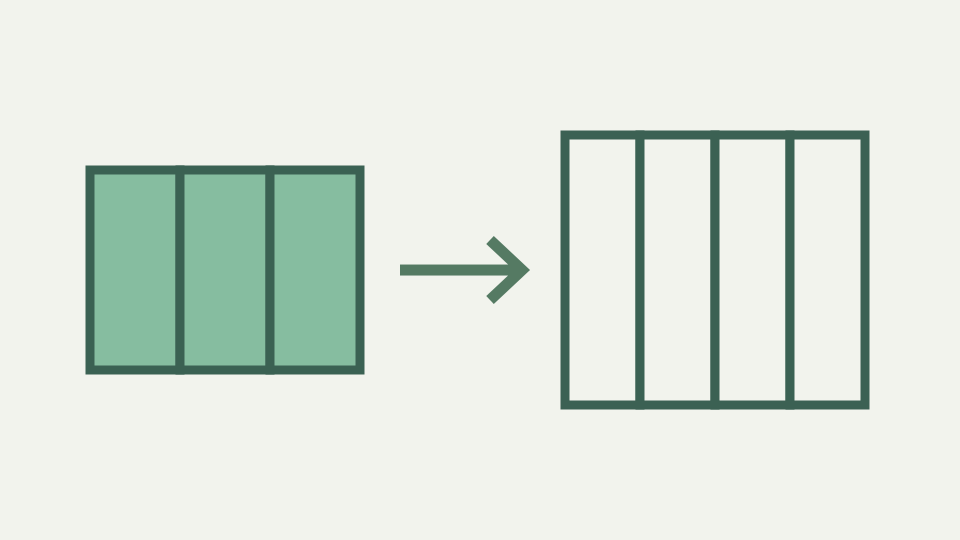
Выходные данные Base64 примерно на треть больше входных, плюс заполнение и, возможно, разрывы строк. В этом посте выведена точная формула и применена ее к реальным размерам, чтобы вы могли оценить стоимость.
Значок 30 KB, который в комплекте стал 40 KB — конкретный скачок в размерах, удививший обзор сборки
Значок 30 KB, встроенный в Base64 в файл CSS, становится 40 KB, и возникает вопрос проверки сборки: откуда взялся дополнительный 10 KB? Коэффициент расширения для Base64 всегда равен 4/3: каждые три байта ввода производят четыре байта вывода (четыре символа). Для входа 30 KB (30,000 bytes) разделите на три, чтобы получить группы 10,000, умножьте на четыре, чтобы получить выход 40,000 bytes.
Математика детерминирована и неизбежна: Base64 не является форматом сжатия. Если встраивание ресурса требует на 33% большей пропускной способности, а страница загружается быстрее, поскольку на один запрос HTTP меньше, этот компромисс стоит измерить. Если стоит на 33% больше и загружается медленнее, встраивание нецелесообразно. Соотношение 4/3 определяется расположением битов. Три байта — это 24 bits; четыре символа Base64 содержат 24 bits (каждый содержит шесть бит).
Почему 4/3 — это нижний предел — шесть бит на символ вместо восьми на байт, и откуда берутся оставшиеся накладные расходы
На данный момент соотношение составляет 1:1. Но символы Base64 представляют собой текст (ASCII 0–127), а средний символ ASCII в кодировке UTF-8 или Latin-1 составляет один байт. Таким образом, четыре символа Base64 представляют собой четыре выходных байта для трех входных байтов, соотношение 4/3.. Это не универсально: если бы Base64 выводился в двоичном формате (один байт на символ, упакованный в шесть бит), соотношение было бы 3/4 (сжатие).
Поскольку Base64 предназначен для передачи текста, он использует текстовые символы, а стоимость увеличивается на 33%. Отступ добавляет небольшой запас в конце. Если длина ввода кратна трем, заполнение не требуется. Если входная длина 1 mod 3 (на один байт меньше нескольких), добавляются два символа заполнения =, увеличивая вывод на 2. Если 2 мод 3, добавляется один символ заполнения =, увеличивающийся на 1.
Точная формула с дополнением — ceil(n/3) × 4 символов и эффект для входных данных 1, 2 и 3 bytes
Для больших входных данных запас незначителен: для ввода 300 байт требуется 400 символов плюс не более двух символов заполнения, разница менее 0.5%. Для крошечных входных данных (1–3 bytes) доминирует заполнение: один байт дает YQ== (четыре символа), 4-кратное расширение. Но в среднем по файлам преобладают большие. Точная формула: ceil(n / 3) × 4 символов, где n — количество входных байтов.
Для n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Для n = 2, ceil(2/3) × 4 = 1 × 4 = 4. Для n = 3, ceil(3/3) × 4 = 1 × 4 = 4. Для n = 4, ceil(4/3) × 4 = 2 × 4 = 8. Для n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Случаи с малым вводом объясняют, почему «около одной трети» не является точным для каждого значения. Один байт по-прежнему занимает блок из четырех символов, как и два Соотношение приближается к четырем третям только тогда, когда в последнем дополненном блоке доминирует множество полных трехбайтовых групп.
Рабочий пример: измерение строки 20 символов UTF-8 — подсчет байтов, а не символов, а затем длины Base64.
Функция потолка учитывает неполноту последней группы, кратной трем. По мере увеличения n ceil(n/3) приближается к n/3,, поэтому выходные данные приближаются к (n/3) × 4 = 4n/3, отношению 4/3.
Измерьте конкретную строку: 20 символов, смешанных ASCII, акцентов и эмодзи. Количество символов — 15 в JavaScript (эмодзи считается один). Количество байт UTF-8 различается: ASCII букв 1 byte каждая, буква с акцентом 2 bytes (0xC3 0xA9 для é), эмодзи 4 bytes (0xF0 0x9F 0x98 0x80). Инструмент сообщает символы UTF-16, кодовые точки Юникода и UTF-8 байты отдельно. Это различие не позволяет двадцатизначному предложению, содержащему многобайтовые символы, оцениваться как двадцать байтов. Закодированная длина соответствует количеству байтов, а не тому, что человек считает на экране.
Разрывы строк и перенос MIME — как форматирование столбца 76 добавляет еще несколько процентов
Всего около 18 bytes. Base64 кодирует их: ceil(18/3) × 4 = 6 × 4 = 24 символов. Поскольку 18 кратно трем, заполнение не требуется. Вывод Base64 имеет вид 24 символов добавляется 24 - 18 = 6 bytes или 33%, что подтверждает формулу 4/3 MIME Base64. Классический MIME переносит 76 символов на строку и добавляет новую строку.
Выходные данные Base64 длиной 400 становятся примерно 405 bytes со вставленными символами новой строки. Для каждых 76 символов вывода Base64 вставляется один байт новой строки. Для больших файлов добавляется менее 2%. Для вложений электронной почты соглашение о новой строке является стандартным и ожидается синтаксическими анализаторами; инструмент принимает завернутый Base64 и правильно декодирует. Взаимодействия сжатия усложняют анализ размеров. Необработанные двоичные данные (изображения, видео) сжимаются иначе, чем текст Base64. ToolAcre вставляет новую строку после каждого настроенного фрагмента из 76 символов и исключает эти новые строки из отображаемого измерения закодированных символов. Бюджет проводного формата должен вернуть разделители; сравнение только видимых измерений описывает символы Base64, а не каждый переданный байт конца строки.
Взаимодействие сжатия — почему текст Base64 имеет тенденцию сжиматься хуже, чем необработанные байты, которые он представляет
Строка Base64 может сжиматься до 60% своего размера с помощью gzip, а изображение может сжиматься до 25%. Поскольку gzip ищет повторяющиеся шаблоны байтов, текстовое представление (буквы A–Z плюс +/или – _) имеет меньше повторений, чем представление двоичных данных. Встраивание изображения со сжатием часто обходится в коде дороже, чем встраивание отдельно. Для шрифтов, особенно сложных с множеством глифов, встраивание Base64 может быть неэффективным.
Анализ компромиссов зависит от конкретного контекста. Встраивание небольших данных URI (10–50 bytes) может оказаться оправданным, чтобы избежать запроса HTTP. Встраивание большого ресурса (100 KB) может и не произойти. Сжатие зависит от шаблонов как в источнике, так и в его представлении Base64, поэтому универсальный процент затрат на сжатие был бы нечестным. Измерьте реальный ресурс до и после сжатия окружающего ответа. Определенная стоимость — это количество несжатых символов, определяемое формулой блока.
Что сюда не входит — измерение производительности рендеринга или декодирования, а также оптимизация для конкретного формата, например WebP.
Если актив на CDN находится рядом с пользователем, избегание запроса не принесет пользы. Если ресурс находится на том же сервере и загрузка требует дополнительного обхода, встраивание может быть оправдано. Измерение имеет важное значение: используйте формулу для вычисления встроенного размера, добавьте количество символов в файл CSS или HTML, измерьте общий размер пакета и время загрузки.
Накладные расходы 33% очевидны; выигрыша в производительности нет. URL-safe Base64 (base64url) имеет такое же соотношение 4/3, только другие символы. Удаление отступов в худшем случае сохраняет два символа. Для больших файлов незначительно. Для токенов JWT (три сегмента base64url, соединенных точками) удаление заполнения является обычным, но экономит очень мало места; реальный размер — это содержимое токена, а не накладные расходы на кодирование. Скорость рендеринга, декодирование изображений и альтернативные форматы, такие как WebP, требуют разных измерений. Более короткая строка Base64 не подразумевает более быстрое рисование, и этот текстовый инструмент не принимает файл изображения. Его надежным вкладом является арифметика текста UTF-8, введенного на панели.
Вывод: запланируйте дополнительную треть — как кодировщик и декодер Base64 дает вам реальную закодированную длину любого текста, чтобы вы могли измерить, а не гадать
Сжатие также кодирует текст аналогичным образом; независимо от того, являются ли последние два символа == или короче строка, практически не имеет значения для вывода gzip. Кодер и декодер Base64 немедленно сообщает как о количестве входных байтов, так и о количестве выходных символов. Для любого кодирования текста можно увидеть точное увеличение размера. Для строк UTF-8 с многобайтовыми символами инструмент показывает, что количество символов (см.) отличается от количества байтов (то, что кодирует Base64).
Строка символов 10 может иметь вид 15 bytes, если содержит акценты и эмодзи, создавая соотношение 20 символов Base64 вместо 4/3 в зависимости от количества символов. Понимание различий проясняет, почему встраивание значков с большим количеством эмодзи обходится дороже, чем ASCII art: не эмодзи стоят дороже, а UTF-8 байт, которые они представляют. Для возможного встроенного значения запишите количество UTF-8 байтов инструмента и количество закодированных символов рядом. Затем включите префикс URI, синтаксис CSS и любую упаковку, необходимую для места назначения. Такое полное измерение более полезно, чем повторение округленного процента без затрат на его формирование.