개발자 도구 · Base64 인코더 및 디코더
Base64는 데이터를 얼마나 더 크게 만드나요? 4/3 오버헤드가 해결되었습니다.
· 작동 방식
베이스64 인코딩 실적
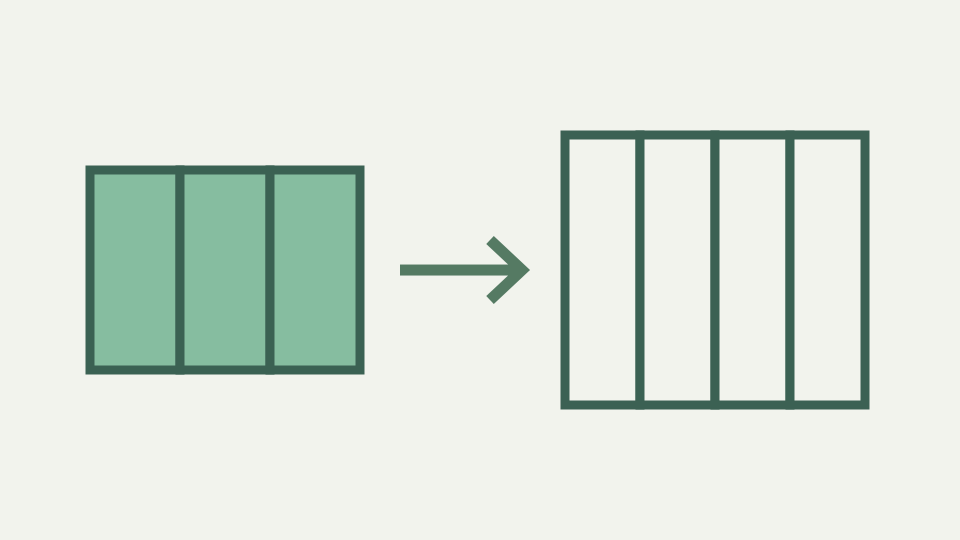
Base64 출력은 입력보다 약 1/3 더 크며 패딩 및 줄 바꿈도 가능합니다. 이번 포스팅에서는 정확한 공식을 도출하고 이를 실제 크기에 적용하여 비용을 판단하실 수 있도록 하겠습니다.
번들에서 40 KB이 된 30 KB 아이콘 — 빌드 검토를 놀라게 한 구체적인 크기 점프
CSS 파일에서 Base64로 인라인된 30 KB 아이콘은 40 KB이 되고 빌드 검토 질문이 발생합니다. 추가 10 KB은 어디서 왔습니까? Base64의 확장 요소는 항상 3바이트 입력마다 4/3:이며 4바이트 출력(4자)을 생성합니다. 30 KB 입력(30,000바이트)의 경우 3로 나누어 10,000 그룹을 얻고, 4를 곱하여 40,000바이트 출력을 얻습니다.
수학은 결정적이며 불가피합니다. Base64는 압축 형식이 아닙니다. 인라인 자산 비용이 33% 더 많은 대역폭을 필요로 하고 HTTP 요청이 하나 더 적기 때문에 페이지 로드 속도가 더 빨라지면 이는 측정할 가치가 있는 절충안입니다. 비용이 33% 더 비싸고 로드 속도가 느리다면 인라인 처리는 가치가 없습니다. 4/3 비율은 비트 레이아웃에서 비롯됩니다. 3바이트는 24비트입니다. 4개의 Base64 문자는 24 비트를 전달합니다(각각 6비트를 전달).
4/3이 기본인 이유 — 문자당 6비트, 바이트당 8비트, 나머지 오버헤드는 어디에서 발생합니까?
지금까지 비율은 1:1입니다. 그러나 Base64 문자는 텍스트(ASCII 0–127)이며 UTF-8 또는 Latin-1 인코딩의 평균 ASCII 문자는 1바이트입니다. 따라서 4개의 Base64 문자는 3바이트 입력에 대한 4바이트 출력입니다. 비율은 4/3.입니다. 이것은 보편적이지 않습니다. Base64가 이진 형식(문자당 1바이트, 6비트로 압축)으로 출력된 경우 비율은 3/4(압축)이 됩니다.
Base64는 텍스트 전송용으로 설계되었기 때문에 텍스트 문자를 사용하며 크기가 33% 증가합니다. 패딩은 끝에 작은 여백을 추가합니다. 입력 길이가 3의 배수이면 패딩이 필요하지 않습니다. 입력 길이가 1 mod 3(다중 1바이트 부족)인 경우 두 개의 패딩 문자가 추가되어 출력이 2만큼 늘어납니다. 2 mod 3인 경우 하나의 패딩 문자 =가 추가되어 1만큼 증가합니다.
패딩이 포함된 정확한 공식 — ceil(n/3) × 4 문자 및 1, 2 및 3 바이트 입력에 대한 효과
큰 입력의 경우 여백은 무시할 수 있습니다. 300바이트 입력에는 400 문자와 최대 2개의 패딩 문자가 필요하며 차이는 0.5% 미만입니다. 작은 입력(1–3바이트)의 경우 패딩이 지배적입니다. 1바이트는 YQ==(4자), 4배 확장을 생성합니다. 그러나 파일 전체의 평균은 큰 파일이 지배합니다. 정확한 공식은 ceil(n / 3) × 4자입니다. 여기서 n은 입력 바이트 수입니다.
n = 1의 경우 ceil(1/3) × 4 = 1 × 4 = 4. n = 2의 경우, ceil(2/3) × 4 = 1 × 4 = 4. n = 3의 경우 ceil(3/3) × 4 = 1 × 4 = 4. n = 4의 경우 ceil(4/3) × 4 = 2 × 4 = 8. n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. 작은 입력 사례 모든 값에 대해 "약 1/3"이 정확하지 않은 이유를 설명하십시오. 2바이트와 마찬가지로 1바이트가 여전히 4자 블록을 차지합니다. 완전한 3바이트 그룹이 최종 패딩된 블록을 지배하는 경우에만 비율이 4/3에 가까워집니다.
작업 예: 20 문자 UTF-8 문자열 측정 — 문자가 아닌 바이트를 계산한 다음 Base64 길이를 계산합니다.
천장 함수는 최종 그룹이 3의 완전 배수가 아닌 것을 설명합니다. n이 커지면 ceil(n/3)은 n/3,에 접근하므로 출력은 (n/3) × 4 = 4n/3, 4/3 비율에 접근합니다.
구체적인 문자열 측정: 20 문자에 ASCII, 악센트 및 이모티콘이 혼합되어 있습니다. JavaScript의 문자 수는 15입니다(이모지는 1개로 계산). UTF-8 바이트 수가 다릅니다: ASCII 문자 각각 1 바이트, 악센트 문자 2 바이트(é의 경우 0xC3 0xA9), 이모티콘 4 바이트(0xF0 0x9F 0x98 0x80). 이 도구는 UTF-16 문자, 유니코드 코드 포인트 및 UTF-8 바이트를 별도로 보고합니다. 이러한 구별은 멀티바이트 기호가 포함된 20자 문장의 가격이 20바이트로 책정되는 것을 방지합니다. 인코딩된 길이는 사람이 화면에서 계산하는 것이 아니라 바이트 수를 따릅니다.
줄 바꿈 및 MIME 줄 바꿈 — 76 열 형식이 몇 퍼센트 더 추가되는지
총계는 약 18바이트입니다. Base64는 다음을 인코딩합니다: ceil(18/3) × 4 = 6 × 4 = 24 문자. 18 3의 배수이므로 패딩이 필요하지 않습니다. Base64 출력은 24 문자입니다. 인코딩은 추가됩니다. 24 - 18 = 6 바이트 또는 33%, 4/3 수식을 확인하면 클래식 MIME이 줄당 76 문자로 줄 바꿈되고 줄바꿈이 추가됩니다.
400 문자 Base64 출력은 개행이 삽입된 약 405 바이트가 됩니다. Base64 출력의 모든 76 문자에 대해 하나의 개행 바이트가 삽입됩니다. 대용량 파일의 경우 2% 미만을 추가합니다. 이메일 첨부 파일의 경우 개행 규칙이 표준이며 파서에서 예상됩니다. 도구는 래핑된 Base64를 허용하고 올바르게 디코딩합니다. 압축 상호 작용은 크기 분석을 복잡하게 만듭니다. 원시 바이너리 데이터(이미지, 비디오)는 Base64 텍스트와 다르게 압축됩니다. ToolAcre는 구성된 각 76 문자 조각 뒤에 줄바꿈을 삽입하고 표시된 인코딩된 문자 측정에서 해당 줄바꿈을 제외합니다. 와이어 형식 예산에는 구분 기호를 다시 추가해야 합니다. 눈에 보이는 측정값만 비교하면 전송된 모든 라인 종료 바이트가 아닌 Base64 기호만 설명됩니다.
압축 상호 작용 — Base64 텍스트가 그것이 나타내는 원시 바이트보다 더 나쁘게 압축되는 경향이 있는 이유
Base64 문자열은 gzip을 사용하여 크기를 60%로 압축할 수 있고 이미지는 25%로 압축할 수 있습니다. gzip은 반복되는 바이트 패턴을 찾기 때문에 텍스트 표현(문자 A–Z + + / 또는 - _)은 이진 데이터가 나타내는 것보다 반복이 적습니다. 압축을 사용하여 이미지를 인라인하면 별도로 포함하는 것보다 코드 비용이 더 많이 드는 경우가 많습니다. 특히 글리프가 많아 복잡한 글꼴의 경우 Base64 인라인 처리가 비효율적일 수 있습니다.
절충 분석은 특정 상황에 따라 다릅니다. 작은 데이터 URI(10–50바이트)를 인라인하는 것은 HTTP 요청을 방지하기 위한 오버헤드가 될 수 있습니다. 인라인 대형 자산(100 KB)은 그렇지 않을 수 있습니다. 압축은 소스와 해당 Base64 표현의 패턴에 따라 달라지므로 보편적인 압축 오버헤드 비율은 부정직합니다. 주변 응답 압축 전후의 실제 자산을 측정합니다. 특정 비용은 블록 공식에 의해 제공되는 압축되지 않은 문자 수입니다.
여기서 다루지 않는 내용 — 렌더링 또는 디코딩 성능 측정 및 WebP와 같은 형식별 최적화
CDN의 자산이 사용자와 가까운 경우 요청을 피하면 이점이 없습니다. 동일한 서버의 자산 및 로드에 추가 왕복이 필요한 경우 인라인 처리가 정당화될 수 있습니다. 측정은 필수적입니다. 공식을 사용하여 인라인 크기를 계산하고, CSS 또는 HTML 파일에 문자 수를 추가하고, 총 번들 크기와 로드 시간을 측정합니다.
33% 오버헤드는 확실합니다. 성능상의 이점은 없습니다. URL-안전한 Base64(base64url)는 동일한 4/3 비율을 가지며 문자만 다릅니다. 패딩을 제거하면 최악의 경우 두 문자가 절약됩니다. 대용량 파일의 경우 무시할 수 있습니다. JWT 토큰(점으로 연결된 3개의 base64url 세그먼트)의 경우 패딩을 제거하는 것이 일반적이지만 공간을 거의 절약하지 못합니다. 실제 크기는 인코딩 오버헤드가 아닌 토큰 콘텐츠입니다. 렌더링 속도, 이미지 디코딩 및 WebP와 같은 대체 형식에는 서로 다른 측정이 필요합니다. Base64 문자열이 짧다고 해서 페인팅이 더 빨라지는 것은 아니며 이 텍스트 전용 도구는 이미지 파일을 허용하지 않습니다. 신뢰할 수 있는 기여는 패널에 입력된 UTF-8 텍스트에 대한 산술입니다.
요약: 1/3의 추가 예산 — Base64 인코더 및 디코더가 텍스트의 실제 인코딩 길이를 제공하여 추측이 아닌 측정이 가능한 방법
압축은 텍스트도 비슷하게 인코딩합니다. 마지막 두 문자가 ==이거나 문자열이 더 짧은지 여부는 gzip 출력에 거의 차이가 없습니다. Base64 인코더 및 디코더는 입력 바이트 수와 출력 문자 수를 모두 즉시 보고합니다. 모든 텍스트 인코딩의 경우 정확한 크기 증가를 볼 수 있습니다. 멀티바이트 문자가 포함된 UTF-8 문자열의 경우 도구는 문자 수(보는 내용)가 바이트 수(Base64가 인코딩하는 내용)와 다르다는 것을 보여줍니다.
10 문자 문자열은 악센트와 이모티콘이 포함된 경우 15바이트가 될 수 있으며 문자 수를 기준으로 4/3 비율 대신 Base64 출력의 20 문자를 생성합니다. 차이점을 이해하면 이모티콘이 많은 아이콘을 인라인하는 것이 ASCII 아트보다 비용이 많이 드는 이유가 명확해집니다. 이모티콘이 아닌 UTF-8 바이트의 비용이 더 많이 듭니다. 후보 인라인 값의 경우 도구의 UTF-8바이트 수와 인코딩된 문자 수를 나란히 기록합니다. 그런 다음 URI 접두사, CSS 구문 및 대상에 필요한 래핑을 포함합니다. 이러한 완전한 측정은 프레임 비용 없이 반올림된 백분율을 반복하는 것보다 더 유용합니다.