Alat pengembang · Encoder & decoder Base64
Seberapa besar Base64 membuat data Anda? Overhead 4/3 berhasil
· Cara kerjanya
base64 pengkodean pertunjukan
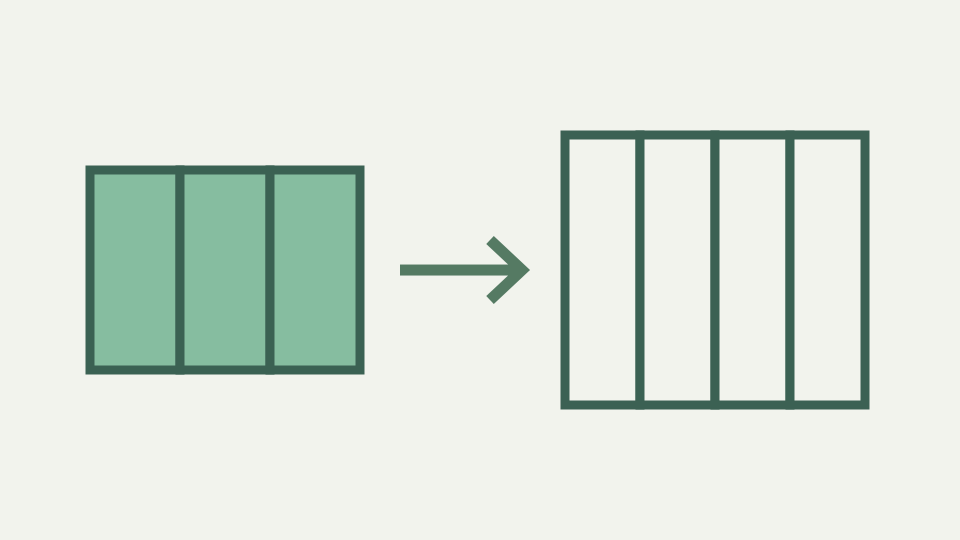
Output Base64 sekitar sepertiga lebih besar dari inputnya, ditambah padding dan mungkin jeda baris. Posting ini mendapatkan formula yang tepat dan menerapkannya pada ukuran realistis sehingga Anda dapat menilai biayanya.
Ikon 30 KB yang menjadi 40 KB dalam paket — lompatan ukuran nyata yang mengejutkan tinjauan pembangunan
Ikon 30 KB yang disisipkan sebagai Base64 di file CSS menjadi 40 KB, dan muncul pertanyaan tinjauan build: dari mana datangnya 10 KB tambahan? Faktor ekspansi untuk Base64 selalu 4/3: setiap input tiga byte menghasilkan output empat byte (empat karakter). Untuk masukan 30 KB (30,000 bytes), bagi dengan tiga untuk mendapatkan 10,000 grup, kalikan dengan empat untuk mendapatkan keluaran 40,000 bytes.
Matematika bersifat deterministik dan tidak dapat dihindari: Base64 bukanlah format kompresi. Jika penyebarisan aset membutuhkan 33% lebih banyak bandwidth dan laman dimuat lebih cepat karena satu permintaan HTTP lebih sedikit, maka hal ini layak untuk diukur. Jika biayanya 33% lebih mahal dan memuat lebih lambat, inlining tidak ada gunanya. Rasio 4/3 berasal dari tata letak bit. Tiga byte adalah 24 bits; empat karakter Base64 membawa 24 bits (masing-masing membawa enam bit).
Mengapa 4/3 adalah lantai — enam bit per karakter versus delapan per byte, dan dari mana sisa overhead berasal
Sejauh ini, rasionya adalah 1:1. Namun karakter Base64 adalah teks (ASCII 0–127), dan rata-rata karakter ASCII dalam pengkodean UTF-8 atau Latin-1 adalah satu byte. Jadi empat karakter Base64 adalah keluaran empat byte untuk masukan tiga byte, rasio 4/3. Ini tidak universal: jika Base64 dikeluarkan sebagai format biner (satu byte per karakter, dikemas menjadi enam bit), rasionya akan menjadi 3/4 (kompresi).
Karena Base64 dirancang untuk pengangkutan teks, ia menggunakan karakter teks, dan biayanya meningkat sebesar 33%. Padding menambahkan margin kecil di bagian akhir. Jika panjang input kelipatan tiga, tidak diperlukan padding. Jika panjang input 1 mod 3 (kurang satu byte), dua karakter padding = ditambahkan, meningkatkan output sebesar 2. Jika 2 mod 3, satu karakter padding = ditambahkan, bertambah 1.
Rumus yang tepat dengan padding — ceil(n/3) × 4 karakter, dan efek untuk input 1, 2 dan 3 bytes
Untuk input besar, margin dapat diabaikan: input 300-byte memerlukan 400 karakter ditambah paling banyak dua karakter padding, selisihnya kurang dari 0.5%. Untuk input kecil (1–3 bytes), padding mendominasi: satu byte menghasilkan YQ== (empat karakter), ekspansi 4x. Namun rata-rata seluruh file didominasi oleh file berukuran besar. Rumus persisnya adalah ceil(n / 3) × 4 karakter, dengan n adalah jumlah byte masukan.
Untuk n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Untuk n = 2, ceil(2/3) × 4 = 1 × 4 = 4. Untuk n = 3, ceil(3/3) × 4 = 1 × 4 = 4. Untuk n = 4, ceil(4/3) × 4 = 2 × 4 = 8. Untuk n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Kasus masukan kecil menjelaskan mengapa “sekitar sepertiga” tidak tepat untuk setiap nilai. Satu byte masih menempati blok empat karakter, begitu pula dua byte. Rasionya mendekati empat pertiga hanya karena jumlah grup tiga byte lengkap mendominasi blok empuk terakhir.
Contoh praktis: mengukur string 20-karakter UTF-8 — menghitung byte daripada karakter, lalu panjang Base64
Fungsi plafon memperhitungkan grup terakhir yang tidak merupakan kelipatan tiga yang lengkap. Saat n bertambah besar, ceil(n/3) mendekati n/3, sehingga keluaran mendekati (n/3) × 4 = 4n/3, rasio 4/3.
Ukur string konkret: 20 karakter campuran ASCII, aksen dan emoji. Jumlah karakter adalah 15 di JavaScript (emoji dihitung satu). UTF-8 jumlah byte berbeda: ASCII masing-masing huruf 1 byte, huruf beraksen 2 bytes (0xC3 0xA9 untuk é), emoji 4 bytes (0xF0 0x9F 0x98 0x80). Alat ini melaporkan UTF-16 karakter, titik kode Unicode, dan UTF-8 byte secara terpisah. Perbedaan tersebut mencegah kalimat dua puluh karakter yang berisi simbol multibyte diberi harga sebagai dua puluh byte. Panjang yang dikodekan mengikuti jumlah byte, bukan jumlah manusia di layar.
Jeda baris dan pembungkusan MIME — bagaimana pemformatan kolom 76 menambahkan beberapa persen lagi
Jumlahnya sekitar 18 bytes. Base64 mengkodekan ini: ceil(18/3) × 4 = 6 × 4 = 24 karakter. Sejak 18 kelipatan tiga, tidak perlu padding. Keluaran Base64 adalah 24 karakter. Pengkodean menambahkan 24 - 18 = 6 bytes, atau 33%, mengonfirmasi 4/3 rumus. MIME Pembungkusan Base64 menimbulkan overhead tambahan. Klasik MIME membungkus di 76 karakter per baris dan menambahkan baris baru.
Output Base64 berkarakter 400 menjadi kira-kira 405 bytes dengan baris baru disisipkan. Untuk setiap 76 karakter keluaran Base64, satu byte baris baru disisipkan. Untuk file besar, penambahan kurang dari 2%. Untuk lampiran email, konvensi baris baru adalah standar dan diharapkan oleh parser; alat menerima Base64 yang dibungkus dan menerjemahkan kode dengan benar. Interaksi kompresi mempersulit analisis ukuran. Data biner mentah (gambar, video) dikompres secara berbeda dari teks Base64. ToolAcre menyisipkan baris baru setelah setiap irisan karakter 76 yang dikonfigurasi dan mengecualikan baris baru tersebut dari pengukuran karakter terkodekan yang ditampilkan. Anggaran format kawat harus menambahkan pemisah kembali; perbandingan pengukuran yang terlihat saja menggambarkan simbol Base64, tidak setiap byte akhir baris yang dikirimkan.
Interaksi kompresi — mengapa teks Base64 cenderung terkompresi lebih buruk daripada byte mentah yang diwakilinya
String Base64 mungkin dikompres menjadi 60% ukurannya dengan gzip, dan gambar mungkin dikompres menjadi 25%. Karena gzip mencari pola byte berulang, representasi teks (huruf A–Z plus + / atau - _) memiliki pengulangan lebih sedikit dibandingkan representasi data biner. Menyejajarkan gambar dengan kompresi sering kali membutuhkan biaya kode yang lebih mahal daripada menyematkannya secara terpisah. Untuk font, terutama yang rumit dengan banyak mesin terbang, inlining Base64 bisa jadi tidak efisien.
Analisis trade-off bergantung pada konteks spesifik. Memasukkan data kecil URI (10–50 bytes) mungkin bernilai overhead untuk menghindari permintaan HTTP. Memasukkan aset besar (100 KB) mungkin tidak. Kompresi bergantung pada pola di sumber dan representasi Base64-nya, sehingga persentase overhead terkompresi yang universal adalah tindakan yang tidak jujur. Ukur aset sebenarnya sebelum dan sesudah kompresi respons sekitarnya. Biaya tertentu adalah jumlah karakter terkompresi yang diberikan oleh rumus blok.
Hal yang tidak tercakup di sini — mengukur kinerja rendering atau dekode, dan pengoptimalan khusus format seperti WebP
Jika aset di CDN dekat dengan pengguna, menghindari permintaan tidak akan menguntungkan. Jika aset di server dan pemuatan yang sama memerlukan perjalanan bolak-balik ekstra, inlining mungkin dapat dibenarkan. Pengukuran itu penting: gunakan rumus untuk menghitung ukuran sebaris, tambahkan jumlah karakter ke file CSS atau HTML, ukur total ukuran paket dan waktu muat.
33% overhead sudah pasti; manfaat kinerja tidak. URL-safe Base64 (base64url) memiliki rasio 4/3 yang sama, hanya karakter yang berbeda. Menghapus padding akan menghemat dua karakter dalam kasus terburuk. Untuk file besar, dapat diabaikan. Untuk token JWT (tiga segmen base64url bergabung dengan titik), menghilangkan padding merupakan hal yang konvensional namun menghemat sedikit ruang; ukuran sebenarnya adalah konten token, bukan overhead pengkodean. Kecepatan rendering, decoding gambar, dan format alternatif seperti WebP memerlukan pengukuran yang berbeda. String Base64 yang lebih pendek tidak berarti pengecatan lebih cepat, dan alat hanya teks ini tidak menerima file gambar. Kontribusinya yang andal adalah aritmatika untuk teks UTF-8 yang dimasukkan ke dalam panel.
Kesimpulan: anggarkan sepertiga ekstra — bagaimana encoder & decoder Base64 memberi Anda panjang teks apa pun yang dikodekan secara sebenarnya sehingga Anda dapat mengukur, bukan menebak-nebak
Kompresi juga mengkodekan teks dengan cara yang sama; apakah dua karakter terakhir == atau string lebih pendek hampir tidak ada perbedaan dalam keluaran gzip. Encoder & decoder Base64 segera melaporkan jumlah byte input dan jumlah karakter output. Untuk pengkodean teks apa pun, dapat melihat peningkatan ukuran yang tepat. Untuk string UTF-8 dengan karakter multi-byte, alat menunjukkan bahwa jumlah karakter (yang dilihat) berbeda dari jumlah byte (yang dikodekan Base64).
String 10 karakter mungkin 15 bytes jika berisi aksen dan emoji, menghasilkan 20 karakter keluaran Base64, bukan rasio 4/3 berdasarkan jumlah karakter. Memahami perbedaan memperjelas mengapa ikon berisi emoji sebaris lebih mahal daripada ASCII karya seni: bukan emoji yang harganya lebih mahal, UTF-8 byte yang diwakilinya. Untuk calon nilai sebaris, catat jumlah UTF-8-byte alat dan jumlah karakter yang dikodekan secara berdampingan. Kemudian sertakan awalan URI, sintaksis CSS dan pembungkus apa pun yang diperlukan oleh tujuan. Pengukuran lengkap tersebut lebih berguna daripada mengulangi persentase yang dibulatkan tanpa biaya penyusunannya.