Công cụ dành cho nhà phát triển · Bộ mã hóa và giải mã Base64
Base64 làm cho dữ liệu của bạn lớn hơn bao nhiêu? các 4/3 chi phí đã được giải quyết
· Cách thức hoạt động
base64 mã hóa hiệu suất
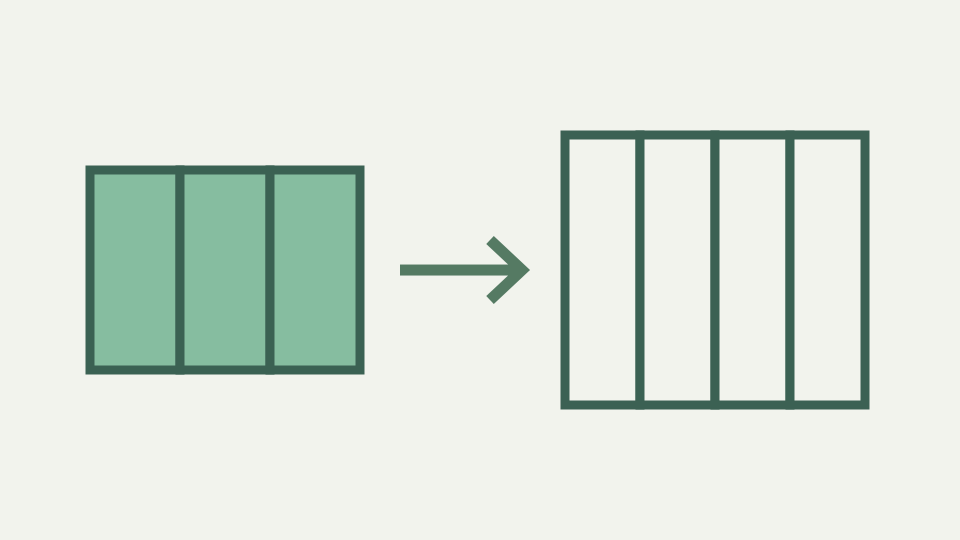
Đầu ra Base64 lớn hơn khoảng một phần ba so với đầu vào của nó, cộng với phần đệm và có thể ngắt dòng. Bài đăng này rút ra công thức chính xác và áp dụng nó cho các kích thước thực tế để bạn có thể đánh giá chi phí.
Biểu tượng 30 KB đã trở thành 40 KB trong gói — một bước nhảy vọt về kích thước cụ thể khiến người đánh giá bản dựng ngạc nhiên
MỘT 30 KB biểu tượng được nội tuyến là Base64 trong CSS tệp trở thành 40 KBvà câu hỏi đánh giá bản dựng được đặt ra: bổ sung ở đâu 10 KB đến từ đâu? Hệ số mở rộng cho Base64 luôn là 4/3: cứ ba byte đầu vào tạo ra bốn byte đầu ra (bốn ký tự). Vì 30 KB đầu vào (30,000 bytes), chia cho ba để có được 10,000 nhóm, nhân với 4 để có được 40,000 bytes đầu ra.
Toán học mang tính quyết định và không thể tránh khỏi: Base64 không phải là định dạng nén. Nếu nội dung nội tuyến tiêu tốn băng thông nhiều hơn 33% và tải trang nhanh hơn vì có ít HTTP yêu cầu hơn thì đó là sự đánh đổi đáng để đo lường. Nếu chi phí tăng thêm 33% và tải chậm hơn thì nội tuyến sẽ không có giá trị. Tỷ lệ 4/3 xuất phát từ bố cục bit. Ba byte là 24 bits; bốn ký tự Base64 mang 24 bits (mỗi ký tự mang sáu bit).
Tại sao 4/3 là mức sàn — sáu bit trên mỗi ký tự so với tám bit trên mỗi byte và chi phí còn lại đến từ đâu
Cho đến nay, tỷ lệ là 1:1. Nhưng các ký tự Base64 là văn bản (ASCII 0–127) và ký tự ASCII trung bình trong mã hóa UTF-8 hoặc Latin-1 là một byte. Vì vậy, bốn ký tự Base64 là đầu ra bốn byte cho đầu vào ba byte, tỷ lệ 4/3. Điều này không phổ biến: nếu Base64 được xuất ra dưới dạng định dạng nhị phân (một byte cho mỗi ký tự, được đóng gói thành sáu bit), tỷ lệ sẽ là 3_/4 (nén).
Vì Base64 được thiết kế để truyền tải văn bản nên nó sử dụng các ký tự văn bản và chi phí tăng kích thước 33%. Phần đệm thêm lề nhỏ ở cuối. Nếu độ dài đầu vào là bội số của ba thì không cần đệm. Nếu độ dài đầu vào 1 mod 3 (thiếu một byte của bội số), hai ký tự đệm = được thêm vào, tăng đầu ra thêm 2. Nếu 2 mod 3, một ký tự đệm = được thêm vào, tăng thêm 1.
Công thức chính xác có phần đệm — ceil(n/3) × 4 ký tự và hiệu ứng cho đầu vào của 1, 2 và 3 bytes
Đối với đầu vào lớn, lề không đáng kể: đầu vào 300 byte cần 400 ký tự cộng với tối đa hai ký tự đệm, chênh lệch nhỏ hơn 0.5%. Đối với các đầu vào nhỏ (1–3 bytes), phần đệm chiếm ưu thế: một byte tạo ra YQ== (bốn ký tự), mở rộng gấp 4 lần. Nhưng mức trung bình trên các tệp bị chi phối bởi những tệp lớn. Công thức chính xác là ceil(n / 3) × 4 ký tự, trong đó n là số byte đầu vào.
Với n = 1, ceil(1/3) × 4 = 1 × 4 = 4. Với n = 2, ceil(2/3) × 4 = 1 × 4 = 4. Với n = 3, ceil(3/3) × 4 = 1 × 4 = 4. Với n = 4, ceil(4/3) × 4 = 2 × 4 = 8. Với n = 30000, ceil(30000/3) × 4 = 10000 × 4 = 40000. Các trường hợp đầu vào nhỏ giải thích tại sao “khoảng một phần ba” không chính xác cho mọi giá trị. Một byte vẫn chiếm một khối bốn ký tự, cũng như hai byte. Tỷ lệ chỉ đạt đến bốn phần ba khi nhiều byte hoàn chỉnh nhóm ba byte thống trị khối đệm cuối cùng.
Ví dụ đã thực hiện: đo chuỗi 20 ký tự UTF-8 - đếm byte thay vì ký tự, sau đó là độ dài Base64
Hàm trần chiếm nhóm cuối cùng không phải là bội số đầy đủ của ba. Khi n lớn lên, ceil(n/3) tiến đến n/3, nên đầu ra tiến đến (n/3) × 4 = 4n/3, tỷ lệ 4/3.
Đo chuỗi cụ thể: 20 ký tự được kết hợp ASCII, dấu trọng âm và biểu tượng cảm xúc. Số ký tự là 15 trong JavaScript (biểu tượng cảm xúc được tính một). UTF-8 số byte khác nhau: ASCII chữ cái 1 byte mỗi chữ cái, chữ cái có dấu 2 bytes (0xC3 0xA9 cho é), biểu tượng cảm xúc 4 bytes (0xF0 0x9F 0x98 0x80). Công cụ này báo cáo UTF-16 ký tự, điểm mã Unicode và UTF-8 byte riêng biệt. Sự khác biệt đó ngăn không cho một câu hai mươi ký tự chứa các ký hiệu nhiều byte bị định giá là hai mươi byte. Độ dài được mã hóa tuân theo số byte chứ không phải số lượng con người đếm trên màn hình.
Ngắt dòng và ngắt dòng MIME — cách định dạng cột 76 tăng thêm vài phần trăm
Tổng cộng khoảng 18 bytes. Base64 mã hóa những thứ sau: ceil(18/3) × 4 = 6 × 4 = 24 ký tự. Vì 18 bội số của ba nên không cần đệm. Đầu ra Base64 là 24 ký tự. Mã hóa thêm 24 - 18 = 6 bytes hoặc 33%, xác nhận 4/3 công thức MIME Gói Base64 giới thiệu chi phí bổ sung MIME cổ điển ở 76 ký tự trên mỗi dòng và thêm dòng mới.
Đầu ra Base64 gồm 400 ký tự trở thành xấp xỉ 405 bytes khi chèn dòng mới. Đối với mỗi 76 ký tự của đầu ra Base64, một byte dòng mới sẽ được chèn vào. Đối với các tệp lớn, hãy thêm ít hơn 2%. Đối với các tệp đính kèm email, quy ước dòng mới là tiêu chuẩn và được các trình phân tích cú pháp mong đợi; công cụ chấp nhận Base64 được bọc và giải mã chính xác. Tương tác nén làm phức tạp việc phân tích kích thước. Dữ liệu nhị phân thô (hình ảnh, video) nén khác với văn bản Base64. ToolAcre chèn một dòng mới sau mỗi lát ký tự 76 được định cấu hình và loại trừ các dòng mới đó khỏi phép đo ký tự được mã hóa được hiển thị của nó. Ngân sách định dạng dây phải thêm lại các dấu phân cách; chỉ so sánh phép đo hiển thị mô tả các ký hiệu Base64, không phải mọi byte kết thúc dòng được truyền.
Tương tác nén - tại sao văn bản Base64 có xu hướng nén kém hơn byte thô mà nó đại diện
Chuỗi Base64 có thể nén tới 60% kích thước của nó bằng gzip và hình ảnh có thể nén thành 25%. Vì gzip tìm kiếm các mẫu byte lặp lại nên cách biểu diễn văn bản (các chữ cái A–Z cộng + / hoặc - _) có ít sự lặp lại hơn so với biểu diễn dữ liệu nhị phân. Hình ảnh nội tuyến có nén thường tốn nhiều mã hơn so với việc nhúng riêng lẻ. Đối với các phông chữ, đặc biệt phức tạp với nhiều glyph, nội tuyến Base64 có thể không hiệu quả.
Phân tích đánh đổi phụ thuộc vào bối cảnh cụ thể. Nội tuyến dữ liệu nhỏ URI (10–50 bytes) có thể tốn phí để tránh yêu cầu HTTP. Nội tuyến nội dung lớn (100 KB) có thể không. Việc nén phụ thuộc vào các mẫu trong cả nguồn và cách biểu diễn Base64 của nó, do đó tỷ lệ phần trăm chi phí nén chung sẽ không trung thực. Đo lường tài sản thực tế trước và sau khi nén phản hồi xung quanh. Chi phí nhất định là số ký tự không nén được đưa ra bởi công thức khối.
Điều này không bao gồm những gì — đo lường hiệu suất hiển thị hoặc giải mã cũng như các tối ưu hóa dành riêng cho định dạng, chẳng hạn như WebP
Nếu nội dung trên CDN gần với người dùng, việc tránh yêu cầu sẽ không mang lại lợi ích. Nếu nội dung trên cùng một máy chủ và việc tải yêu cầu thêm chuyến đi khứ hồi, thì nội tuyến có thể hợp lý. Việc đo lường là điều cần thiết: sử dụng công thức để tính toán kích thước nội tuyến, thêm số ký tự vào tệp CSS hoặc HTML, đo tổng kích thước gói và thời gian tải.
33% chi phí là chắc chắn; lợi ích hiệu suất là không. URL-safe Base64 (base64url) có cùng tỷ lệ 4/3, chỉ khác các ký tự. Loại bỏ phần đệm sẽ lưu hai ký tự trong trường hợp xấu nhất. Đối với các tệp lớn, không đáng kể. Đối với mã thông báo JWT (ba phân đoạn base64url được nối với nhau), việc loại bỏ phần đệm là thông thường nhưng tiết kiệm rất ít không gian; kích thước thực là nội dung mã thông báo, không phải chi phí mã hóa. Tốc độ hiển thị, giải mã hình ảnh và các định dạng thay thế như WebP yêu cầu các phép đo khác nhau. Chuỗi Base64 ngắn hơn không có nghĩa là vẽ nhanh hơn và công cụ chỉ có văn bản này không chấp nhận tệp hình ảnh. Đóng góp đáng tin cậy của nó là phép tính số học cho văn bản UTF-8 được nhập vào bảng điều khiển.
Bài học rút ra: dành thêm một phần ba — cách bộ mã hóa & giải mã Base64 cung cấp cho bạn độ dài được mã hóa thực sự của bất kỳ văn bản nào để bạn có thể đo thay vì đoán
Nén cũng mã hóa văn bản tương tự; cho dù hai ký tự cuối cùng là == hay chuỗi ngắn hơn thì hầu như không có sự khác biệt nào trong đầu ra gzip. Bộ mã hóa và giải mã Base64 báo cáo ngay lập tức cả số byte đầu vào và số ký tự đầu ra. Đối với bất kỳ mã hóa văn bản nào, có thể thấy kích thước tăng chính xác. Đối với các chuỗi UTF-8 có ký tự nhiều byte, công cụ sẽ hiển thị rằng số lượng ký tự (những gì nhìn thấy) khác với số lượng byte (những gì Base64 mã hóa).
Chuỗi 10 ký tự có thể là 15 bytes nếu chứa dấu trọng âm và biểu tượng cảm xúc, tạo ra 20 ký tự của đầu ra Base64 thay vì tỷ lệ 4/3 dựa trên số lượng ký tự. Hiểu được sự khác biệt sẽ làm rõ lý do tại sao việc đặt nội tuyến biểu tượng nhiều biểu tượng cảm xúc lại đắt hơn ASCII nghệ thuật: không phải biểu tượng cảm xúc lại có giá cao hơn, UTF-8 byte mà chúng đại diện. Đối với giá trị nội tuyến đề xuất, hãy ghi lại số byte UTF-8 và số ký tự được mã hóa của công cụ cạnh nhau. Sau đó, hãy bao gồm tiền tố URI, cú pháp CSS và bất kỳ cách gói nào mà đích đến yêu cầu. Phép đo hoàn chỉnh đó hữu ích hơn việc lặp lại tỷ lệ phần trăm được làm tròn mà không tốn chi phí đóng khung.