開発者ツール · Base64 エンコーダーおよびデコーダー
Base64 によりデータはどのくらい大きくなりますか? 4/3 オーバーヘッドが解決されました
· 仕組み
base64 エンコード パフォーマンス
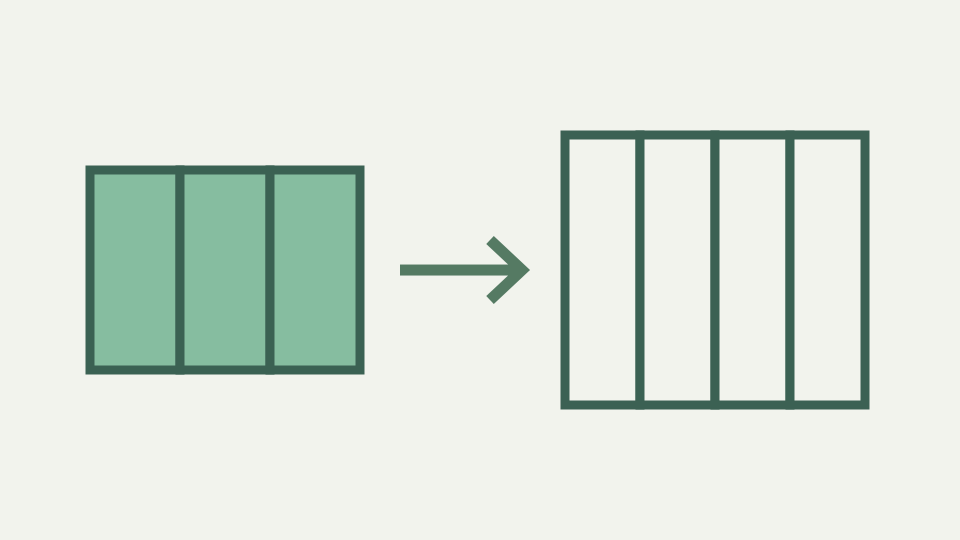
Base64 出力は入力よりも約 3 分の 1 大きく、さらにパディングと場合によっては改行が追加されます。この投稿では正確な計算式を導き出し、それを実際のサイズに適用してコストを判断できるようにします。
バンドル内で 40 KB になった 30 KB アイコン - ビルド レビューを驚かせた具体的なサイズのジャンプ
CSS ファイル内で Base64 としてインライン化された 30 KB アイコンは 40 KB になり、ビルド レビューで疑問が生じます: 余分な 10 KB はどこから来たのか? Base64 の拡張係数は常に 4/3: で、3 バイトの入力ごとに 4 バイトの出力 (4 文字) が生成されます。 30 KB 入力 (30,000 バイト) の場合、3 で除算して 10,000 グループを取得し、4 を乗算して 40,000 バイトの出力を取得します。
数学は決定論的であり、避けられません。Base64 は圧縮形式ではありません。アセットのインライン化にかかる帯域幅が 33% 増加し、HTTP リクエストが 1 つ減ってページの読み込みが速くなった場合、これは測定する価値のあるトレードオフです。コストが 33% 高く、読み込みが遅い場合は、インライン化する価値はありません。 4/3 比率はビット レイアウトから得られます。 3 バイトは 24 ビットです。 4 つの Base64 文字は 24 ビットを運びます (それぞれが 6 ビットを運びます)。
4/3 が下限である理由 — バイトあたり 8 ビットに対して 1 文字あたり 6 ビット、および残りのオーバーヘッドはどこから来るのか
これまでの比率は 1:1 です。ただし、Base64 文字はテキスト (ASCII 0 ~ 127) であり、UTF-8 または Latin-1 エンコードの平均的な ASCII 文字は 1 バイトです。したがって、4 つの Base64 文字は 3 バイトの入力に対して 4 バイトの出力となり、4/3. の比率になります。これは普遍的ではありません。Base64 がバイナリ形式 (1 文字あたり 1 バイト、6 ビットにパックされる) として出力された場合、比率は 3/4 (圧縮) になります。
Base64 はテキスト転送用に設計されているため、テキスト文字を使用し、コストは 33% サイズ増加になります。パディングにより最後に小さなマージンが追加されます。長さを 3 の倍数で入力した場合、パディングは必要ありません。入力長 1 mod 3 (倍数より 1 バイト足りない) の場合、2 つのパディング文字 = 追加され、出力は 2 だけ増加します。 2 mod 3 の場合、パディング文字が 1 つ追加され、1 ずつ増加します。
パディングを含む正確な式 — ceil(n/3) × 4 文字、および 1、2、3 バイトの入力に対する効果
大きな入力の場合、マージンは無視できます。300 バイトの入力には、400 文字と最大 2 つのパディング文字が必要で、差は 0.5% 未満です。小さな入力 (1–3 バイト) の場合、パディングが優先されます。1 バイトは YQ== (4 文字)、4 倍の拡張を生成します。ただし、ファイル全体の平均は、大きなファイルによって支配されます。正確な式は ceil(n / 3) × 4 文字です。ここで、n は入力バイト数です。
n = 1 の場合、ceil(1/3) × 4 = 1 × 4 = 4。n = 2 の場合、 ceil(2/3) × 4 = 1 × 4 = 4。n = 3 の場合、ceil(3/3) × 4 = 1 × 4 = 4。n = 4 の場合、ceil(4/3) × 4 = 2 × 4 = 8。n = 30000 の場合、ceil(30000/3) × 4 = 10000 × 4 = 40000。入力が少ない場合すべての値について「約 3 分の 1」が正確ではない理由を説明します。2 バイトと同様に、1 バイトが 4 文字のブロックを占有するのは、完全な 3 バイトのグループが最終的な埋め込みブロックを占める場合のみです。
実用的な例: 20 文字の UTF-8 文字列の測定 — 文字ではなくバイト数をカウントし、Base64 の長さを計測する
天井関数は、最終グループが完全な 3 の倍数ではないことを考慮しています。 n が大きくなるにつれて、ceil(n/3) は n/3, に近づくため、出力は (n/3) × 4 = 4n/3,、4/3 の比率) に近づきます。
具体的な文字列を測定します: 20 文字、ASCII、アクセント、絵文字が混在しています。 JavaScript では文字数は 15 です (絵文字は 1 つとカウントされます)。 UTF-8 バイト数は異なります: ASCII 文字 1 バイト、アクセント付き文字 2 バイト (é は 0xC3 0xA9)、絵文字 4 バイト (0xF0 0x9F 0x98 0x80)。このツールは、UTF-16 文字、Unicode コード ポイント、および UTF-8 バイトを個別に報告します。この区別により、マルチバイト記号を含む 20 文字の文が 20 バイトとして価格設定されることがなくなります。エンコードされた長さは、人間が画面上でカウントするものではなく、バイト数に従います。
改行と MIME ラッピング — 76 列の書式設定によりさらに数パーセントが追加される仕組み
合計約 18 バイト。 Base64 はこれらをエンコードします: ceil(18/3) × 4 = 6 × 4 = 24 文字。18 は 3 の倍数であるため、パディングは必要ありません。Base64 出力は 24 文字です。エンコーディングは追加します。 24 - 18 = 6 バイト、または 33%、4/3 式を確認すると、1 行あたり 76 文字で追加のオーバーヘッドが発生し、改行が追加されます。
400 文字の Base64 出力は、改行が挿入されると約 405 バイトになります。 Base64 出力の 76 文字ごとに、1 つの改行バイトが挿入されます。大きなファイルの場合、追加されるのは 2% 未満です。電子メールの添付ファイルの場合、改行規則は標準であり、パーサーによって予期されています。ツールはラップされた Base64 を受け入れ、正しくデコードします。圧縮の相互作用によりサイズ分析が複雑になります。生のバイナリ データ (画像、ビデオ) は、Base64 テキストとは異なる方法で圧縮されます。 ToolAcre は、構成された各 76 文字スライスの後に改行を挿入し、表示されるエンコード文字の測定からそれらの改行を除外します。ワイヤー形式の予算では区切り文字を追加し直す必要があります。目に見える測定値のみの比較では、送信されたすべての行末バイトではなく、Base64 シンボルが説明されます。
圧縮の相互作用 — Base64 テキストが、それが表す生のバイトよりも圧縮率が悪くなる理由
Base64 文字列は gzip を使用するとそのサイズの 60% に圧縮され、イメージは 25% に圧縮される可能性があります。 gzip は繰り返されるバイト パターンを検索するため、テキスト表現 (文字 A ~ Z と + / または - _) はバイナリ データよりも繰り返しが少なくなります。圧縮を使用して画像をインライン化すると、多くの場合、個別に埋め込むよりもコードのコストが高くなります。特に多くのグリフを含む複雑なフォントの場合、Base64 インライン化は非効率的になる可能性があります。
トレードオフ分析は特定のコンテキストに依存します。小さなデータ URI (10 ~ 50 バイト) をインライン化すると、HTTP リクエストを回避するためにオーバーヘッドが発生する可能性があります。大きなアセット (100 KB) をインライン化できない場合があります。圧縮はソースとその Base64 表現の両方のパターンに依存するため、普遍的な圧縮オーバーヘッドの割合は不誠実になります。周囲の応答圧縮の前後で実際の資産を測定します。一定のコストは、ブロック式によって与えられる非圧縮文字数です。
これでカバーされないもの — レンダリングまたはデコードのパフォーマンスの測定、および WebP などの形式固有の最適化
CDN 上のアセットがユーザーに近い場合、リクエストを回避してもメリットはありません。同じサーバー上にアセットがあり、読み込みに追加のラウンドトリップが必要な場合は、インライン化が正当化される可能性があります。測定は不可欠です。式を使用してインライン サイズを計算し、CSS または HTML ファイルに文字数を追加し、合計バンドル サイズと読み込み時間を測定します。
33% のオーバーヘッドは確実です。パフォーマンス上の利点はありません。 URL-safe Base64 (base64url) の 4/3 比率は同じですが、文字が異なるだけです。パディングを削除すると、最悪の場合でも 2 文字が節約されます。大きなファイルの場合は無視できます。 JWT トークン (ドットを結合した 3 つの Base64url セグメント) の場合、パディングを削除するのは従来通りですが、節約できるスペースはほとんどありません。実際のサイズはトークンの内容であり、エンコードのオーバーヘッドではありません。レンダリング速度、画像のデコード、WebP などの代替形式では、異なる測定が必要です。 Base64 文字列が短くてもペイントが高速になるわけではありません。また、このテキスト専用ツールは画像ファイルを受け入れません。その信頼できる貢献は、パネルに入力された UTF-8 テキストの演算です。
要点: 予算を 3 分の 1 追加する — Base64 エンコーダーとデコーダーがテキストの実際のエンコードされた長さを提供し、推測ではなく測定できるようにする方法
圧縮ではテキストも同様にエンコードされます。最後の 2 文字が == であっても、文字列が短くても、gzip 出力にはほとんど違いがありません。 Base64 エンコーダとデコーダは、入力バイト数と出力文字数の両方を即座に報告します。どのテキスト エンコードでも、正確なサイズの増加が確認できます。マルチバイト文字を含む UTF-8 文字列の場合、ツールは文字数 (表示内容) がバイト数 (Base64 エンコード内容) と異なることを示します。
10 文字列は、アクセントや絵文字が含まれている場合は 15 バイトになる可能性があり、文字数に基づいて 4/3 の比率ではなく、Base64 出力の 20 文字が生成されます。違いを理解すると、絵文字を多用したアイコンのインライン化が ASCII アートよりもコストがかかる理由が明確になります。絵文字の方がコストがかかるのではなく、絵文字が表す UTF-8 バイトのコストがかかるからです。候補のインライン値については、ツールの UTF-8 バイト数とエンコードされた文字数を並べて記録します。次に、URI プレフィックス、CSS 構文、宛先で必要なラッピングを含めます。この完全な測定は、フレームコストを考慮せずに四捨五入されたパーセンテージを繰り返すよりも有益です。